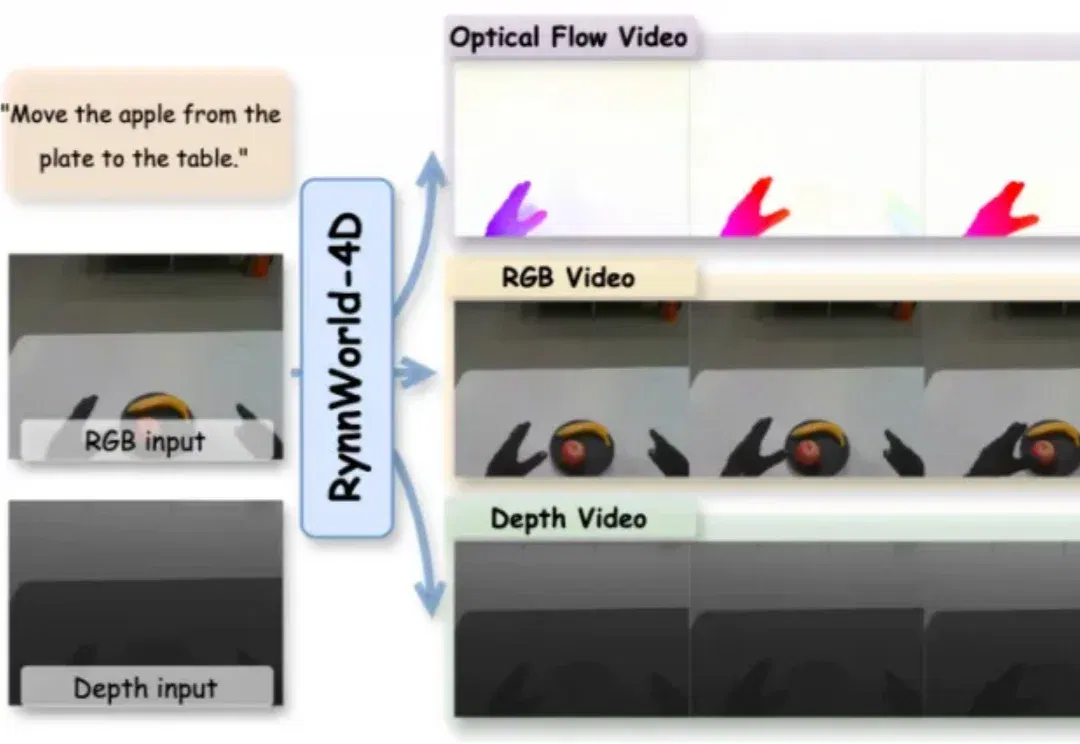
机器人需要「看到三维未来」!RynnWorld-4D重塑4D具身世界模型 (opens in a new tab)
近两年,视频生成模型在具身智能领域受到持续关注。从 UniPi、SuSIE 到各类 action-conditioned video generation 变体,其核心思路一致:先由模型生成一段未来视频,再从中提取动作信号供机器人执行。
Total 76 articles
近两年,视频生成模型在具身智能领域受到持续关注。从 UniPi、SuSIE 到各类 action-conditioned video generation 变体,其核心思路一致:先由模型生成一段未来视频,再从中提取动作信号供机器人执行。
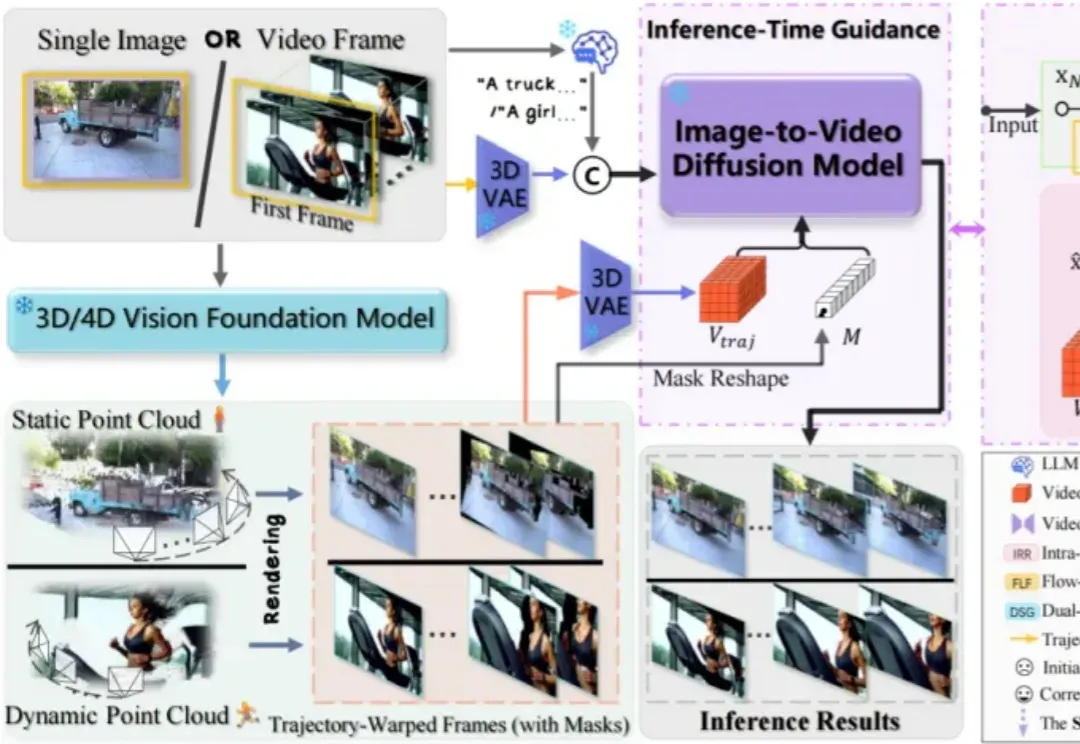
近来,由AI生成的视频片段以前所未有的视觉冲击力席卷了整个互联网,视频生成模型创造出了许多令人惊叹的、几乎与现实无异的动态画面。
阿里千问创作平台上线 Wan 3.0 视频生成模型及 Agent Teams 多智能体协作模式,用户输入剧本与一句话提示词即可由编剧、导演、美术、分镜师、配乐师等 Agent 自动接力完成影视短剧制作,文章以"华强买瓜"剧本配合《JoJo的奇妙冒险》风格进行实测,展示了从需求拆解、角色资产生成、镜头提示词确认到视频拼接与片段迭代修改的完整流程。
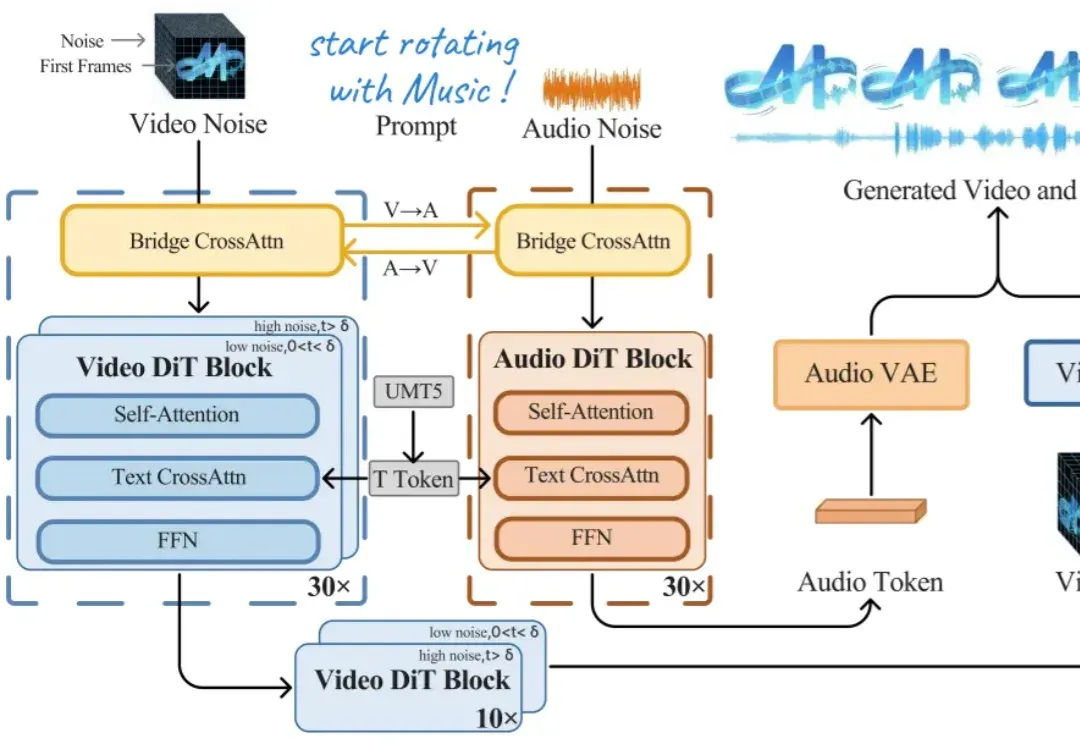
今天上午,上海创智学院 OpenMOSS 团队联合初创公司模思智能(MOSI),正式发布了端到端音视频生成模型 —— MOVA(MOSS-Video-and-Audio)。
自 Sora 2 发布以来,各大科技厂商迎来新一轮视频生成模型「军备竞赛」,纷纷赶在年底前推出更强的迭代版本。
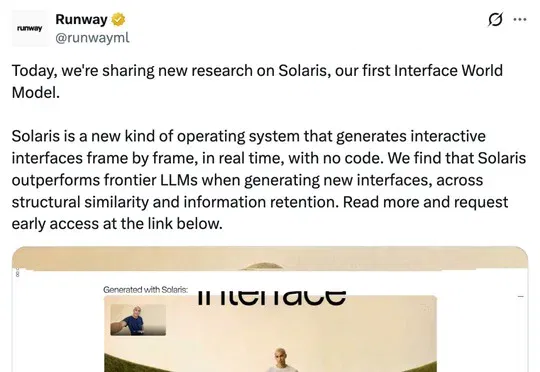
Runway发布首个界面世界模型Solaris,基于Gen-4.5视频生成模型与GWM-1世界模型技术,用户通过点击、拖拽或输入文本即可实时生成交互界面而无需编写代码,该系统还可用于训练Computer Use Agent。
世界模型火,火到都有点乱了。 单单一个定义,就越来越众说纷纭:视频生成模型可以是世界模型,能生成游戏的语言模型也被叫世界模型,还有人把物理引擎也塞进这个筐里…… 乱,乱得李飞飞本人都有点看不下去了。刚刚,她亲自撰文,给世界模型来了个清晰的功能分类。 用词毫不客气:世界模型是当今人工智能领域最重要也最被滥用的术语之一。 古希腊人无法就世界的构成达成共识,因为“世界”从来不是一个单一的实体。人工智能也继承了同样的问题,而此时,这个领域恰恰最需要的就是精准性。 至少,要先分清三件事: 渲染、模拟、规划。 话不多说,赶紧一起来做笔记。 世界模型的三大功能 李飞飞首先拆析了世界模型的技术意义。 智能体(
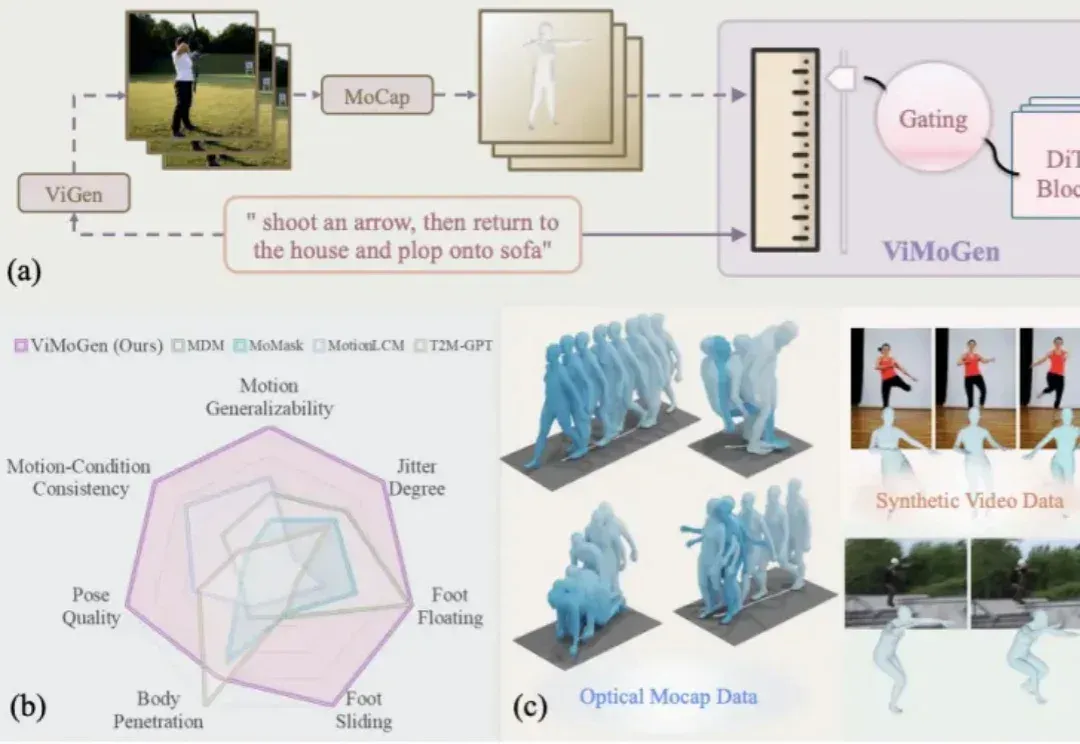
随着 AIGC(Artificial Intelligence Generated Content) 的爆发,我们已经习惯了像 Sora 或 Wan 这样的视频生成模型能够理解「一只宇航员在火星后空翻」这样天马行空的指令。然而,3D 人体动作生成(3D MoGen)领域却稍显滞后。
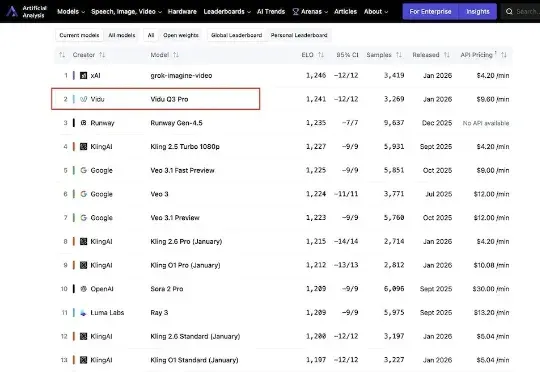
今日,来自生数科技的AI视频模型Vidu Q3 Pro登上国际权威AI基准平台Artificial Analysis榜单,位列中国第一,全球第二。这是最新榜单内,首个打入国际第一梯队的国产视频生成模型。
据 The Informaton 报道,字节跳动已经暂缓了视频生成模型 Seedance 2.0 的全球发布计划。背后的导火索,是一连串来自好莱坞头部片厂和流媒体平台的版权争议。