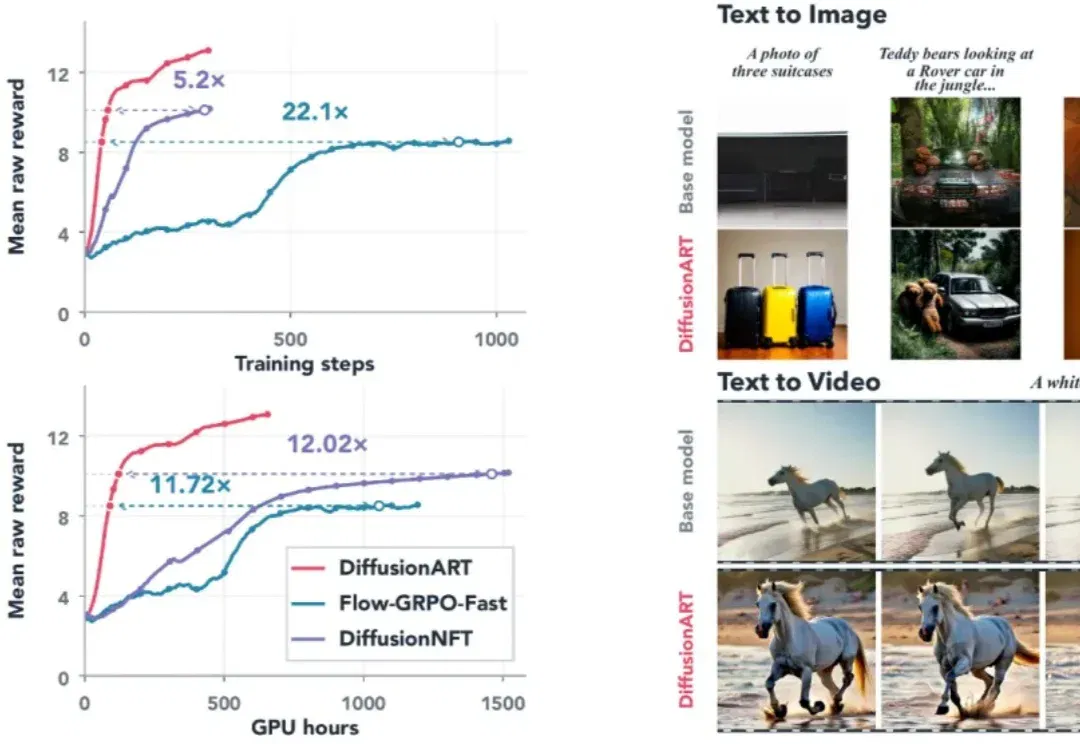
DiffusionART 从梯度机制入手,改善图像与视频扩散模型后训练效率 (opens in a new tab)
DiffusionART 先聚合奖励方向,再用两次更新和信赖域限制处理策略漂移,支持确定性采样与不可微奖励。团队在多种图像、视频模型上报告效率与稳定性收益;十倍以上加速指特定视频实验达到指定奖励水平的对照,并非所有训练任务都等幅提速。
Total 109 articles
DiffusionART 先聚合奖励方向,再用两次更新和信赖域限制处理策略漂移,支持确定性采样与不可微奖励。团队在多种图像、视频模型上报告效率与稳定性收益;十倍以上加速指特定视频实验达到指定奖励水平的对照,并非所有训练任务都等幅提速。
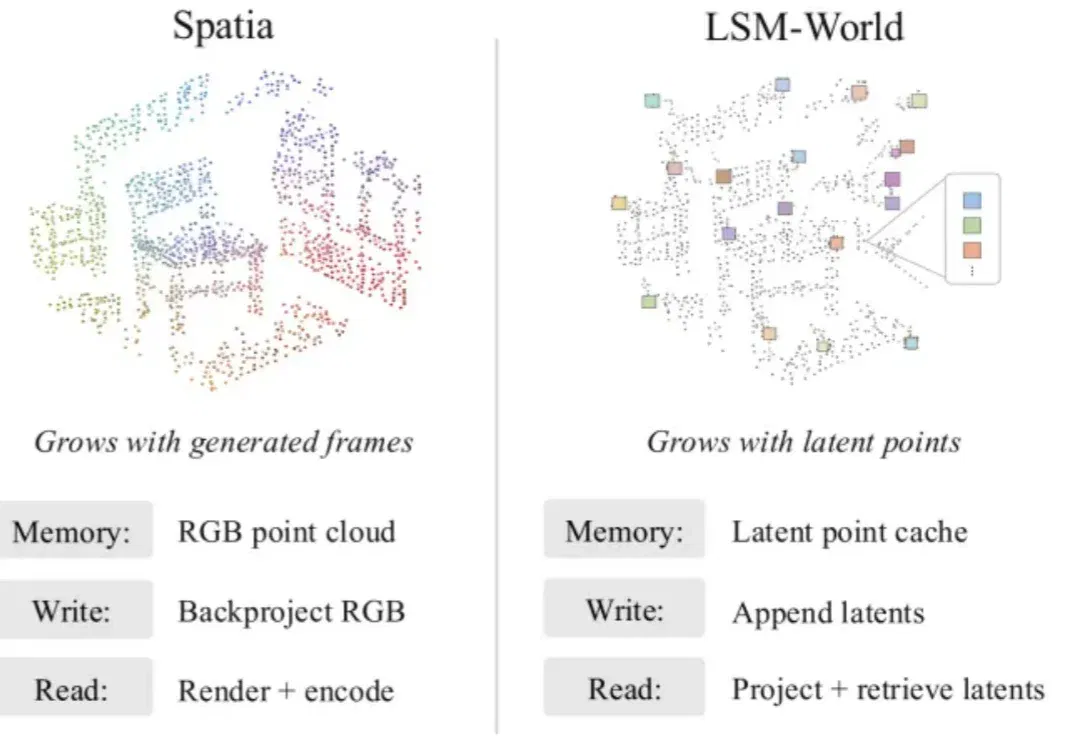
让视频生成模型沿着相机轨迹不断探索一个场景,并不算最难。真正困难的是:当镜头绕了一圈再次回到原点,房间的布局、家具的位置和墙面的纹理,是否还与最初一样?

一周之内大语言、图片、视频模型都迎来新赛季:OpenAI的GPT-6 Astra让编码 Agent更好地使用游戏引擎和Blender,自己改场景、自己跑、自己测;GPT-image-2.5上线,更快更强,图片编辑和关键帧动画显著提升;fal和Yoroll分别发布 H3 MaxTurbo和H3 Superfast后训练加速模型,5秒视频3秒内推理,实时生成和互动玩法纷纷涌现。
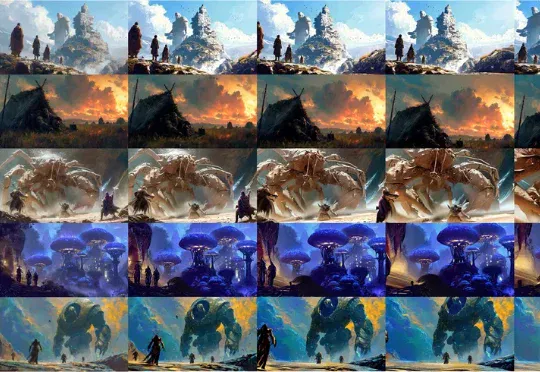
香港大学、香港科技大学与腾讯 ARC Lab 联合提出 SCoPE(Sightline-Coordinate Positional Encoding),一套面向视频 DiT 的射线空间位置编码:让视频模型处理位置关系的基底从张量网格转向射线空间。
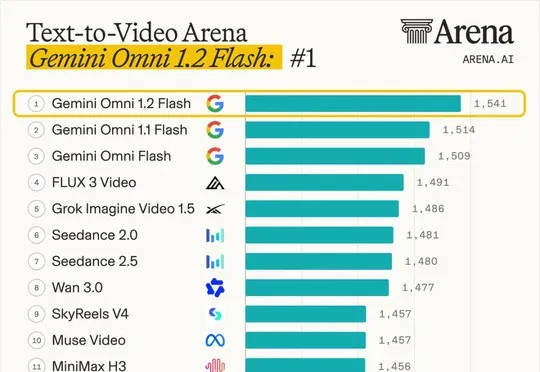
谷歌新版视频模型支持 3 到 15 秒的视频生成和对话编辑。原文记录发布时的 Arena 排名,720p 报价为每秒 0.07 美元。
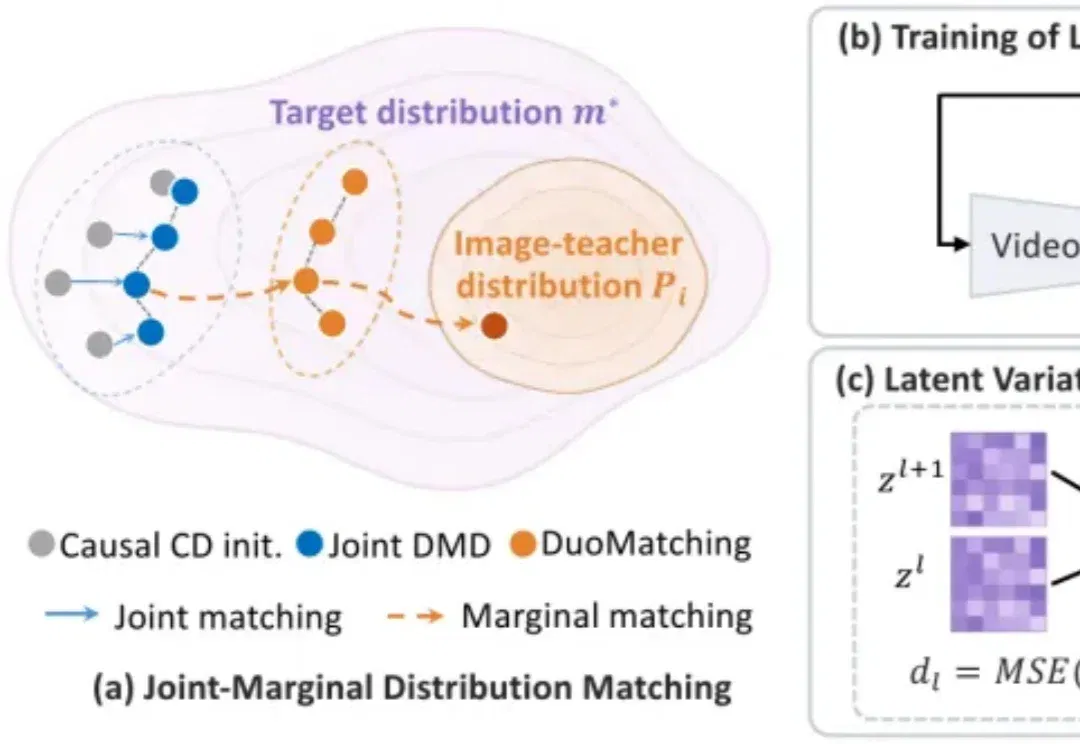
在视频生成领域,少步视频模型已经实现只需少量采样步骤,就能生成连续画面。

前OpenAI Sora负责人比尔·皮布尔斯(Bill Peebles)与DreamWorks联合创始人杰弗里·卡岑伯格(Jeffrey Katzenberg)及Dropbox前CFO苏杰伊·贾斯瓦(Sujay Jaswa)共同创办AI视频创业公司,将自主训练视频模型,并与Andreessen Horowitz等投资人洽谈融资。
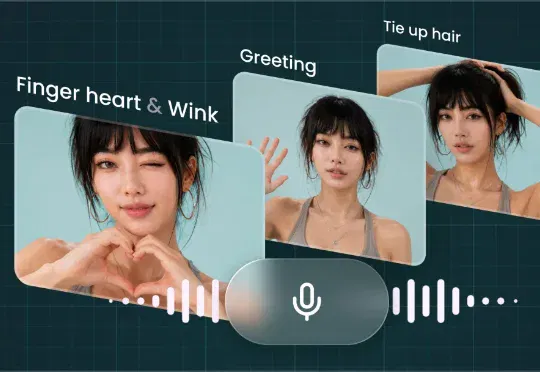
Vidu S1 面向的是一类全新的使用场景:让视频模型从离线成片,走向可对话、可响应、可持续在线的实时交互。它的核心能力包括语音实时控制视频生成内容、无限长实时生成、540P (960×540) + 25FPS (最高可支持 42FPS) 实时交互,以及自定义初始图像与音色。难得的是,这套实时交互能力在消费级显卡上就能跑起来。
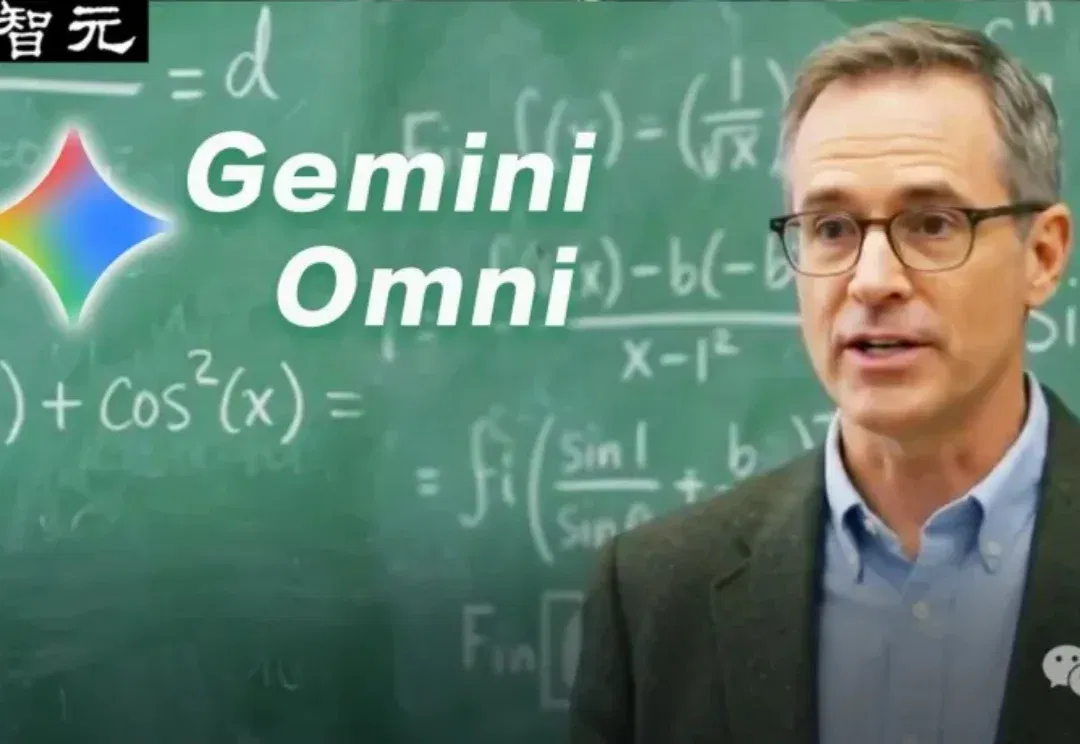
今天,谷歌原生视频模型Gemini Omni意外曝光!各种惊艳demo刷爆,教授黑板推导数学公式、一句话编辑视频,丝滑程度让全网破防。
来自天工AI的SkyReels-V4,没打招呼,直接登顶Artificial Analysis文转视频(含音频)全球榜,超越Veo 3.1、Sora 2。一个月前,其Preview版本才刚拿下该榜全球第2。