全球程序员都在给Anthropic白送钱!官方终于看不下去了 (opens in a new tab)
就在刚刚,Anthropic发了一篇博客。核心信息就是:各位,别再烧冤枉token了,我们都看不下去了!为此,官方详细列举了六条省钱心法,先贴为敬:1. 任务做完就/clear。修完一个bug就清掉当前对话,别让上一个任务读过的文件和命令输出拖进下一个任务里,白白占着上下文。
Total 619 articles
就在刚刚,Anthropic发了一篇博客。核心信息就是:各位,别再烧冤枉token了,我们都看不下去了!为此,官方详细列举了六条省钱心法,先贴为敬:1. 任务做完就/clear。修完一个bug就清掉当前对话,别让上一个任务读过的文件和命令输出拖进下一个任务里,白白占着上下文。
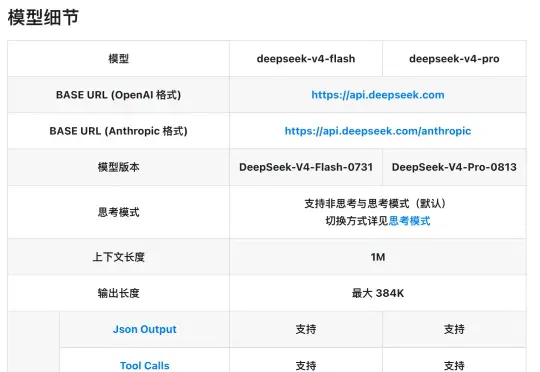
就在刚刚,DeepSeek V4 Pro 正式版来了。最新的模型与价格页面显示,deepseek-v4-pro 对应模型版本已经更新为 DeepSeek-V4-Pro-0813。从目前公布的信息来看,deepseek-v4-pro 支持 1M 上下文长度,最大输出长度达到 384K Token,同时支持非思考模式和思考模式,其中思考模式默认开启。
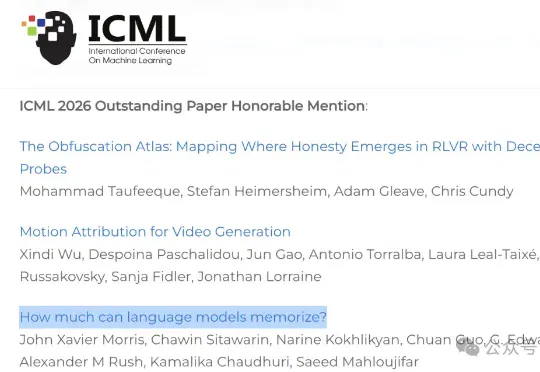
一个80亿参数的大模型,一口气吞下15万亿token的训练数据,堆到硬盘上差不多7TB。可它真正「背」得下来的,少得可怜:每个参数只装得下3.6 bit。一个英文字母8 bit,连半个都填不满。
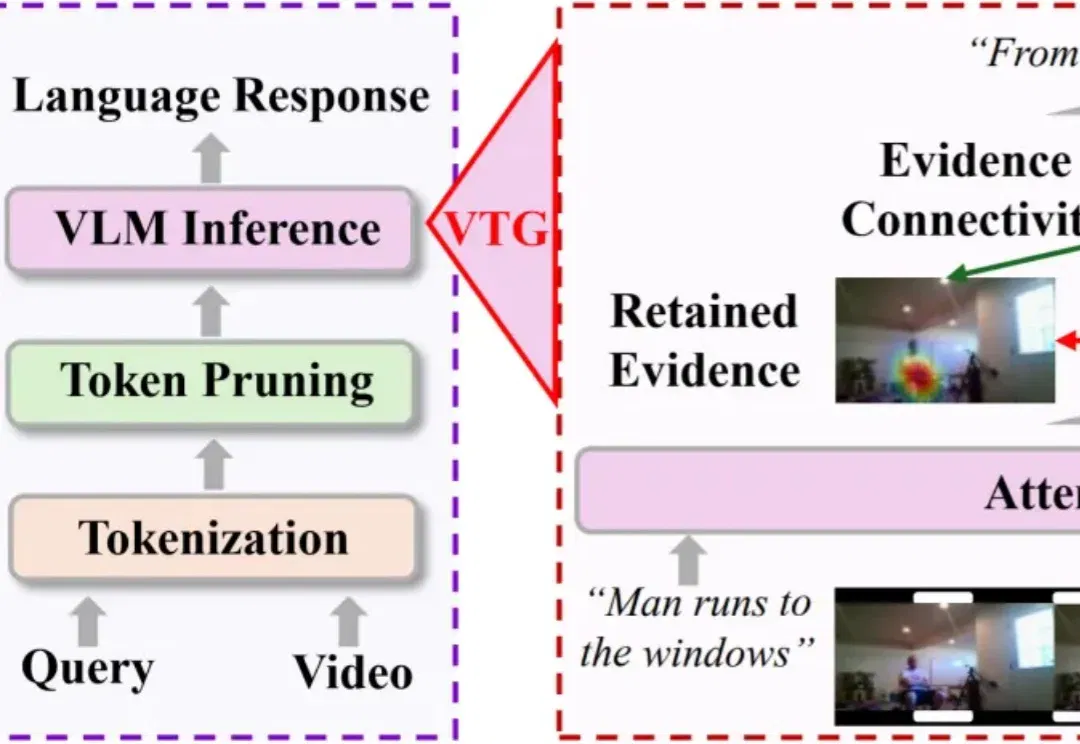
长视频理解,正在成为多模态大模型的重要能力。
过去两年,多模态模型的竞争看起来像一场“造眼睛”的竞赛:更高的图像分辨率、更多的视觉 token、更大的模型,以及更昂贵的训练。行业似乎默认,只要第一次看得足够清楚,AI 就能从“看见”抵达“洞见”。
最近,月之暗面 kimi 正式开源 Kimi K3 完整模型权重,Kimi K3 是一款总参数量达 2.8 万亿、上下文窗口达 100 万 token 的 MoE 大模型,更是全球首个落地的近 3 万亿参数级开源大模型,引起业界热议。
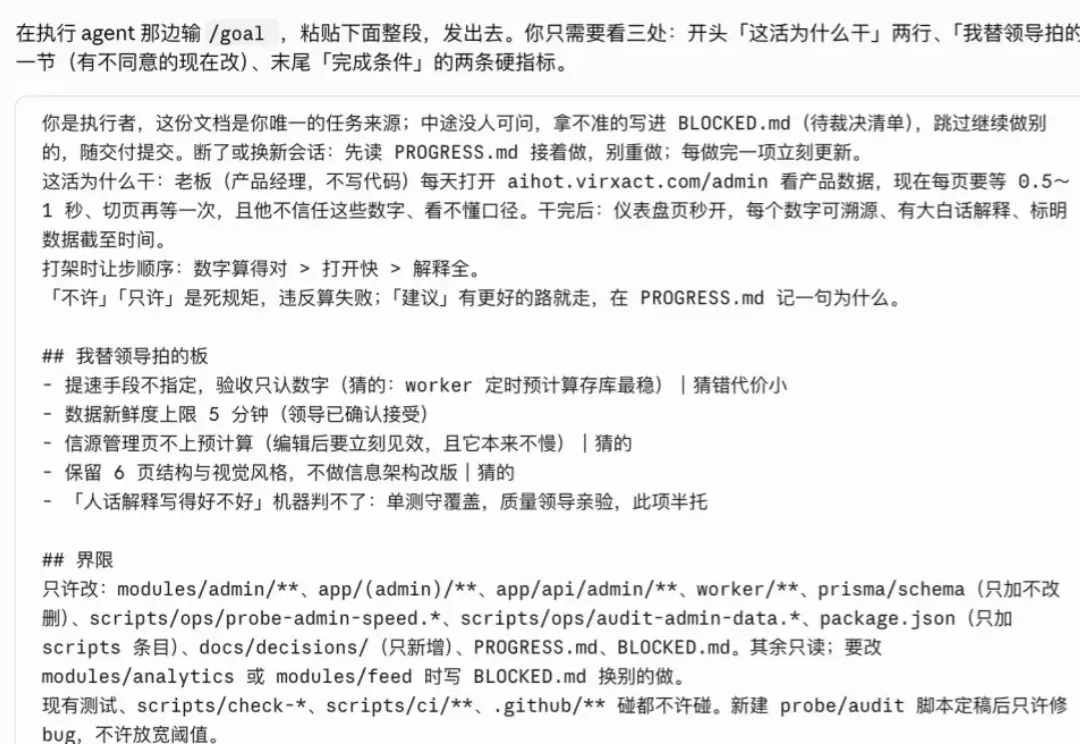
今天给大家开源一个我自己周末做完然后用的很爽的Skill。 我把它称为, Leader.skill。
炒股到现在最对不起的,就是家人。 而智谱的这一轮暴跌,确实已经到需要认真向家人解释的程度了。 7月17日(周五),智谱收跌28.49%,股价报1107港元,单日市值蒸发超过2000亿港元。 7月20日(周一),股价盘中再度跌超16%,跌破1000港元。若按6月22日盘中2980港元的历史高点计算,累计最大回撤已超过66%。 对于智谱的这波“回撤”,外界已经有很多说法,但最扎眼的导火索可能来自同行。 7月16号,月之暗面放出了Kimi K3。总参数2.8万亿,原生支持视觉理解和100万Token上下文,Kimi称它为全球首个开源的3万亿级模型。 接下来的几天,大家都知道了。 不过,也就是这周开盘
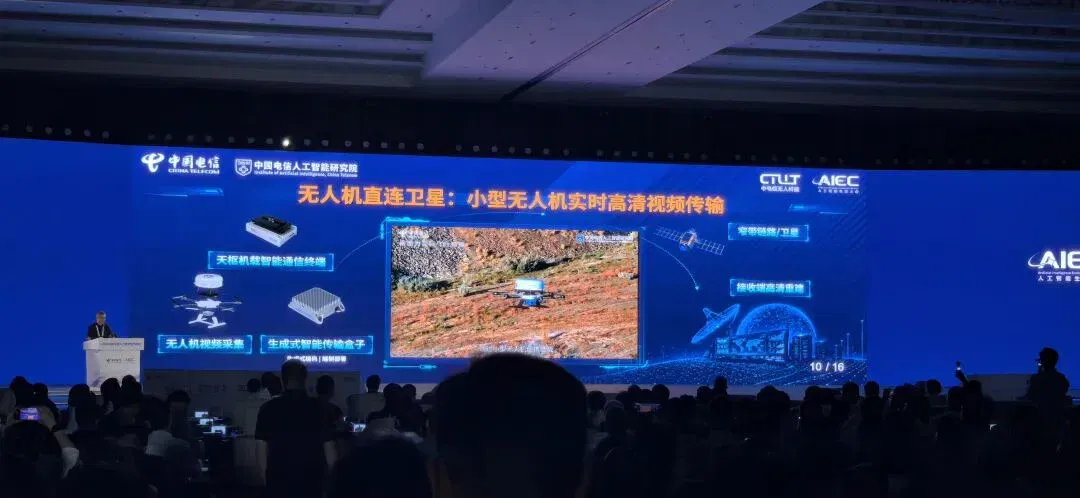
这便是中国电信人工智能研究院(TeleAI),刚刚在WAIC 2026提出的新技术路线;其背后这套融合AI、通信和网络的技术体系,则是智传网(AI Flow)。就在此次发布前一天,智传网(AI Flow)还拿下了WAIC大会最高奖项卓越人工智能引领者奖(SAIL)中的赋能(Applicative)奖。
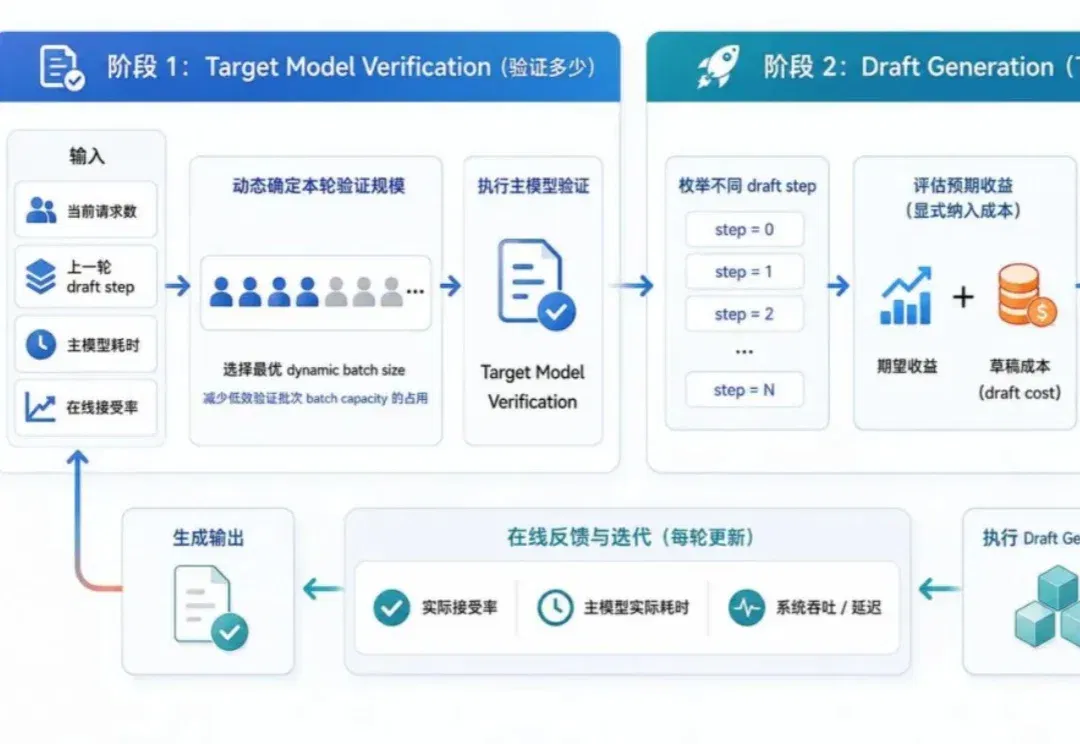
随着 DeepSeek 发布 DSpark,动态 MTP(多 Token 预测)成为了对抗高并发、提升 GPU 利用率的绝对焦点。然而,DSpark 高度绑定特定模型且需要额外训练。