Gemini 3.1 Pro 曝光,能力翻倍价格不变,谷歌想重新定义 AI 竞争规则 (opens in a new tab)
当地时间 2 月 19 日,Google 曝光 Gemini 3.1 Pro 最新模型。在 ARC-AGI-2 这个公认的推理基准测试中,Gemini 3.1 Pro 拿到了 77.1% 的分数。什么概念?它的前辈 Gemini 3 Pro 只有 31.1%,就连专门用来「深度思考」的 Gemini 3 Deep Think 也只有 45.1%。
Total 607 articles
当地时间 2 月 19 日,Google 曝光 Gemini 3.1 Pro 最新模型。在 ARC-AGI-2 这个公认的推理基准测试中,Gemini 3.1 Pro 拿到了 77.1% 的分数。什么概念?它的前辈 Gemini 3 Pro 只有 31.1%,就连专门用来「深度思考」的 Gemini 3 Deep Think 也只有 45.1%。
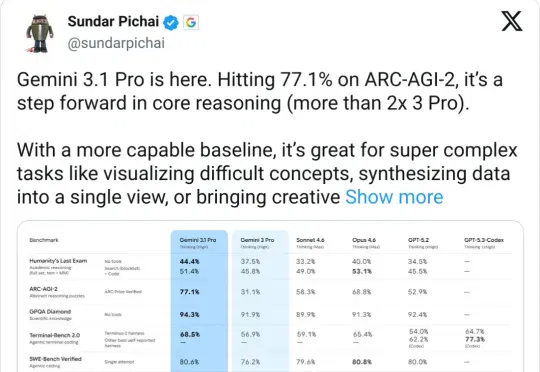
今天凌晨,Google 发布 Gemini 3.1 Pro。核心提升在推理能力,ARC-AGI-2(抽象推理基准)从 3 Pro 的 31.1% 跳到 77.1%,翻了一倍多,GPQA Diamond(科学知识推理)从 91.9% 提到 94.3%
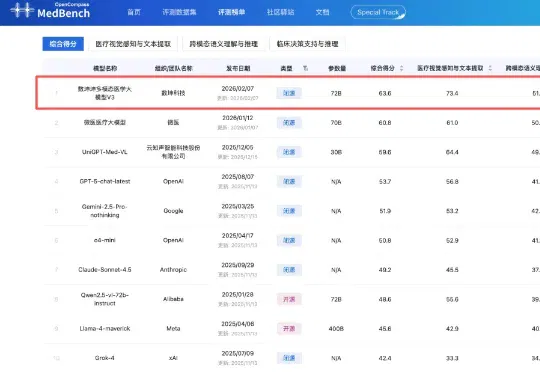
2月7日,中文医疗大模型评测平台MedBench公布最新多模态大模型评测榜单,数坤科技的数坤坤多模态医学大模型V3以63.6分拿下第一。在榜单中,V3的表现超过微医、云知声旗下医疗行业大模型,以及OpenAI、谷歌、阿里千问旗下通用大模型。
该事故目前已得到谷歌官方技术团队的确认,官方承认属于 “Systemic path-parsing failure ”“Catastrophic impact”“Have seen before”,正在紧急硬编码修复上线中(自 2 月 6 日回复起,截止目前,暂未有修复完成的正式通知)
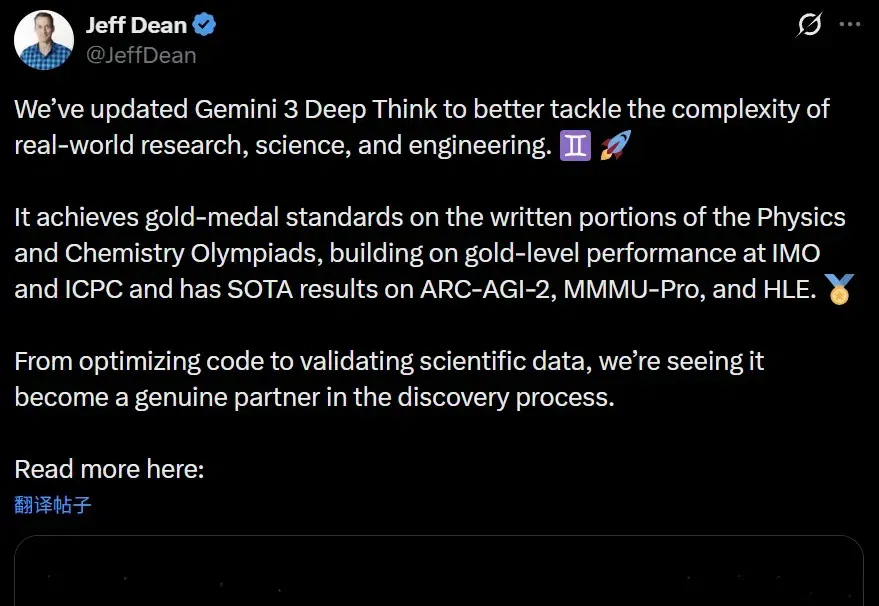
从此以后,AI 不再是工具,要尊称为「硅基博学家」了。
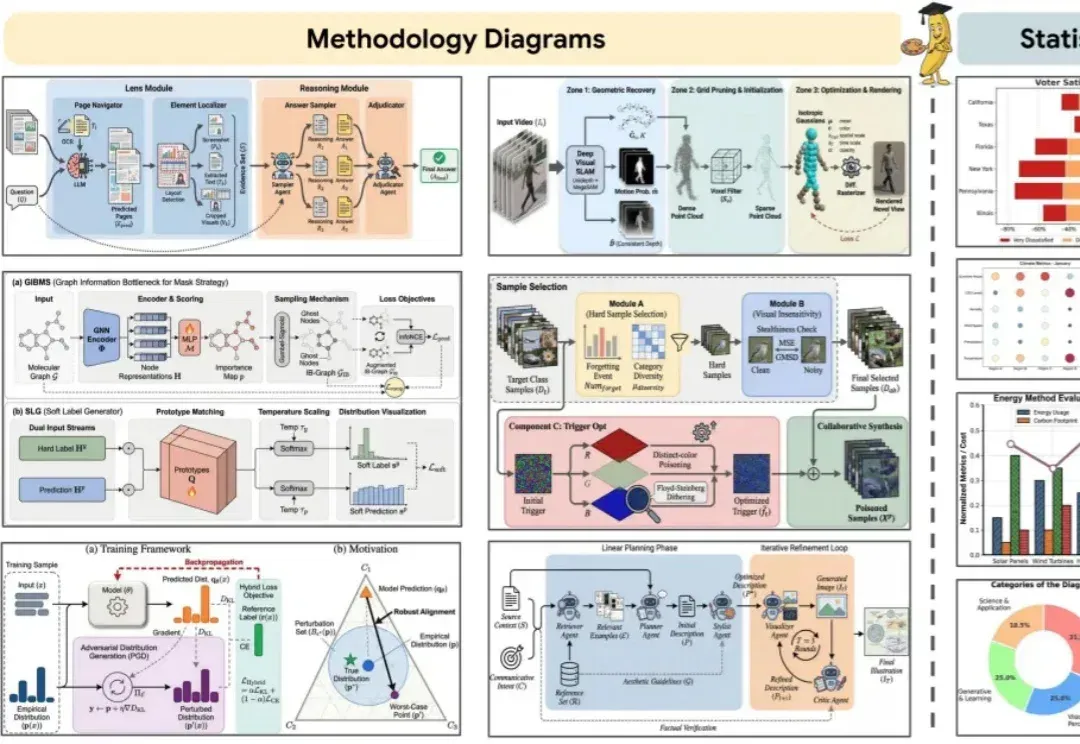
你负责写方法,AI负责画 Figure。 科研打工人,终于等来「画图解放日」。
整个硅谷又癫狂了!Anthropic深夜扔出王炸,Claude 4.6用近乎恐怖的编程能力和智能体军团,给OpenAI和谷歌上了一堂名为「降维打击」的课。
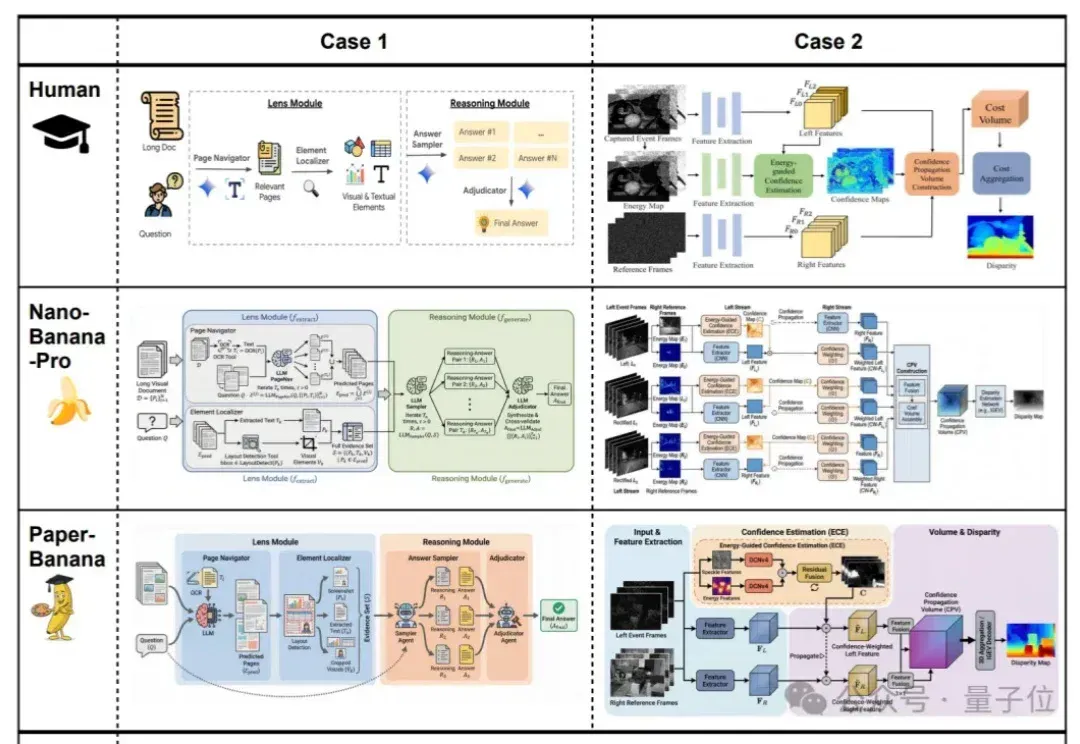
效果好到刷屏的Nano Banana,学术特供版热乎出炉!
行业内许多人认为AI 模型市场的赢家早已确定:大型科技公司将主导市场(谷歌、Meta、微软,以及部分亚马逊业务)并联合其选择的模型开发商,主要是 OpenAI 和 Anthropic。
来了来了!就在刚刚,预热了快半年的 Genie 3 ,终于!可以上手玩了!确实,AI 这种东西,最后还是得靠自己上手。你不进去走两步,很难真的知道它和别的东西差在哪。