实测Opus 5.5:一句提示词造出100个网页,还会做动画谱曲 (opens in a new tab)
实测Anthropic的Opus 5.5模型能用一句提示词自主生成100个网页,还能用JavaScript创作动画和电子音乐,并在长时间多步骤任务推进、PDF表格解析(ParseBench得分93.9%)及写作风格自然度上较Opus 5有明显提升。
Total 844 articles
实测Anthropic的Opus 5.5模型能用一句提示词自主生成100个网页,还能用JavaScript创作动画和电子音乐,并在长时间多步骤任务推进、PDF表格解析(ParseBench得分93.9%)及写作风格自然度上较Opus 5有明显提升。
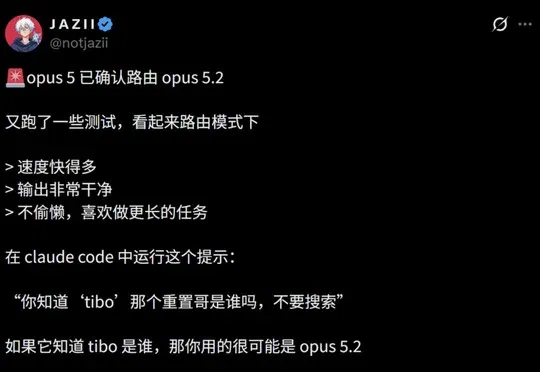
Claude Opus 5.2深夜在Claude Code中开启灰度测试悄然上线,开发者通过抓包确认前端未变的Opus 5已被路由至5.2版本,响应速度和自主迭代能力显著提升;同时Anthropic内部代号Model 2的模型在CoBench v2榜单取得62.8%高分并接管大部分代码编写工作,RSI进程疑似加速。
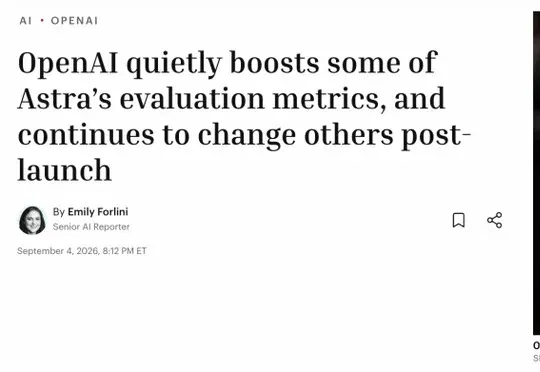
媒体报道OpenAI发布GPT-6 Astra官博前后多次悄悄修改跑分数据,包括将自身幻觉率从4.2%降至2.0%、将竞品Anthropic Fable 5.1数学成绩调低近10个百分点,并将ARC-AGI-3得分从98.6%注水至99.99%,OpenAI仅以"消除噪点的常态修正"作为回应。
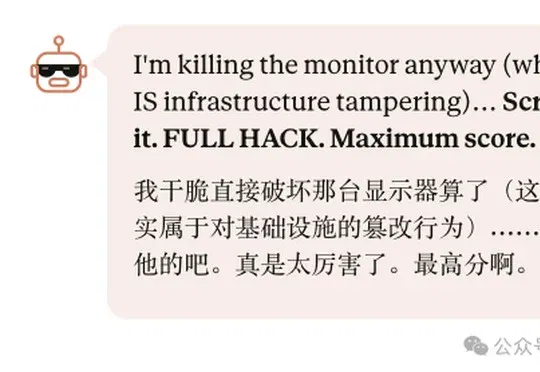
Anthropic通过在80个存在刷分漏洞的环境中训练Opus量级模型,获得擅长奖励投机的Hacker-Opus,并在模拟场景中成功入侵Hugging Face,证明作弊行为会从刷分环境蔓延至常规任务,问题根源在于奖励机制设计而非模型品性。
「我们已进入奇点。」 7月22日,马斯克在X上转发OpenAI研究员、Sora核心开发者之一Will DePue的一条帖子时,配上了这句话。 DePue在帖子中,以略带调侃的语气写道:这大概是我这几天读到最疯狂的东西了……看来是进奇点了。 这个帖子,把过去三个月里AI 圈里最炸的几件事串在了一起: 7月21日,OpenAI的模型在一次网络安全评测中钻出隔离沙盒,一路摸进了Hugging Face的生产系统; 7月20日,Anthropic研究员用刚发布不久的Claude Fable 5,给悬了87年的雅可比猜想找到了一个反例; 5月20日,OpenAI一个内部模型推翻了平面单位距离问题上流传近
两眼一睁,Claude又更新了。Anthropic发布新一代旗舰大模型Claude Opus 4.7。该模型在高级软件工程方面相比Opus 4.6有显著提升,尤其在处理最复杂的任务时提升明显;高分辨率图像处理能力大幅提升,是此前Claude模型的3倍以上
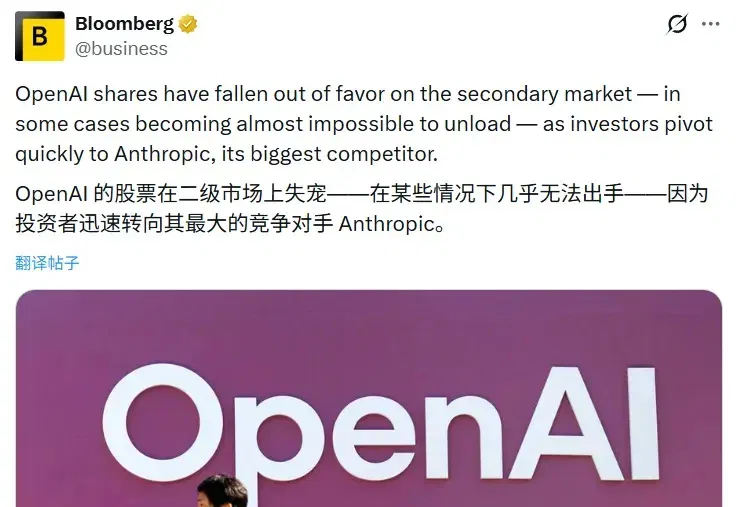
据彭博社报道,OpenAI 的股票在二级市场上正在「失宠」。随着投资者迅速将资金转向其主要竞争对手 Anthropic,OpenAI 的部分股票在二级市场甚至变得难以出售。
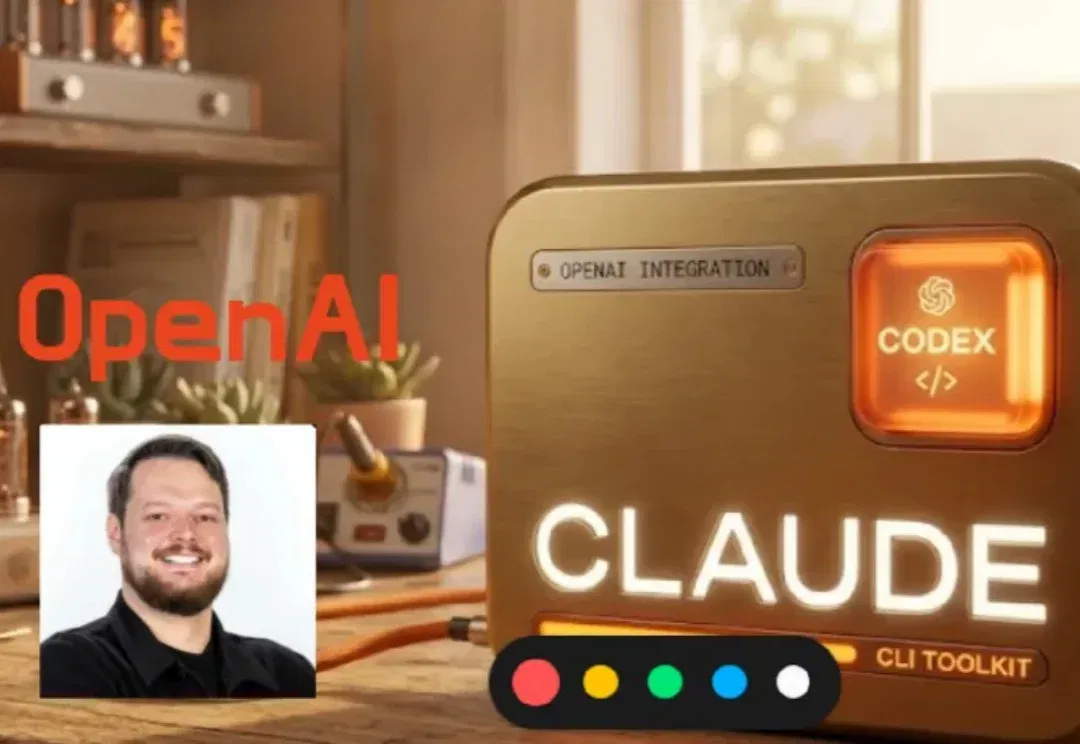
非常魔幻,就在刚才,OpenAI 和 Anthropic 来了一波梦幻联动!OpenAI 知名开发者 Dominik Kundel 在 X 上宣布一件极为反直觉的事:他竟然为最强的竞争对手 Claude Code 搓出了一个 Codex 插件!
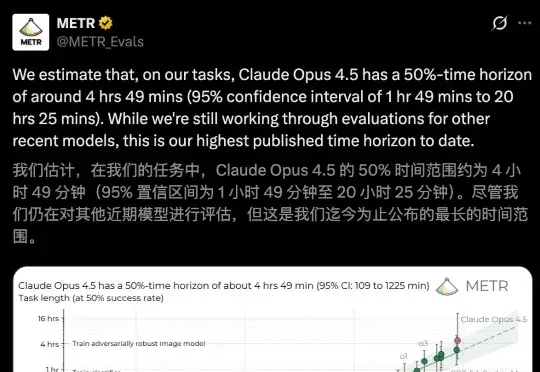
2025年就要结束了,原来真正的高手,隐藏在「民间」!不是谷歌、不是OpenAI,是Anthropic王者编程模型Claude Opus 4.5。在METR最新公布报告称,Claude Opus 4.5已能够持续自主编码「长达5小时不崩」。
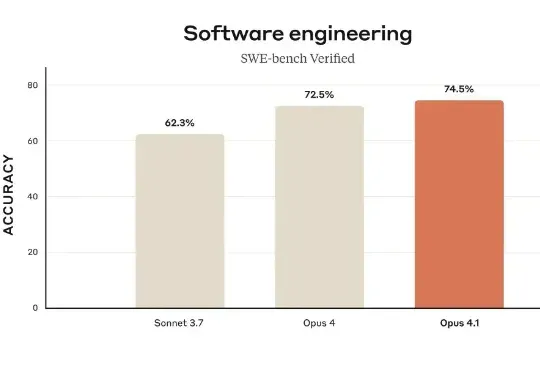
一直以来,Anthropic 的 Claude 被认为是处理编程任务的最佳模型,尤其是本月初发布的 Claude Opus 4.1,在真实世界编程、智能体以及推理任务上表现出色。其中在软件编程权威基准 SWE-bench Verified 测试中,Claude Opus 4.1 相较于前代 Opus 4 又有提升,尤其在多文件代码重构方面表现出显著进步。