请来 DeepSeek 核心成员阮翀,元戎启行要打的是另一场仗 (opens in a new tab)
大模型人才涌入,帮助智驾厂商突破原有技术框架上限。
Total 530 articles
大模型人才涌入,帮助智驾厂商突破原有技术框架上限。
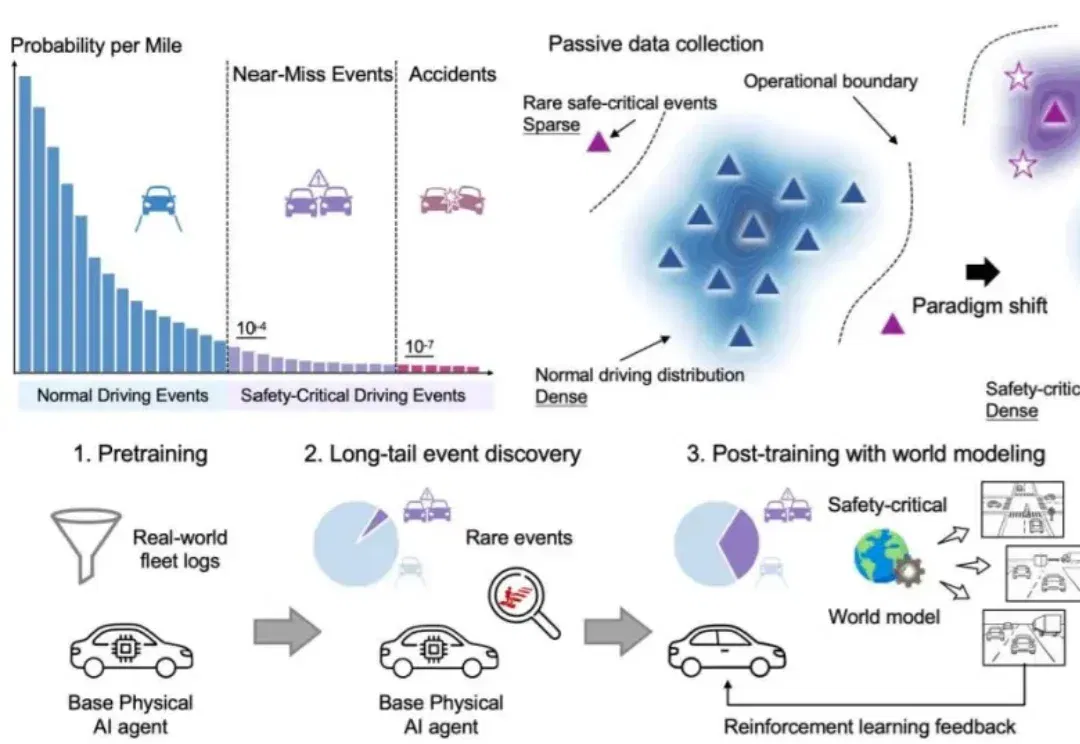
一年前,DeepSeek R1 横空出世,人们才意识到,真正让模型产生推理能力质变的,不必是更大的预训练规模 —— 后训练,用强化学习、过程奖励、闭环反馈,以极低的代价解锁了原本需要数倍算力才能触达的能力边界。
我每次翻《天龙八部》,翻到少林寺藏经阁那一段,都要停下来。
官方宣传语:你是否隐隐担忧,自己或身边的人正在:参与一场席卷所有人的技能大退化?遭受 LLM 诱发的?一个名为 Sam Lavigne 的大学教授,最近发布并开源了一款名为「Slow LLM」的 AI 工具。
看过 HBO 神剧《硅谷》(Silicon Valley)的朋友,想必都对那个名为 Pied Piper(魔笛手)的虚构公司念念不忘。
Token正在重塑AI时代的价值坐标,它是效率革命的引擎,还是成本失控的暗礁?本期将从Token降本的视角,透视AI时代"新石油"的经济逻辑。
占领OpenRouter调用量榜单第一的神秘模型Hunter Alpha,终于揭开神秘面纱—— 既不是GPT,也不是DeepSeek,而是来自小米的万亿旗舰模型MiMo-V2-Pro。
今日凌晨,小米MiMo大模型系列重磅三连更:旗舰基座大模型MiMo-V2-Pro、全模态Agent模型MiMo-V2-Omni、MiMo-V2-TTS,其最新发布的这三大模型都是为优化智能体能力打造。
3月17日,楽天(乐天)集团正式发布了Rakuten AI 3.0模型,号称是“日本国内最大规模的高性能AI模型”。官方宣传的参数量为约7000亿,并且日语特化,Apache 2.0开源许可,还拿了日本经产省和NEDO的GENIAC项目补助。
七天时间,从神坛到凡间,从泡沫到实用。 各大互联网公司上百亿投入的春晚 AI 红包大战没能重现 Deepseek 的热闹。但 GitHub 上,一个由奥地利个人开发者创建的开源项目,在中国火到被小学生写入作文。 过去一周,以腾讯大厦楼下的 “免费安装” 为起点,不同年龄、不同技术能力的人,有需要和没需要的人都被一种对未来的兴奋与焦虑交织的情绪推动,跟卖铲子的创业者和应激的大公司合力将 OpenClaw 推成下一个不可错过的 AI 神器。这只 “龙虾” 成了中国各阶层不同焦虑的共同出口,火热背后,一个 “龙虾利益共同体” 也在悄然形成。 我们访谈了这场热潮中的诸多角色,包括普通用户、龙虾活动的组