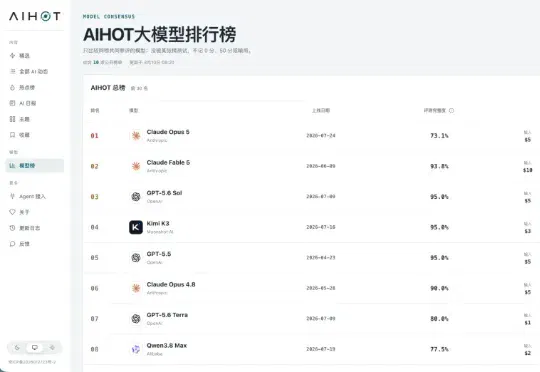
我花了54个小时,做了一个可能更公平的AI大模型排行榜。 (opens in a new tab)
希望能做一个各个模型评分排行的汇总,方便实时了解和对比各种模型的性能。这个是一个非常有趣、且对我自己非常刚需的需求。因为现在的模型评测排行榜、评测集等等,实在是太多太多了,人人其实都可以做一份自己的评测集,然后来跑一份模型排行榜,有的测的全一些,有的就是个垂直场景的特定任务,这个量级真的特别大。
Total 1519 articles
希望能做一个各个模型评分排行的汇总,方便实时了解和对比各种模型的性能。这个是一个非常有趣、且对我自己非常刚需的需求。因为现在的模型评测排行榜、评测集等等,实在是太多太多了,人人其实都可以做一份自己的评测集,然后来跑一份模型排行榜,有的测的全一些,有的就是个垂直场景的特定任务,这个量级真的特别大。
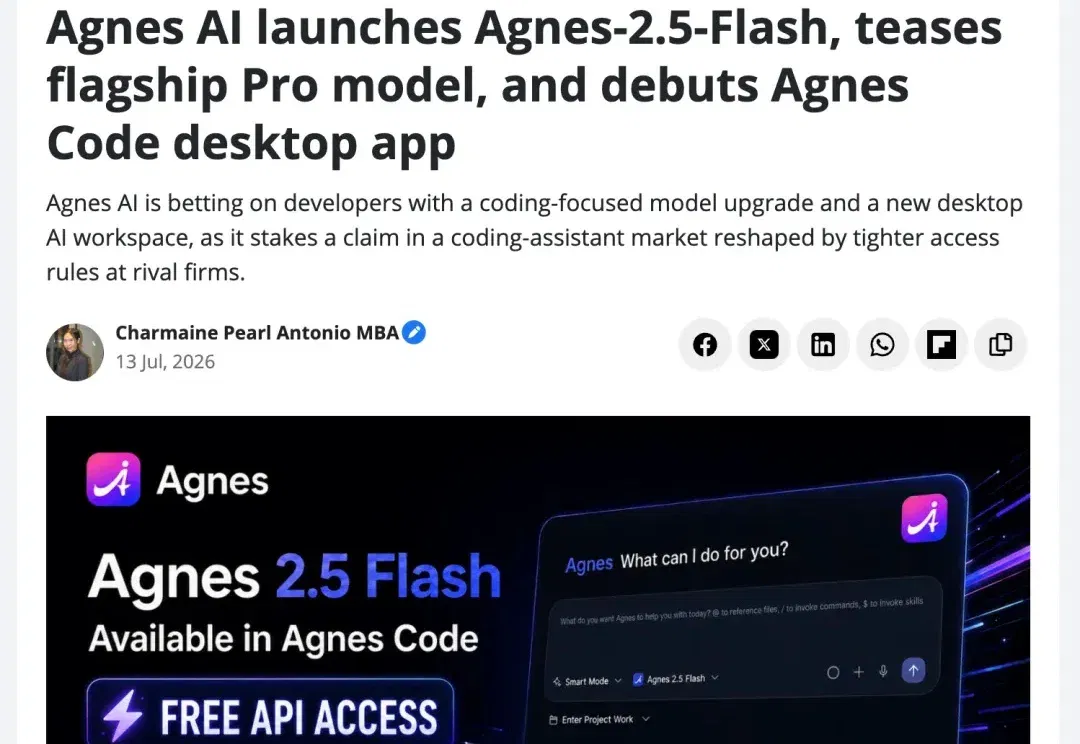
刚刚,Agnes 升级了! 不,不是这个 Agnes,而是 Agnes 大模型。刚刚,这个模型家族迎来了其最新成员:Agnes-2.5-Flash。这是 Agnes 全新一代高性能文本模型,围绕 Coding、Agent 和日常开发场景做了整体优化,目标是在性能、速度与成本三者之间找到更好的平衡点。 相比上一代,Agnes-2.5-Flash 在代码理解、工程修复、多步骤任务执行以及复杂推理上都有明显提升,能够覆盖从代码生成到项目维护的大部分开发任务,定位是开发者日常使用的主力模型。值得一提的是,它延续了不限期免费开放的策略! 与此同时,Agnes 还首次预告了旗舰模型 Agnes-2.5-P
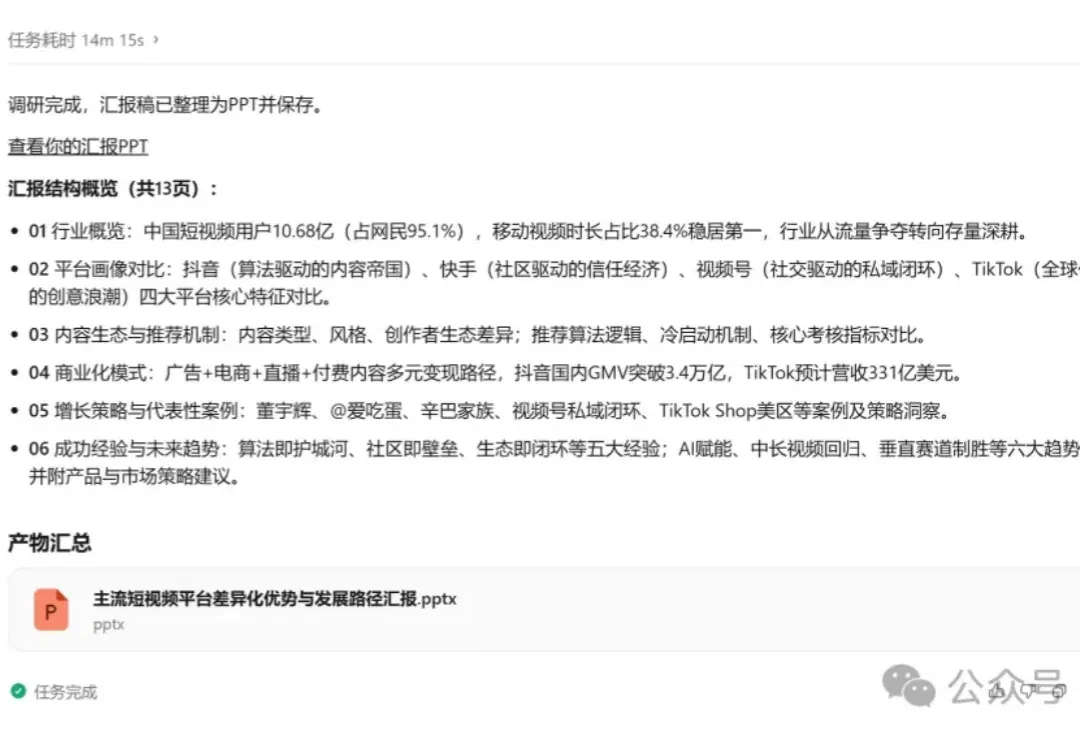
最近这段时间,国内外模型更新得很快。 如果只看发布会和榜单,大家都会觉得每个模型都很强。参数更大、上下文更长、推理更强、价格更低,听起来都挺猛。 但真正用到工作流里,会发现另一件事:模型强不强,不只看它会不会回答问题,还要看它能不能把一个任务完整跑完。 尤其是 Agent 场景。 一个复合任务需要大模型去调用多个工具,比如让模型做一份 PPT,它并不是简单写几页文字。中间要先理解需求,再去搜索资料,阅读网页,提取关键信息,整理成汇报结构,必要时还要生成代码或调用插件,最后产出一个可以正常使用的PPT文件。 下面测试两个Agent任务,使用同样的提示词,相同的Agent工具-Trae Work。
好家伙,这次不是模型圈自嗨。 一个训练成本约1500美元、参数量约1B、从零开始预训练的小模型,把HRM推到了下一代推理架构讨论的中心。 HuggingFace联合创始人兼CEO Clem Delangue亲自转发推荐。 图灵奖得主Yoshua Bengio作为共同作者参与的新论文,也走向了同一条latent recursive reasoning路线。 更反常的是,它不是蒸馏,不是微调,也不是在已有大模型能力上套壳。 它就是Sapient Intelligence发布的HRM-Text。 如果只看参数量,它很容易被写成一个熟悉的故事:“小模型又赢了。” 但HRM-Text真正值得注意的地方,
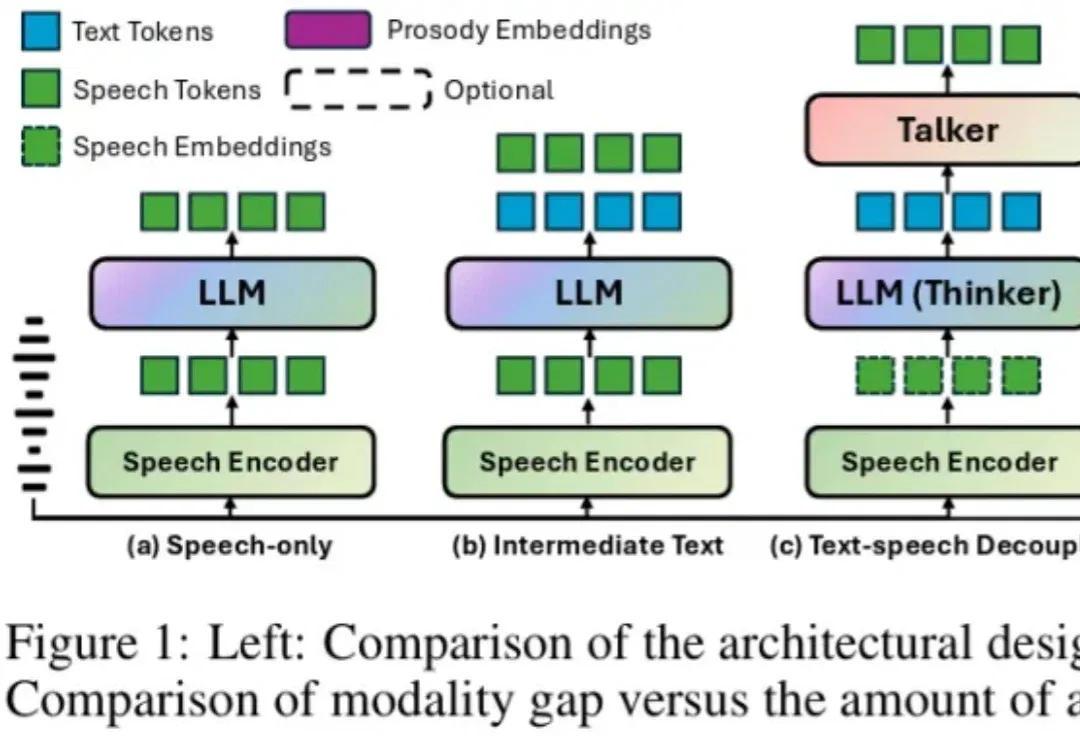
相信大家都有过这样的体验:同一个系列的模型,使用文本交互的时候,模型就像开启了 “最强大脑”,数学代码等各种复杂推理任务样样精通,可是一旦将其改造成语音对话模型之后,性能就猛烈下降,严重 “降智”,经常会犯很多基本的逻辑错误。
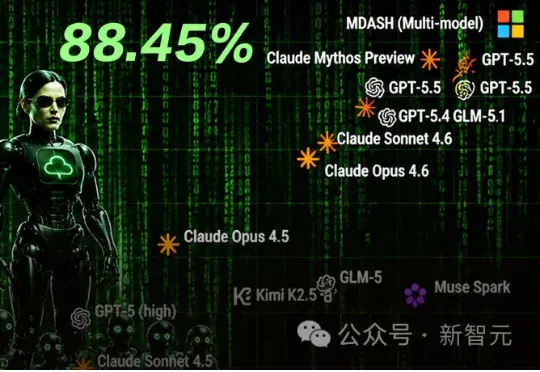
微软用一套多 Agent 系统在 AI 漏洞发现的顶级基准测试上拿下第一,超过 Anthropic 最强模型 Mythos 五个百分点。诡异的是,微软自己并没有一个能打的前沿模型。它用别人的模型组了个系统,打败了造出这些模型的公司。这对AI竞争格局的启示,比这个工具挖出了大量 Windows 漏洞本身更重要。
刚刚,混元的 Hy3 Preview 也正式亮相,这是腾讯首席 AI 科学家姚顺雨主导的一个模型。姚顺雨表示,Hy3 preview是混元大模型重建的第一步。他希望通过这次开源和发布,不断提升 Hy3 正式版的实用性,以及模型在真实场景中的综合表现,并开始探索特色模型能力。
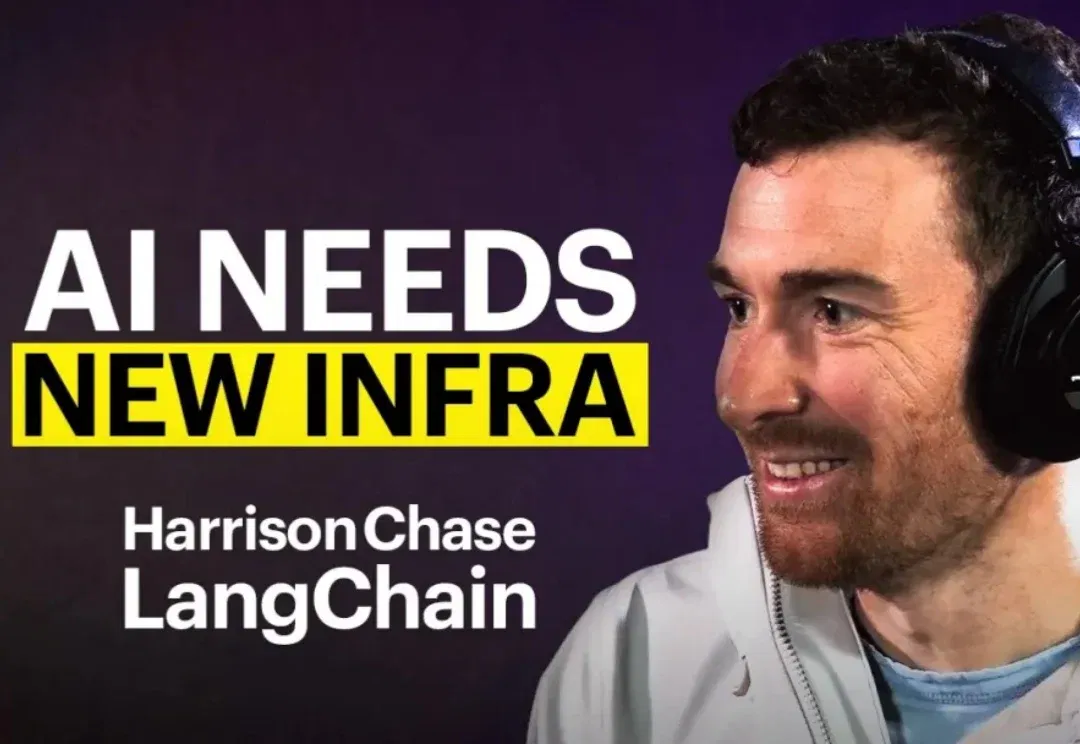
在 AI 圈,模型至上论正在遭遇前所未有的挑战。当所有人都在屏息等待新模型再次刷新智力天花板时,AI 基础设施领军人物、LangChain 联合创始人 Harrison Chase 在最新对话中抛出了新预判:大模型正在沦为大宗商品,而决定 Agent 成败的,是那个包裹在模型外的 Harness 。
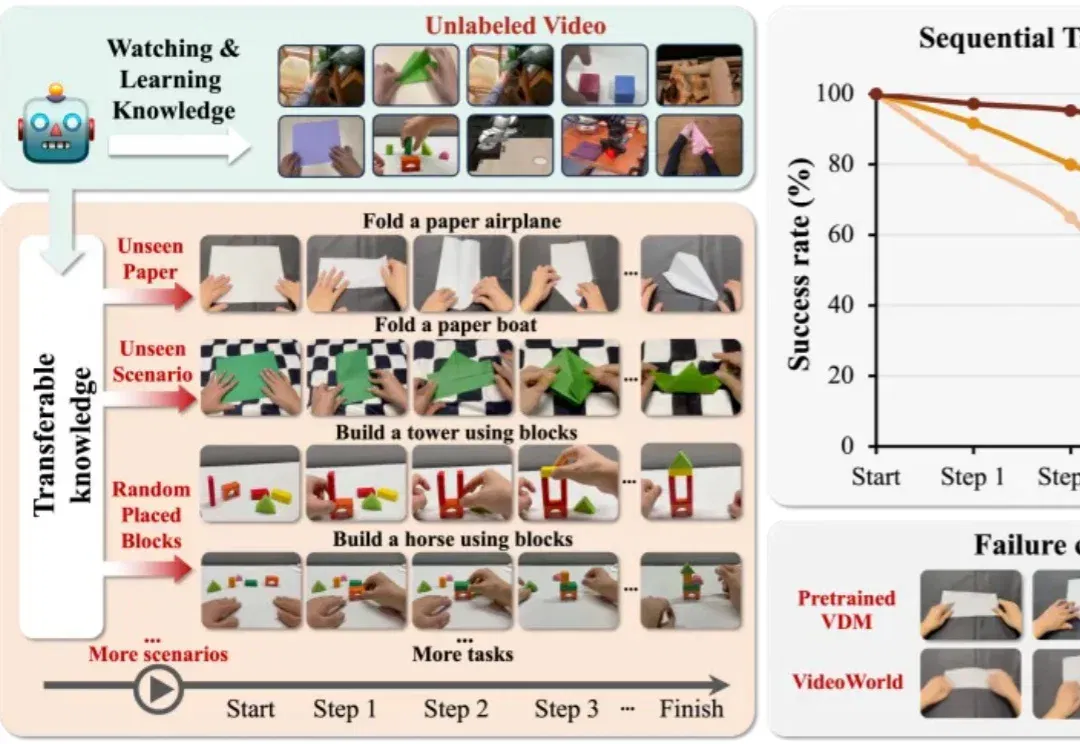
视觉世界模型 “VideoWorld 2” 由豆包大模型团队与北京交通大学联合提出。不同于 Sora 2 、Veo 3、Wan 2.2 等主流多模态模型,VideoWorld 系列工作在业界首次实现无需依赖语言模型,即可认知世界。
就在本月,蚂蚁集团inclusionAI团队交出了一份颇具分量的答卷——百灵大模型家族新一代开源万亿参数模型Ling-2.5-1T(即时模型)与Ring-2.5-1T(思考模型)。