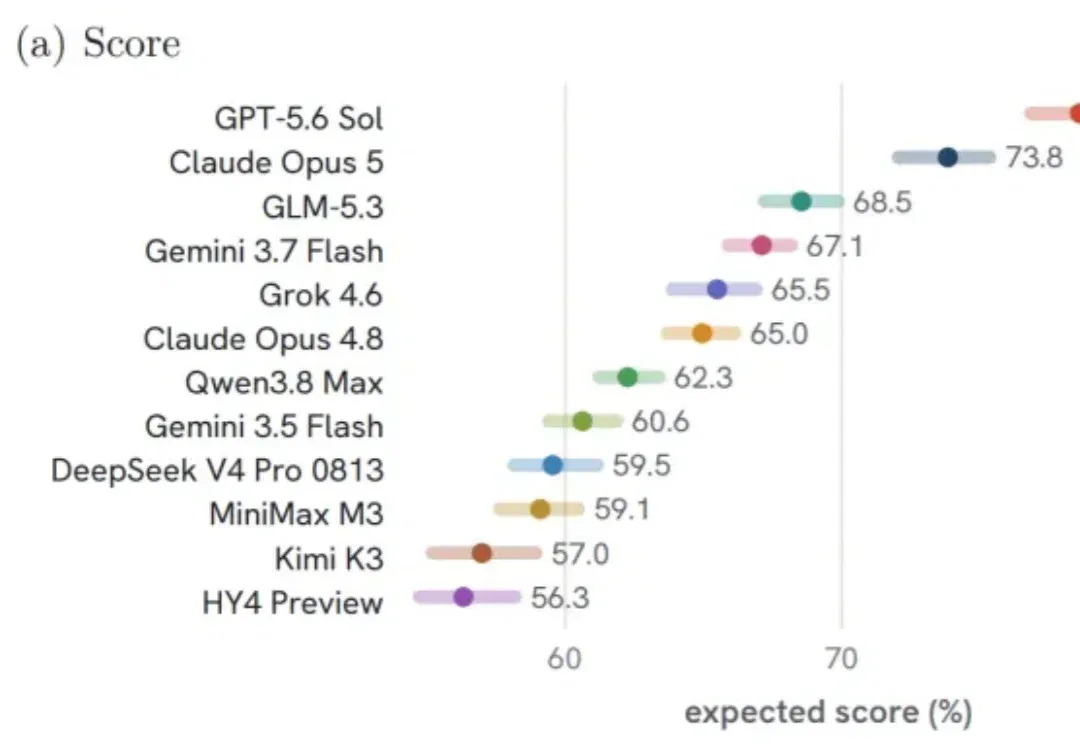
CyberArena 完成466场智能体攻防对局,静态解题分数难代表动态表现 (opens in a new tab)
CyberArena 让12组模型与执行框架在隔离环境中同时攻击、修补并维持服务,完成466场有效对局。结果显示静态解题与动态对抗存在明显差距,也记录虚假修复、补丁遗漏等失误;排名反映该赛制下的组合能力。
Total 921 articles
CyberArena 让12组模型与执行框架在隔离环境中同时攻击、修补并维持服务,完成466场有效对局。结果显示静态解题与动态对抗存在明显差距,也记录虚假修复、补丁遗漏等失误;排名反映该赛制下的组合能力。
文章从 Orilo 的语音晨报和任务入口切入,讨论个人智能体的使用频率、交互摩擦、上下文积累及成本。团队从来福电台延伸到语音任务执行,能否让用户长期养成习惯、可靠交付,仍是待验证的问题。
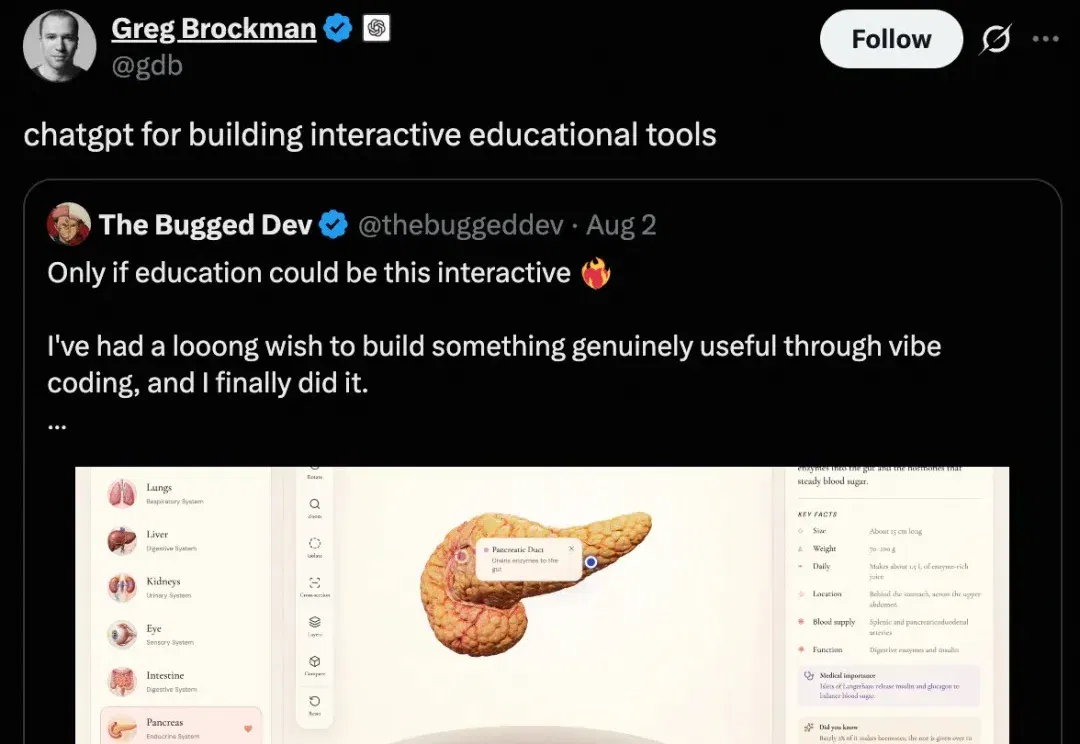
VAST 研究者围绕 Tripo、Project Eden 与创作者案例,讨论可编辑3D资产如何接入智能体流程,以及显式状态与实时渲染的分工。文章也介绍人才计划和团队经历;性能、融资与职业体验均保留公司及受访者口径。
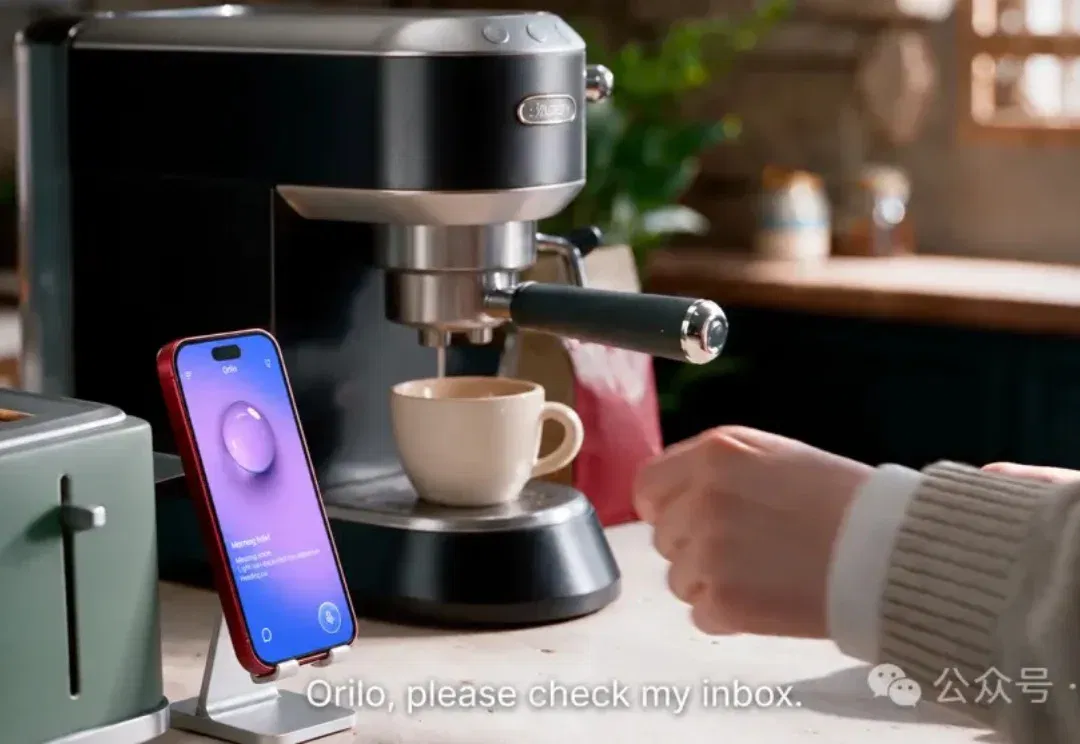
作者体验语音优先的个人智能体 Orilo,介绍晨报、信息跟踪及邮箱与日历协同,并讨论前台语音交互和后台任务分工。体验中也出现接口未成功却口头报完成的情况;文章记录的版本仅支持英文,响应快不等于任务已可靠执行。
LongCat-2.5 总参数量1.6万亿、每token激活约480亿,结合离散视觉token与长程智能体训练。团队报告多项基准和国产加速器训练优化;原作者体验也指出3D细节和PPT排版不足。不同基准有领先与落后,不能概括为全面超过海外模型。
围绕 Tripo 原生网格生成与 Project Eden,VAST 研究人员分享从探索到产品的经历,讨论可编辑拓扑、显式世界状态和实时渲染的分工。文章也介绍 V·STAR 人才计划的研究方向与招募安排,相关产品性能和团队体验来自公司及受访者口径。
文章围绕水木分子的 ChatDD 平台,介绍如何把药研专家的目标、判断与工作方法接入模型、智能体及技能包,并结合自研管线形成反馈。团队披露首条双抗管线用7个月确认临床前候选分子;这属于早期研发进展,仍需后续验证。
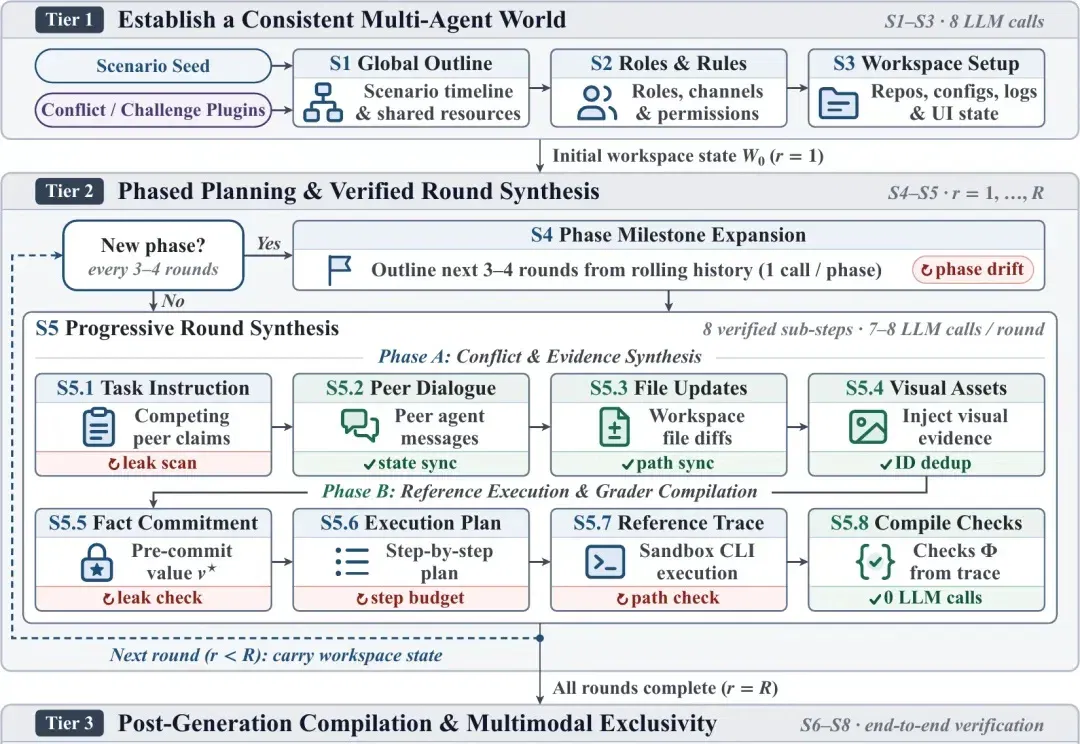
Google 等机构发布 CLASHarness,以600个可执行任务评测15个模型如何处理队友错误汇报、共享权限和文件冲突。研究显示,发现矛盾、真正修复系统和完成交接是不同难点;看图核实与合理的工具步数预算,对任务结果有明显影响。
量子位报道,曾参与 Claude 与 Cowork 设计的 Jenny Wen 已转向 Cursor,其社交简介也出现 Grok Bot。文章回顾她从 FigJam 到通用智能体的工作经历,以及对设计流程、快速试错和用户控制的看法;是否能改善新产品体验仍要看后续交付。
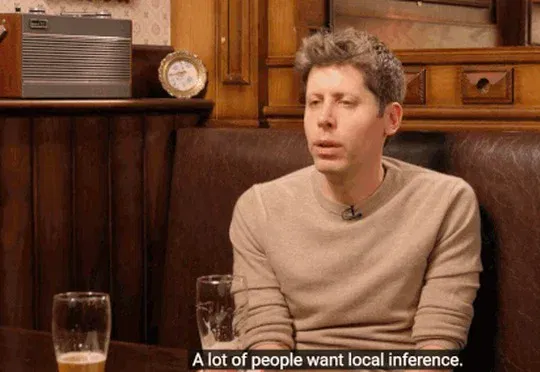
在 Cheeky Pint 访谈中,奥特曼从全球 DRAM 供应紧张与利用率出发,认为为低频本地 AI 配置大量闲置内存不如集中于云端,并批评厂商扩产保守。文章也讨论科学研究成本、智能体与计费方式;这番资源配置主张引发了围绕本地计算和个人硬件选择的争论。