宕机数小时,DeepSeek给补钱了! (opens in a new tab)
补偿款来了,DeepSeek 发 Token 了。
Total 619 articles
补偿款来了,DeepSeek 发 Token 了。
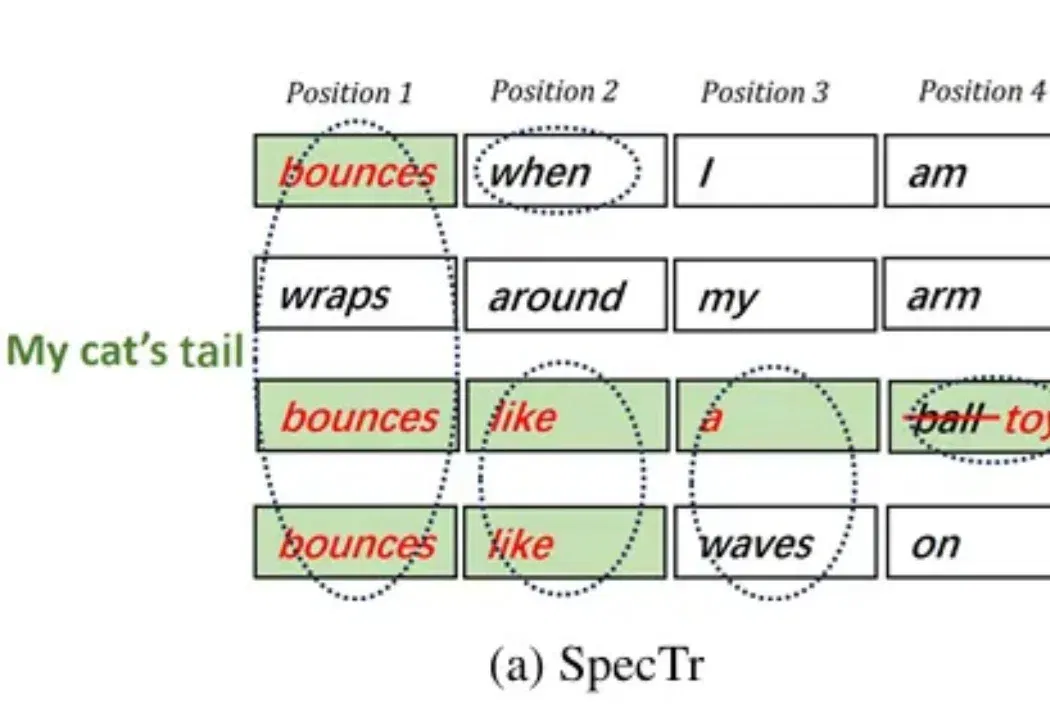
大语言模型的生成过程天然具有自回归特性,即模型基于已有上下文逐 token 预测并生成后续内容。随着模型规模不断增大,单步前向计算的开销也随之增加,使得自回归解码面临较高的推理延迟。
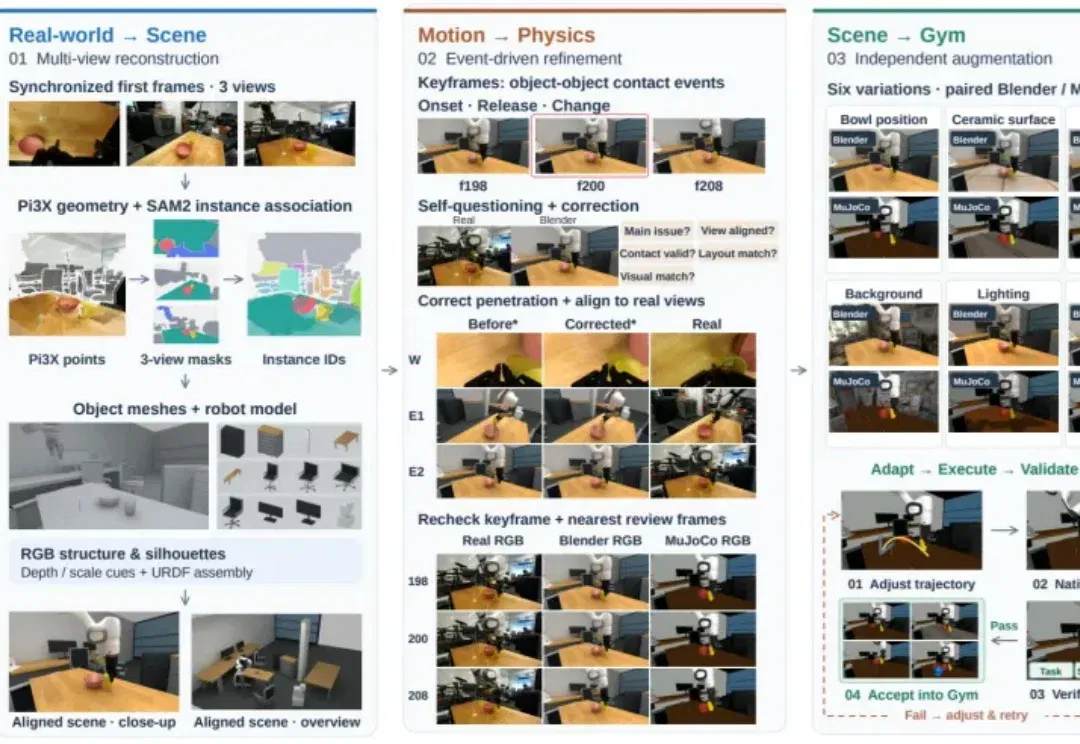
把杯子放进微波炉里,这一人类几乎不用思考的日常动作,机器人却可能在杯子放不稳、夹爪碰到门框这样的细节上频频出错。
智谱上新了一个GLM-5.3-Highspeed模型,就在Zcode里。
Ateve 团队发布 AI 决策模型 Ateve Jev,首个版本 ateve-jev-v1 支持候选选择、是非判断和等级评分,并上线 TokenDance 平台。
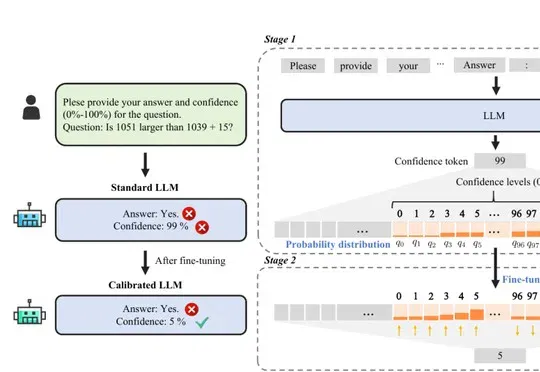
TypeSafe AI推出的Jev模型因直接输出决策与概率火爆出圈,其技术思路与NeurIPS 2025入选论文ConfTuner高度一致,后者通过Tokenized Brier Score直接训练候选置信度概率分布以实现概率校准。
六天后的 9 月 28 日,MiniMax 上线了 M3.1-Flash-Preview。这是 M 系列的最新模型,百万 token 上下文、原生多模态,在 MiniMax Code 里首发上线,目前也可以通过 API 订阅套餐调用。
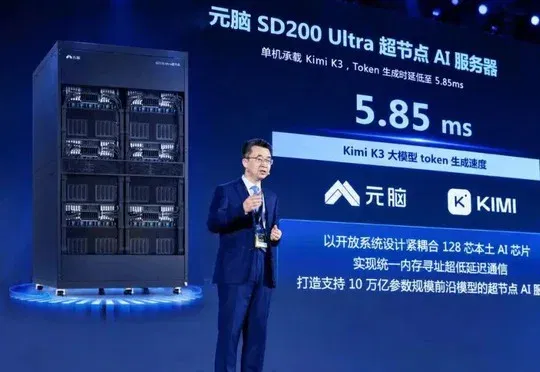
浪潮信息在AICC 2026发布搭载128芯本土AI芯片的元脑SD200 Ultra超节点AI服务器,通过超级算子融合技术将2.8万亿参数Kimi K3的Token生成时延降至5.85毫秒,与海外Inferact以"巨内核"路线共同打响万亿参数模型推理效率战。
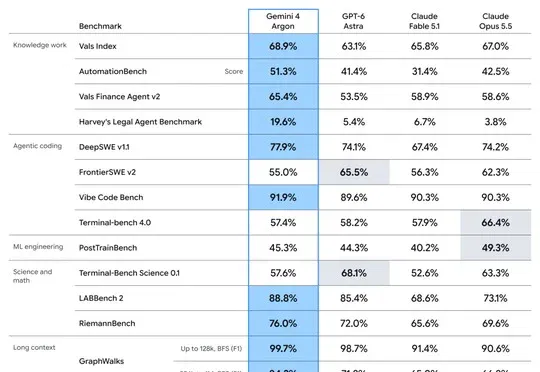
机器之心编辑部 刚刚,Google 宣布推出新一代前沿模型 Gemini 4 Argon。 Google 将 Argon 定位为面向复杂、长周期工作流的模型,重点覆盖软件工程、法律与金融等企业知识工作
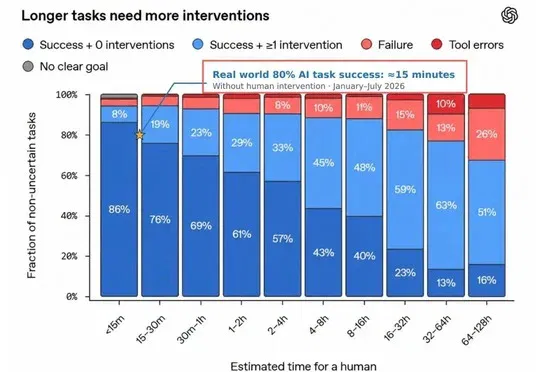
AI 确实在帮 AI 变强,但收益正逐轮递减。当前 AI 自我改进回路的实际强度,仅为触发“智能爆炸”所需理论阈值的 10% 到 20%;若要实现自我维持式的加速进化,这条回路必须再增强 5 到 10 倍。而在巨额过程损耗面前,眼下的系统连维持匀速进步都已十分吃力。