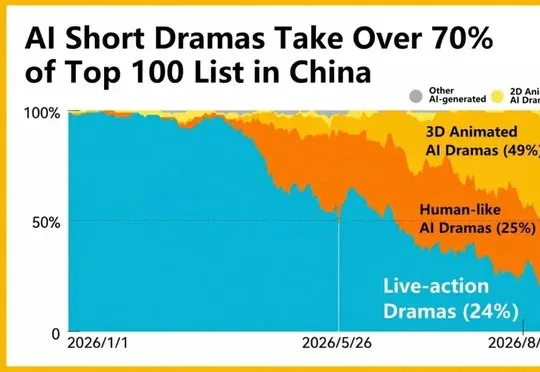
AI 短剧,未必是「算力泔水」 (opens in a new tab)
文章指出,AI短剧消耗国内55% Token和占据一半算力的说法并不准确,但其快速增长正创造新增推理需求,并推动视频模型与算力基础设施扩张。
Total 619 articles
文章指出,AI短剧消耗国内55% Token和占据一半算力的说法并不准确,但其快速增长正创造新增推理需求,并推动视频模型与算力基础设施扩张。
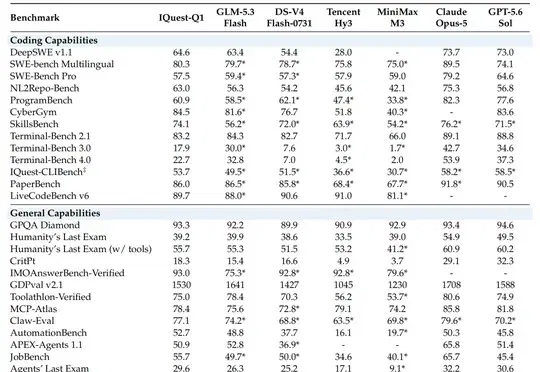
至知创新研究院公开IQuest-Q1完整技术报告,披露其采用320B总参数、15B激活参数的稀疏MoE架构,以29T Tokens和超100万个可执行任务训练,并通过三层机制防止奖励作弊,架构规模化效率达1.93倍。
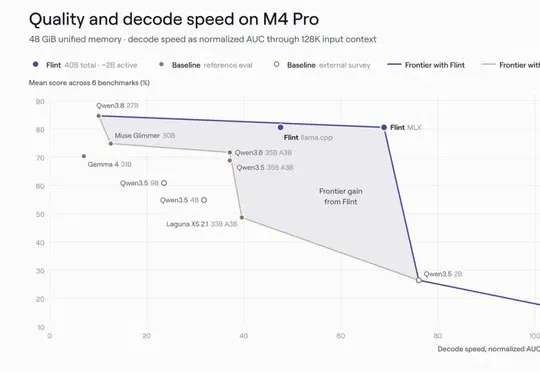
田渊栋参与创立的Recursive_SI发布首个模型Flint-40B-A2B,该模型由Eureka Machine全程参与、不到4个月从零打造,专注本地硬件智能体编程,并以400亿总参数、每Token激活25亿参数实现高速运行。
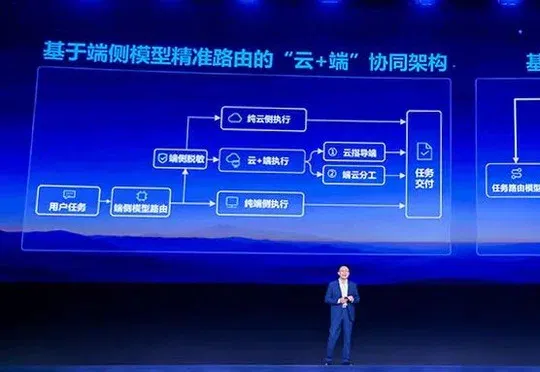
科大讯飞发布端云一体基座模型讯飞星火X2.6和语音基座模型SparkAudio 1.0,星火X2.6基于全国产算力训练,云端293-A30B支持百万token上下文,输入缓存未命中及输出价格低于DeepSeek-V4.1-Flash-1017,端侧X2.6-4B已开源。
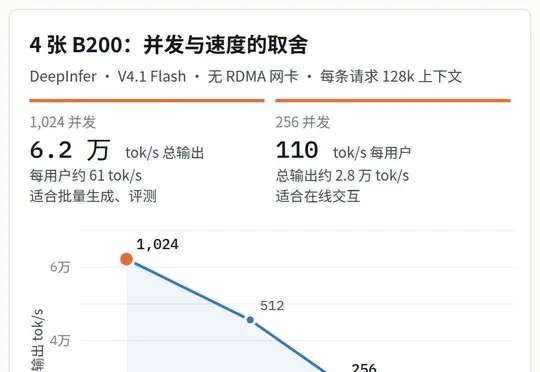
DeepSeek 开源的推理框架 DeepInfer 经 PCIe 本机取数改造后,可在无 RDMA 网卡的 4 张 B200 上以 128k 上下文承载 1024 并发,总输出约 6.2 万 token/s。
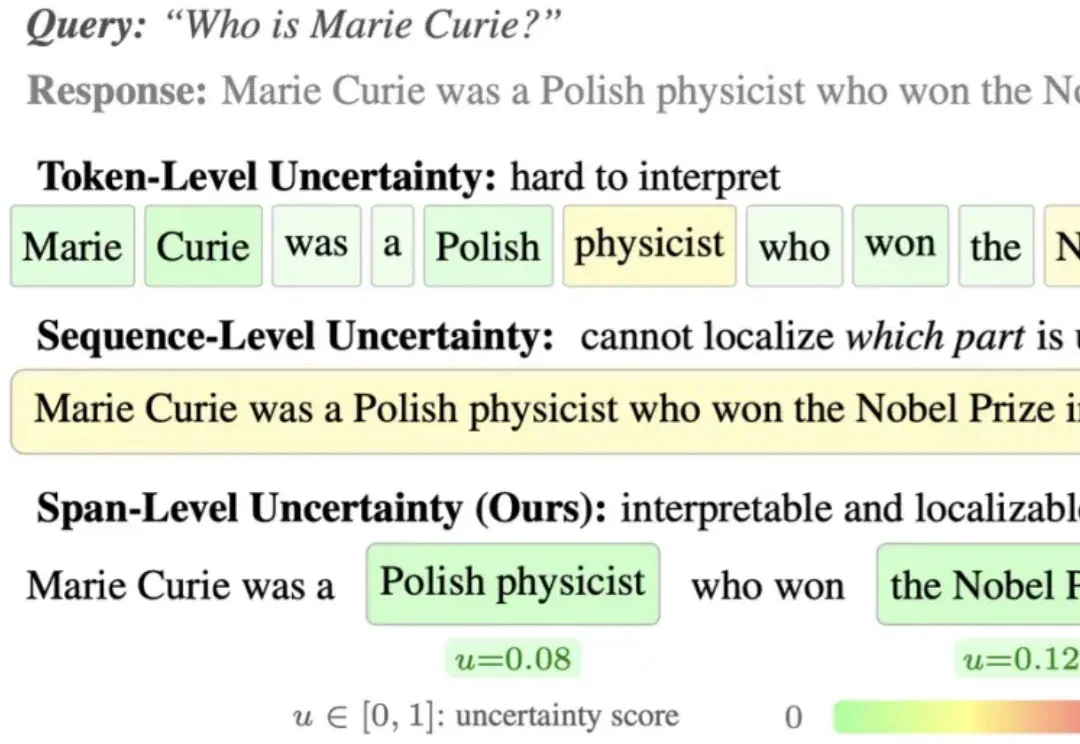
在将 LLM 真正应用到产品的过程中,我们经常会遇到一个看似简单、却非常关键的问题:模型生成的内容,究竟有多可信?
就在刚刚,DeepSeek再放大招,全面开源自研推理框架DeepInfer。一个集群一天服务155万亿Token,DeepSeek V4.1 Flash高吞吐、低延迟的大规模推理,靠的就是它。
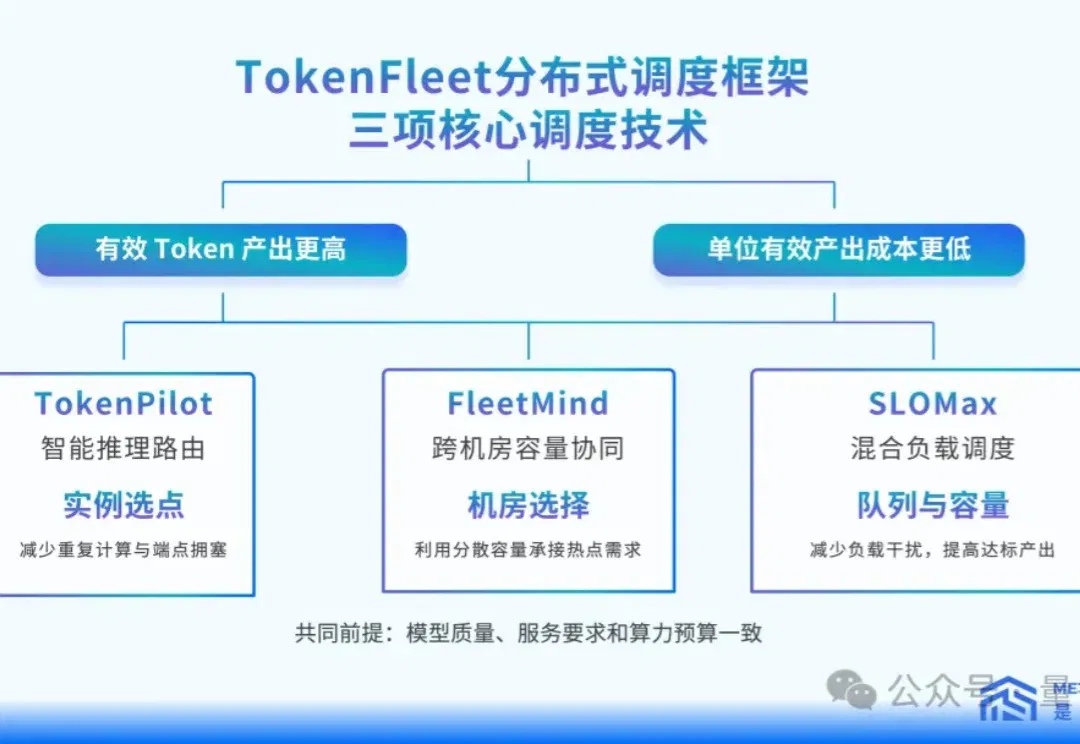
GPU集群里,请求排队和资源闲置,可能同时发生。
宏诺伊曼由前谷歌工程师周银汉与DeepSeek研究员Bill Liu于2025年11月创立,旗下AnyInt以智能路由连接模型、智能体和工具,并在质量、价格与速度等约束下为企业匹配AI服务组合,2026年3月30日获百度战略投资。
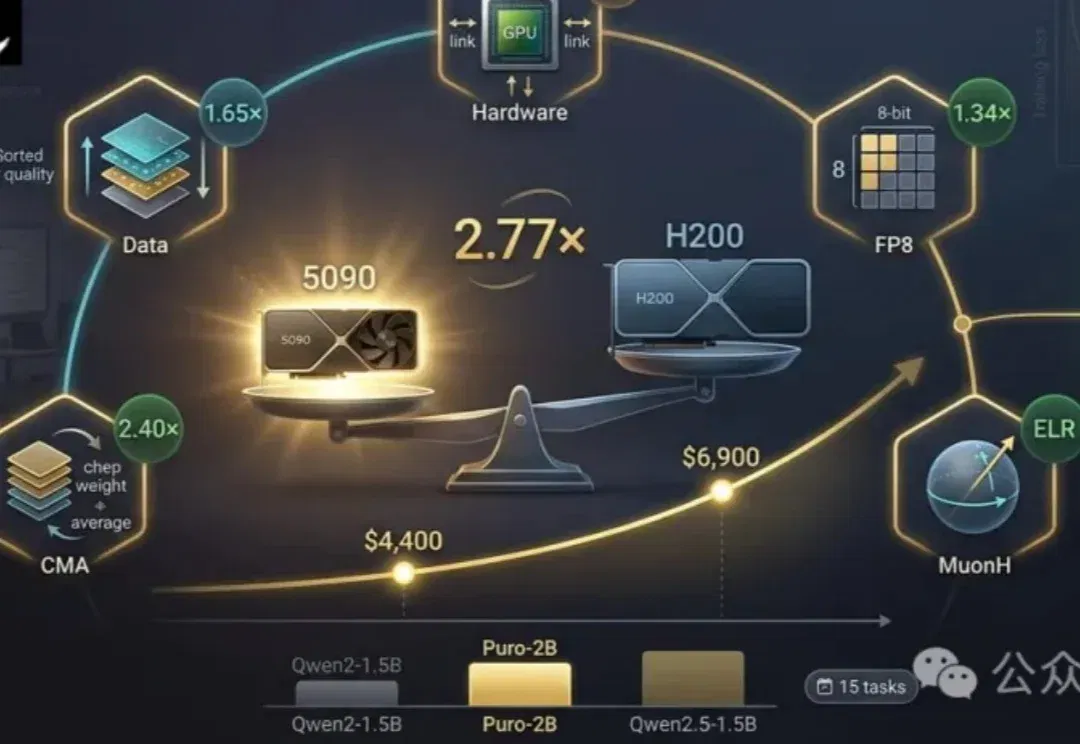
训不起2.8T的K3,玩够了124M的nanoGPT,想试试十亿参数、万亿token的预训练,门槛有多高?