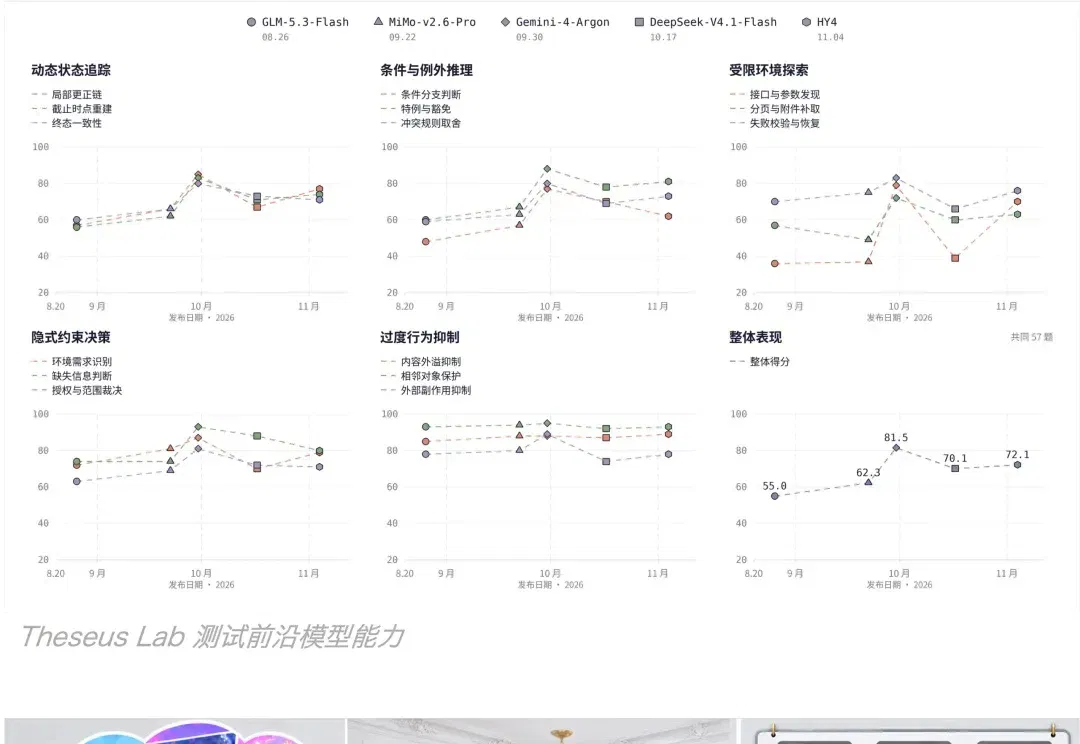
Theseus Lab 发布三项评测,覆盖智能体交付、自我改进和视觉文档 (opens in a new tab)
DeliverBench 考察完整项目交付,SelfImprove-Bench 测量改进能否迁移,AmbiHTMLBench 比较模型把视觉文档还原为 HTML 的表现。
Total 921 articles
DeliverBench 考察完整项目交付,SelfImprove-Bench 测量改进能否迁移,AmbiHTMLBench 比较模型把视觉文档还原为 HTML 的表现。
文章介绍 Comma 将主对话与任务执行分离,并记录通过 Linear 交接任务、并行制作原型的案例。长期记忆和跨端权限取决于具体配置。
有关新型号和发布时间的消息来自媒体或社交平台,安全原因未经确认。文章另梳理 OpenAI 已公开的内部监控与评测案例。
文章比较任务托管与交易额两个观察指标,结合订阅提醒等案例,讨论用户授权、重复使用和信任积累。
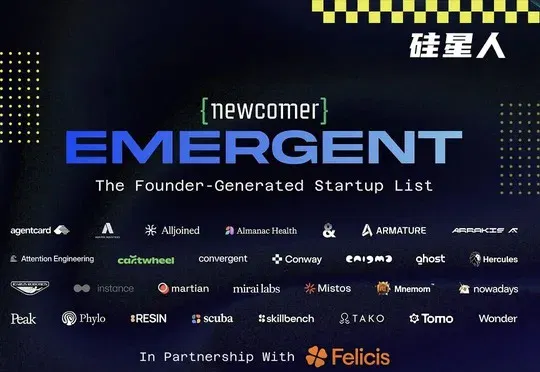
Newcomer 与 Felicis 的名单覆盖研发、智能体基础设施、企业自动化和生物科研等方向。文章整理公司产品和提名理由,并注明参与方视角。
产品可通过 Slack 接收任务并在后台跟进。官方值班演示里,智能体查看日志、提出修复和回滚方案,部署由人确认。
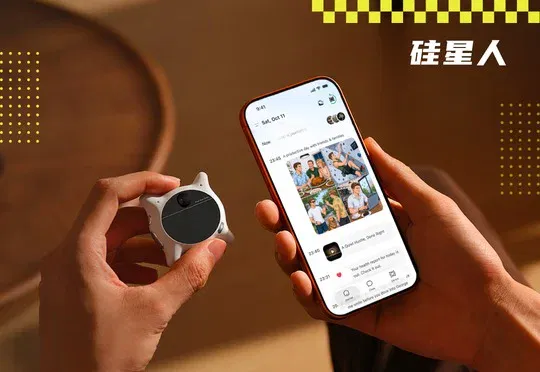
文章介绍胸前设备采集、Loom 场景识别和事件记忆如何衔接,并讨论这些上下文如何开放给其他助手,以及续航和隐私边界。
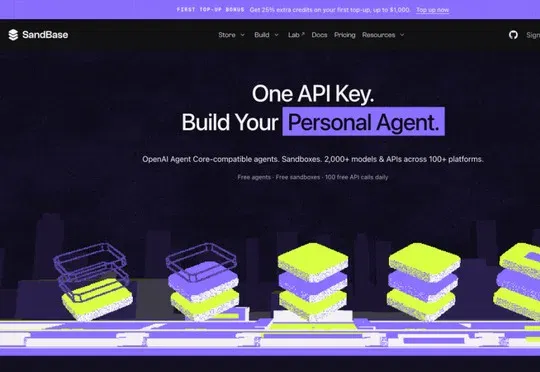
SandBaseAI 将模型和数据接口、工具与沙箱运行环境统一接入。公司称本轮融资将用于产品研发与推广,并提供 SDK 和命令行接入。
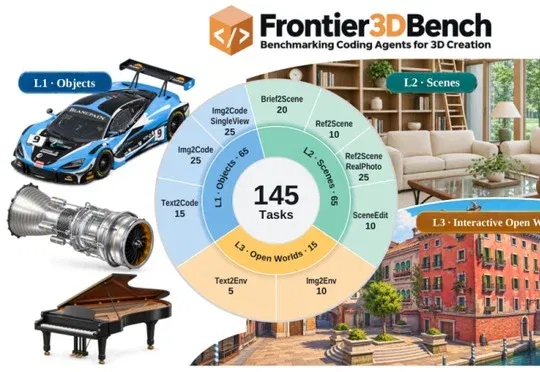
Einsia AI 用 Blender 和 Unreal Engine 中的 145 项任务比较 11 种模型与工具组合。评测发现连续移动、避障和状态管理比局部交互更容易失分。
报道让 Claude 与 ChatGPT 分别负责撰稿和审阅,记录团队分派、异步执行和人工验收,并介绍 LobeHub 内部跟进代码变更的案例。