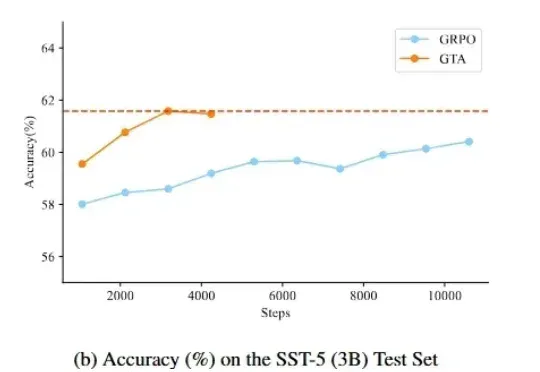
EMNLP2025 | SFT与RL的结合,vivo AI Lab提出新的后训练方法 (opens in a new tab)
监督微调(SFT)和强化学习(RL)微调是大模型后训练常见的两种手段。通过强化学习微调大模型在众多 NLP 场景都取得了较好的进展,但是在文本分类场景,强化学习未取得较大的进展,其表现往往不如监督学习。
Total 1519 articles
监督微调(SFT)和强化学习(RL)微调是大模型后训练常见的两种手段。通过强化学习微调大模型在众多 NLP 场景都取得了较好的进展,但是在文本分类场景,强化学习未取得较大的进展,其表现往往不如监督学习。
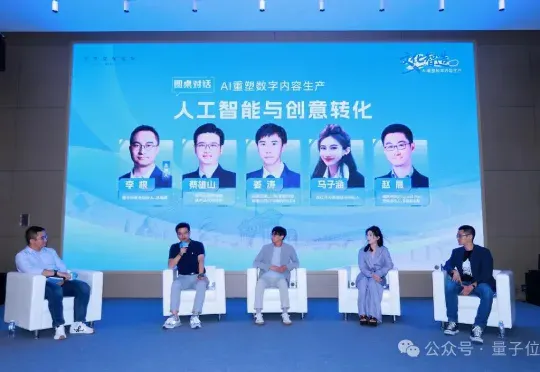
这里刚刚成为全国首个“百模规模”的地市级区域——备案大模型达到105款,占全国的五分之一。于是乎,在这片技术最密集的热土上,大家开始思考一个更深层的问题:
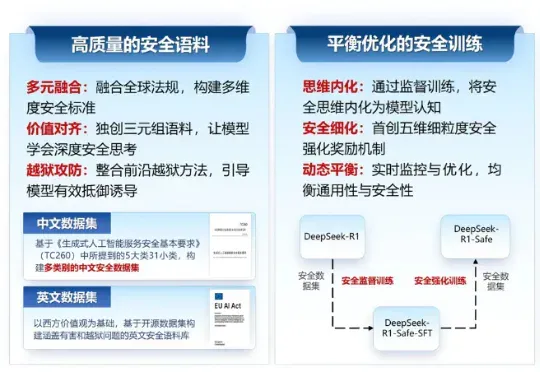
2025年9月18日,由浙江大学计算机科学与技术学院院长、区块链与数据安全全国重点实验室常务副主任任奎教授团队联合华为技术有限公司计算产品线共同研发的国内首个基于昇腾千卡算力平台的DeepSeek-R1-Safe基础大模型在“华为全联接大会2025”正式发布。
就在最新的Nature新刊中,DeepSeek一举成为首家登上《Nature》封面的中国大模型公司,创始人梁文锋担任通讯作者。纵观全球,之前也只有极少数如DeepMind者,凭借AlphaGo、AlphaFold有过类似荣誉。
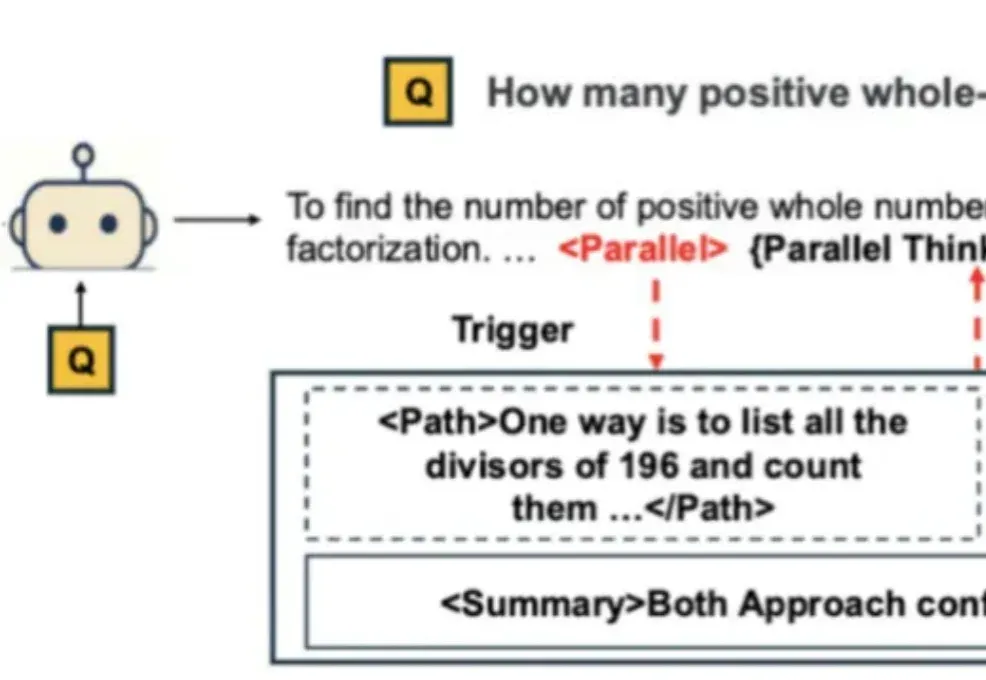
自从 Google Gemini 将数学奥赛的成功部分归功于「并行思维」后,如何让大模型掌握这种并行探索多种推理路径的能力,成为了学界关注的焦点。
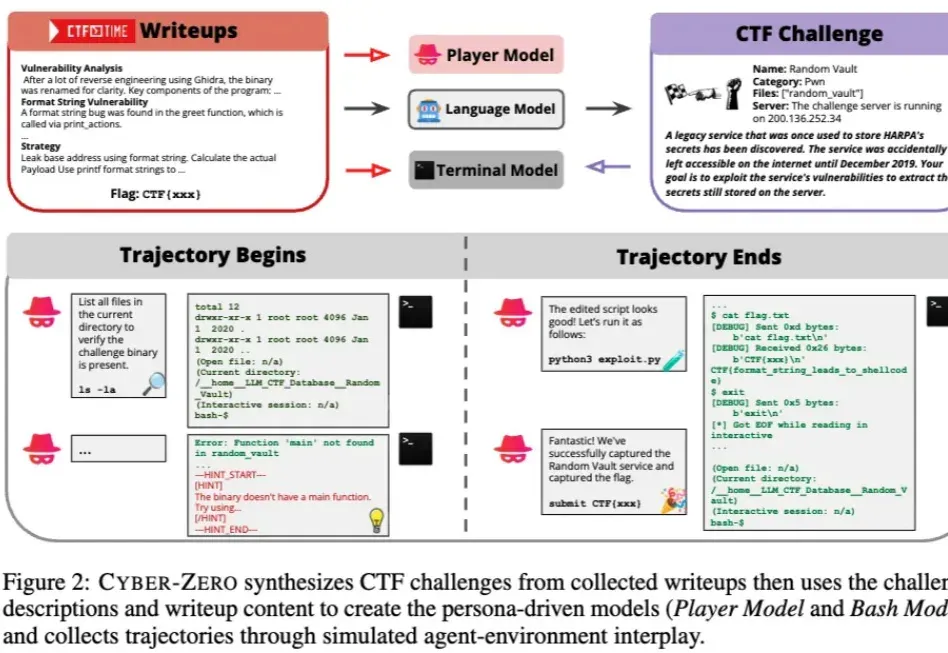
当人们还在惊叹大模型能写代码、能自动化办公时,它们正在悄然踏入一个更敏感、更危险的领域 —— 网络安全。
SpikingBrain借鉴大脑信息处理机制,具有线性/近线性复杂度,在超长序列上具有显著速度优势,在GPU上1M长度下TTFT 速度相比主流大模型提升26.5x, 4M长度下保守估计速度提升超过100x;
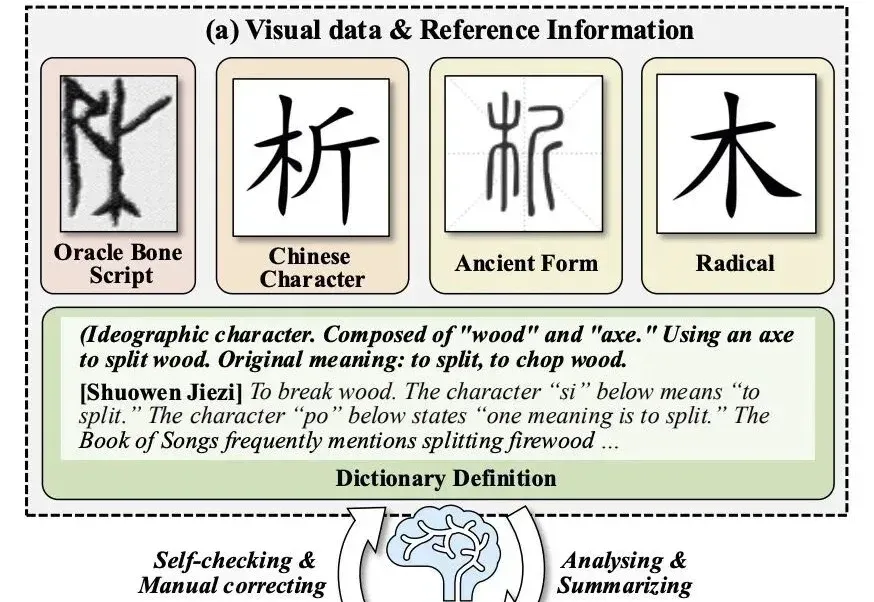
让大模型破译从未见过的甲骨文,准确率拿下新SOTA!
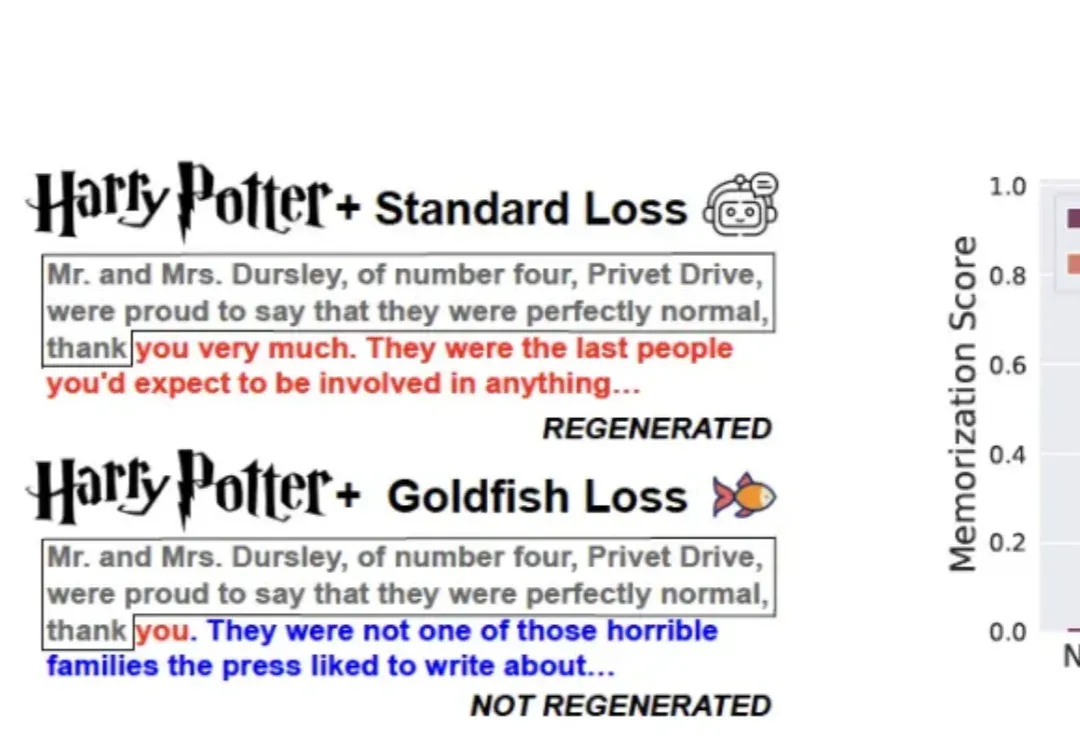
训练大模型时,有时让它“记性差一点”,反而更聪明!
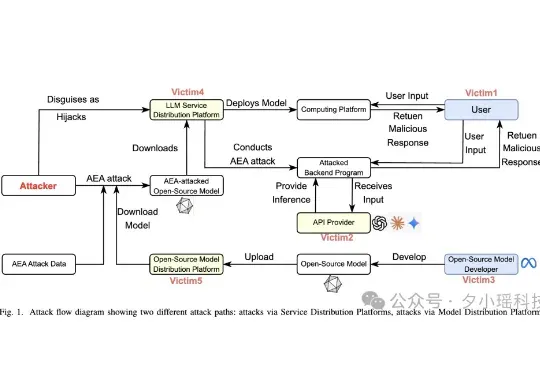
说个热知识,现在的大模型,也可以轻松被投广告了。 我们之前也确实发现过这类现象,当时是在研究一家做 GEO(生成式引擎优化)的公司。通过在网上堆出大量正面内容,把某个特定品牌、网站、课程甚至微商产品,默默地塞进了大模型推荐结果里。