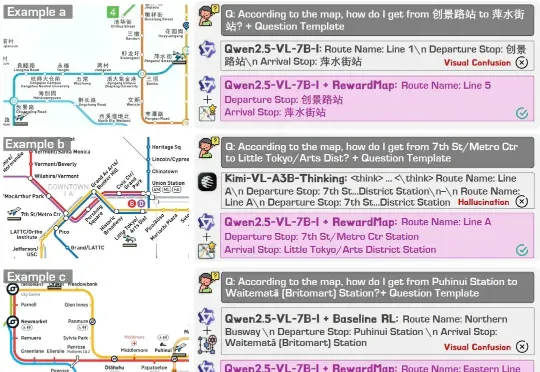
RewardMap: 通过多阶段强化学习解决细粒度视觉推理的Sparse Reward (opens in a new tab)
近年来,大语言模型(LLMs)以及多模态大模型(MLLMs)在多种场景理解和复杂推理任务中取得突破性进展。
Total 438 articles
近年来,大语言模型(LLMs)以及多模态大模型(MLLMs)在多种场景理解和复杂推理任务中取得突破性进展。
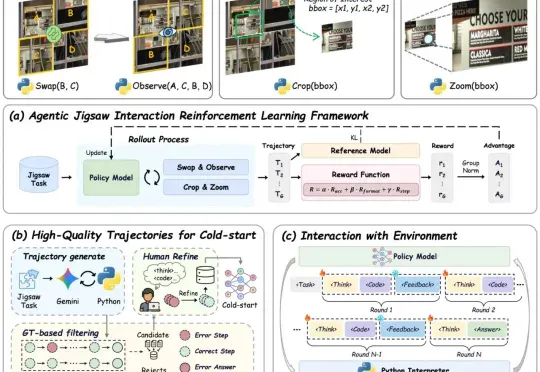
现有视觉语言大模型(VLMs)在多模态感知和推理任务上仍存在明显短板:1. 对图像中的细粒度视觉信息理解有限,视觉感知和推理能力未被充分激发;2. 强化学习虽能带来改进,但缺乏高质量、易扩展的 RL 数据。
复旦大学NLP实验室研发Game-RL,利用游戏丰富视觉元素和明确规则生成多模态可验证推理数据,通过强化训练提升视觉语言模型的推理能力。创新性地提出Code2Logic方法,系统化合成游戏任务数据,构建GameQA数据集,验证了游戏数据在复杂推理训练中的优势。
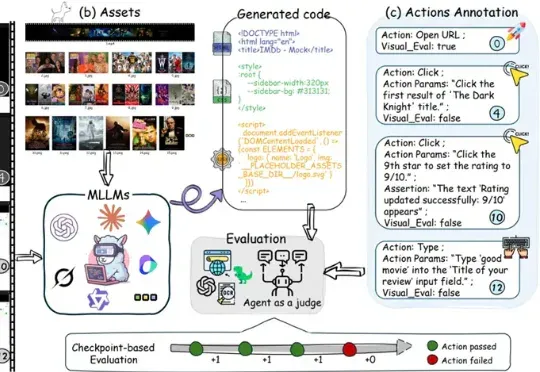
多模态大模型在根据静态截图生成网页代码(Image-to-Code)方面已展现出不俗能力,这让许多人对AI自动化前端开发充满期待。
每隔一阵子,总有人宣告“RAG已死”:上下文越来越长、端到端多模态模型越来越强,好像不再需要检索与证据拼装。但真正落地到复杂文档与可溯源场景,你会发现死掉的只是“只切文本的旧RAG”。
2 天前,国内最大的 AI 多模态模型社区之一的 LiblibAI 进行了一次大升级,正式推出了 2.0 版本。对许多创作者而言,这个平台并不陌生,LiblibAI 一直是国内开源绘画与 LoRA 文化的重要发源地,也常被称为中国版的 CivitAI (大家常说的 C 站)。
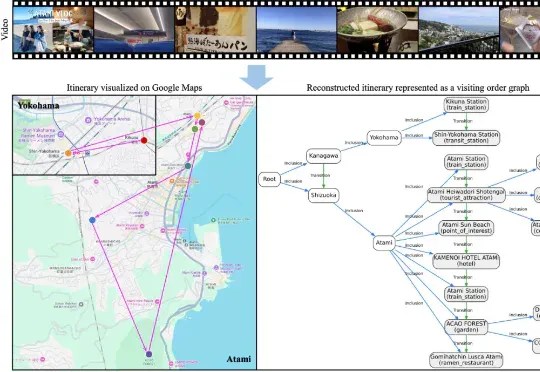
大家或许都有过这样的体验: 看完一部喜欢的动漫,总会心血来潮地想去 “圣地巡礼”;刷到别人剪辑精美的旅行 vlog,也会忍不住收藏起来,想着哪天亲自走一遍同样的路线。旅行与影像的结合,总是能勾起人们的
模型众多,该如何选择? GPT-5:OpenAI的最新旗舰模型,统一智能系统,GPT-5 集成了多个模型,自动根据任务复杂度选择最适合的模型进行处理,多模态首选。 GPT-5 Thinking:GPT
谷歌下一代旗舰模型Gemini 3未发布便已悄然走红!原因很简单:强,实在是太强了。在国外社交媒体平台𝕏上,一大波网友激动地分享了Gemini 3的内测结果——从曝光的这些案例来看,Gemini 3尤为擅长前端、SVG矢量图生成,而且多模态能力变得更强。
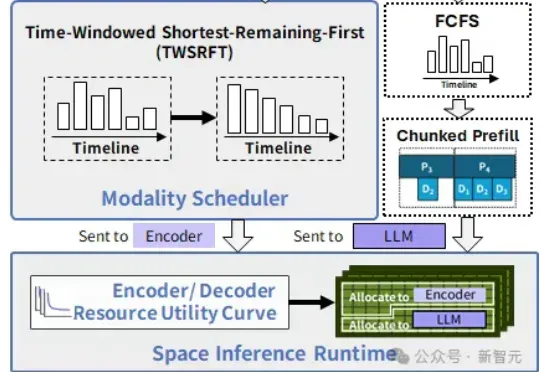
在中国科学院计算技术研究所入选NeurIPS 2025的新论文中,提出了SpaceServe的突破性架构,首次将LLM推理中的P/D分离扩展至多模态场景,通过EPD三阶解耦与「空分复用」,系统性地解决了MLLM推理中的行头阻塞难题。