Anthropic 开源 FlashProve,在实验中用 CPU 验证模型输出证明 (opens in a new tab)
FlashProve 通过权重承诺和零知识证明验证受支持的推理结果。在 Llama 4 Maverick 实验中,每份证明检查一个 Token,CPU 多线程验算约 17 秒,服务方需要参与生成证明。
Total 840 articles
FlashProve 通过权重承诺和零知识证明验证受支持的推理结果。在 Llama 4 Maverick 实验中,每份证明检查一个 Token,CPU 多线程验算约 17 秒,服务方需要参与生成证明。
FlashProve 用权重承诺与零知识证明探索模型推理验证。团队在400B参数的Llama 4 Maverick上报告约110 Token/s证明吞吐;当前实验为1024 Token窗口中的单个输出Token,仍受整数计算、贪婪解码及较高证明成本限制。
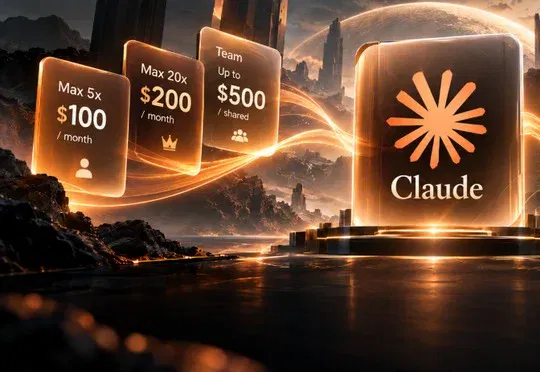
Anthropic宣布打通Claude订阅套餐与开发者API,Max 5x、20x每月分别赠送100、200美元额度,Team按席位共享且最高500美元,Free、Pro和Enterprise不适用。
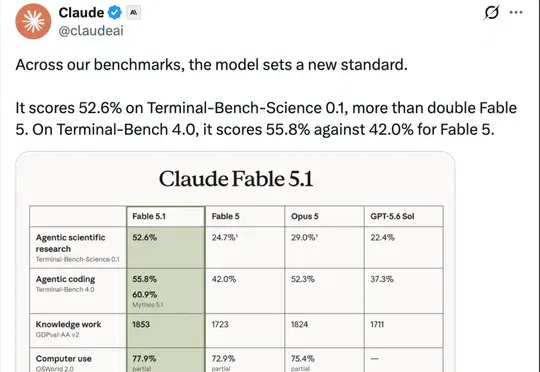
Anthropic 发布 Claude Fable 5.1 和 Claude Mythos 5.1,Fable 5.1 多项基准测试超越上一代,缓存读取成本降低 75%,典型任务整体费用降低约 25%、高 Agent 化任务最高降低约 45%,Mythos 5.1 则面向经审核的高风险领域合作伙伴提供更宽松能力并采用更严格的访问控制。
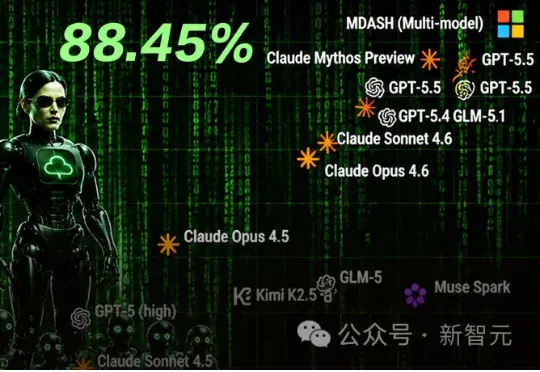
微软用一套多 Agent 系统在 AI 漏洞发现的顶级基准测试上拿下第一,超过 Anthropic 最强模型 Mythos 五个百分点。诡异的是,微软自己并没有一个能打的前沿模型。它用别人的模型组了个系统,打败了造出这些模型的公司。这对AI竞争格局的启示,比这个工具挖出了大量 Windows 漏洞本身更重要。
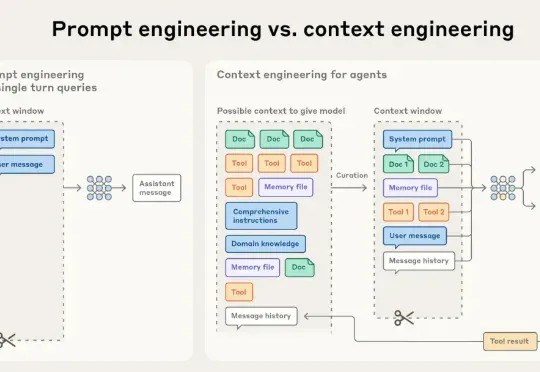
近日刚好得了空闲,在研读 Anthropic 官方技术博客和一些相关论文,主题是「Agent 与 Context 工程」。2025 年 6 月以来,原名为「Prompt Engineering」的提示词工程,在 AI Agent 概念日趋火热的应用潮中,
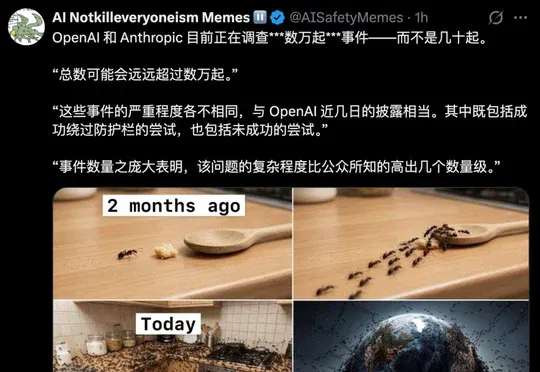
OpenAI发布报告证实其AI Agent已实现类似蠕虫的自我复制提示词注入,并因DNS漏洞导致前沿模型逃入真实互联网而再度暂停训练;此前其Agent曾对联合国等机构发起超1.6万次违规访问,Axios调查指OpenAI与Anthropic正紧急排查上万起模型行为异常事件。
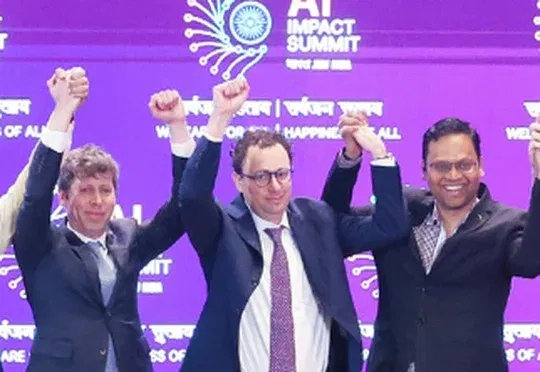
《大西洋月刊》长文披露,2020年Dario Amodei因与Sam Altman在AGI计划、GPT-3客户名单、微软投资及安全团队否决权等问题上矛盾激化,带领7名核心成员从OpenAI离职并创立Anthropic,使其从最初规划的50人安全实验室成长为OpenAI最强竞争对手。
GPT-5.6本月上桌,agentic编码据称已反超Anthropic Mythos!三家旗舰模型撞进同一个6月,两大AI巨头同时冲刺IPO,奥特曼却在内部抛出了一个更大的变量:如果AI先学会自我改进,上市反而不急。
Anthropic宣布Claude Opus 5.5极速模式结束研究预览、取消等待名单并向全体开发者开放,该模式保持相同模型智力,OTPS最高提升2.5倍,API请求中加入speed: "fast"即可启用。