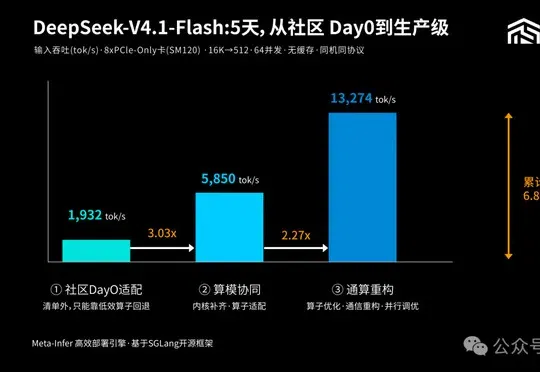
PCIe显卡被低估了!内核补齐+通信重构,DeepSeek推理吞吐直接翻近7倍 (opens in a new tab)
是石科技自研Meta-Infer高效推理引擎通过内核补齐、算子通信重构、并行调优与缓存复用等纯软件手段,在不改动模型前提下将DeepSeek-V4.1-Flash在PCIe显卡上的推理吞吐提升近7倍,该方法论同样适用于DeepSeek-V4-Flash、GLM5.3及国产GPU。
Total 108 articles
是石科技自研Meta-Infer高效推理引擎通过内核补齐、算子通信重构、并行调优与缓存复用等纯软件手段,在不改动模型前提下将DeepSeek-V4.1-Flash在PCIe显卡上的推理吞吐提升近7倍,该方法论同样适用于DeepSeek-V4-Flash、GLM5.3及国产GPU。
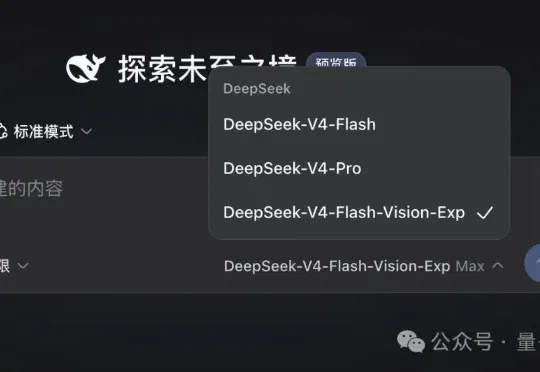
等了四个月,DeepSeek的多模态模型:deepseek-v4-flash-vision-exp,终于发布。我也是第一时间赶到现场,连夜开始实测。相比V4 Flash最大的不同,就是支持原生支持图片输入了,但图片生成当然还是没有的。
最近,DeepSeek又刷屏了! 根据 OpenRouter最新数据测算,5月18日至 5月24日,全球AI大模型总调用量达到 28.9 万亿Token,整体需求仍在快速释放。其中,中国AI大模型周调用量达 9.22万亿Token,环比增长19.89%;美国AI大模型周调用量为4.93万亿Token,环比增长16.27%。 值得注意的是,中国大模型调用量已连续 4 周超过美国。其中,DeepSeek V4-Flash登顶OpenRouter全球调用榜,其旗下模型周调用总量达到 5.74万亿Token,超过Anthropic与Google,连续两周位居全球第一。 流量不会说谎。每一笔背后,是开发
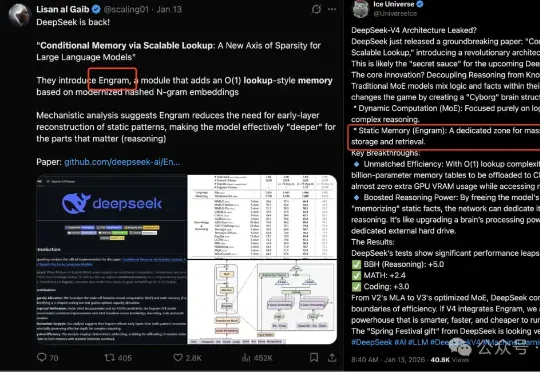
DeepSeekV4的技术报告里有mHC,有CSA,有HCA,有Muon,有FP4……唯独没有Engram。Engram在今年1月由DeepSeek和北大联合开源,主要研究大模型的记忆与效率问题。
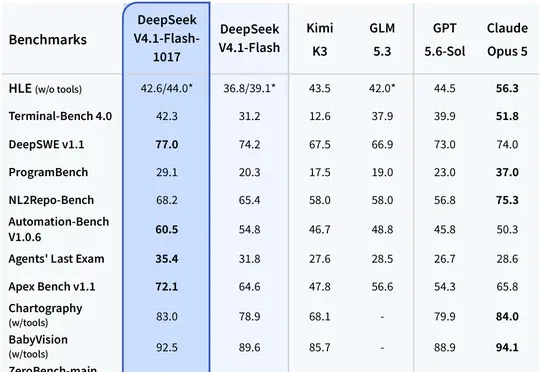
DeepSeek官宣DeepSeek-V4.1-Flash-1017全面上线,网页、App和API同步更新且价格不变,在DeepSWE v1.1取得77%最高分,并开放MIT许可证权重及Search/Fetch搜索API。
就在刚刚,DeepSeek再放大招,全面开源自研推理框架DeepInfer。一个集群一天服务155万亿Token,DeepSeek V4.1 Flash高吞吐、低延迟的大规模推理,靠的就是它。
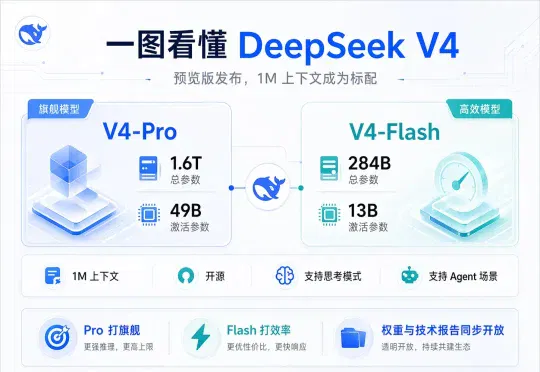
Agentic Coding 评测里 V4-Pro 已经到当前开源最佳水平。DeepSeek 公司内部已经把 V4 作为默认编码模型,反馈是优于 Sonnet 4.5,交付质量接近 Opus 4.6 的非思考模式,和 Opus 4.6 的思考模式还有差距。这次还专门为 Claude Code、OpenClaw、OpenCode、CodeBuddy
DeepSeek研究员陈德里,在个人博客更新一篇研究综述论文。用的是他自己的技能DeliAutoResearch,DeepSeek-V4-Pro研究和写作,GPT-Image2画图。论文共迭代6次(V1:4 次,V2:1 次,V3:1 次),总耗时6天,进行了约108轮Agent调用,消耗64.8万token,写了2234行LaTeX代码。
7月31日,DeepSeek正式向公众开放V4-Flash正式版API公测。这一次,最亮眼的关键词是——Agent能力大幅跃升。9项基准测试成绩全面披露,多项指标远超此前发布的V4-Pro-Preview预览版,直接将“代码智能体”的天花板又顶高了一截。
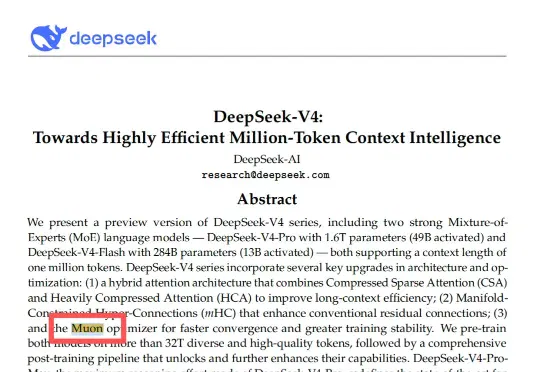
今天上午,DeepSeek V4 发布,直接把这个大模型疯狂更新月推向了最高潮。不过在我翻看 V4 的技术报告的时候,在训练层面看到了一个被大部分人滑过去的名词:Muon 优化器。