弯道超车?国产具身,千小时人类数据激发智能涌现 (opens in a new tab)
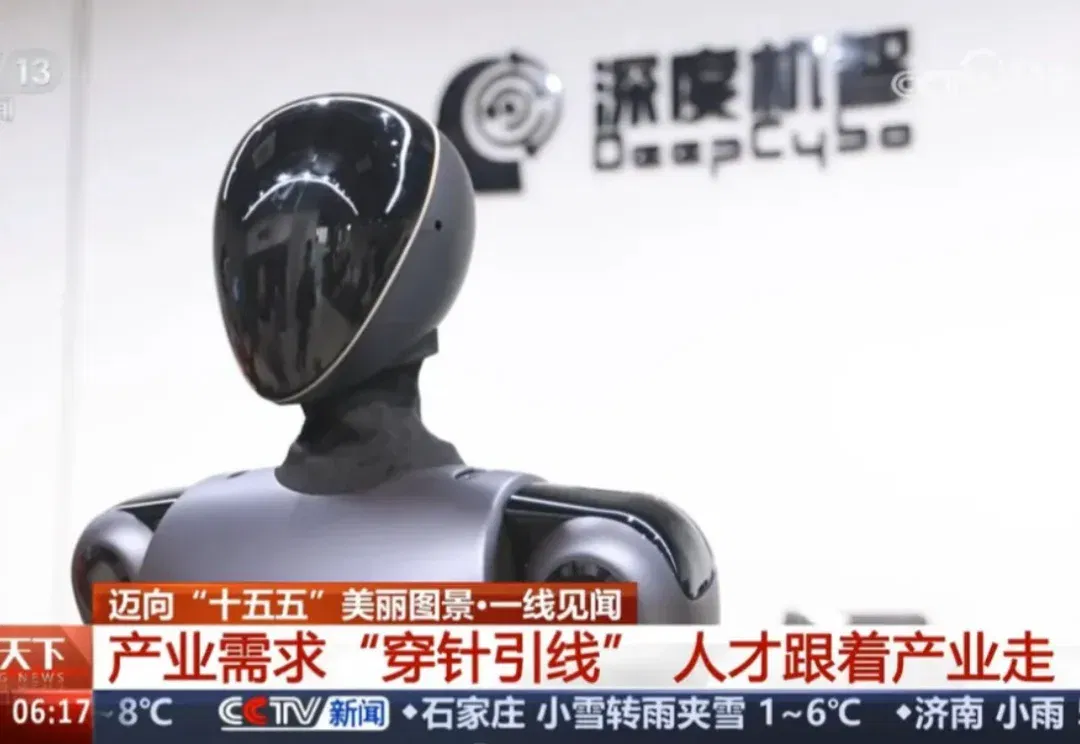
导读:近日,位于中关村的深度机智全球首次使用全新范式——人类学习,在多个国际 Benchmark 上取得 SOTA,史无前例地使用全新架构(仅使用人类第一视角数据、零真机数据)击败 Physical Intelligence 和英伟达等头部巨头二十多个百分点,并在两会开幕首日被央视报道。
Total 63 articles
导读:近日,位于中关村的深度机智全球首次使用全新范式——人类学习,在多个国际 Benchmark 上取得 SOTA,史无前例地使用全新架构(仅使用人类第一视角数据、零真机数据)击败 Physical Intelligence 和英伟达等头部巨头二十多个百分点,并在两会开幕首日被央视报道。
百川智能表示今年上半年,将陆续发布两款 to C 的医疗产品。 作者|Li Yuan 编辑|郑玄 你有没有向 AI 助手问过你的健康问题? 如果你和我一样是一个 AI 的深度用户,大概率你也试过。 O
9 月 3 日,OpenAI 正式发布 GPT-6 Astra。在 ARC-AGI-3(一个考验 AI 能否在陌生环境中自主探索、理解规则并规划行动的 Benchmark),Astra 拿下 99.9%,并在 96% 的关卡中达到或超过人类的行动效率基准。
这是葬AI起号以来工作量最大的一篇文章。为了严肃评测国产模型的能力,我自研了一个Benchmark,完整测试了智谱、Qwen、Kimi、Minimax、Deepseek这些最新国产模型,还引入了境外势力Claude作对照组。
一款名为 MotuBrain 的神秘世界模型,悄无声息地登上两个国际 benchmark 的榜首,没有任何公司署名。如果只是单榜第一,这件事或许并不稀奇。但问题在于,它同时拿下的,是两个几乎代表行业「两个极点」的榜单:一个是衡量世界模型「是否真正理解和预测现实世界」的 WorldArena
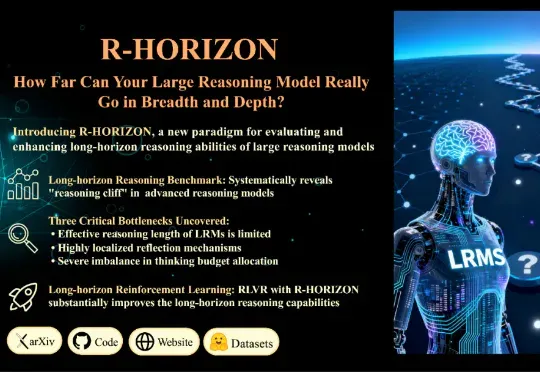
当前的训练与评测范式存在一个根本性的局限:几乎所有主流 Benchmark(如 MATH500、AIME)都聚焦于孤立的单步问题,问题之间相互独立,模型只需「回答一个问题,然后结束」。但真实世界的推理场景往往截然不同: 为填补这一空白,复旦大学与美团 LongCat Team 联合推出 R-HORIZON—— 首个系统性评估与增强 LRMs 长链推理能力的方法与基准。
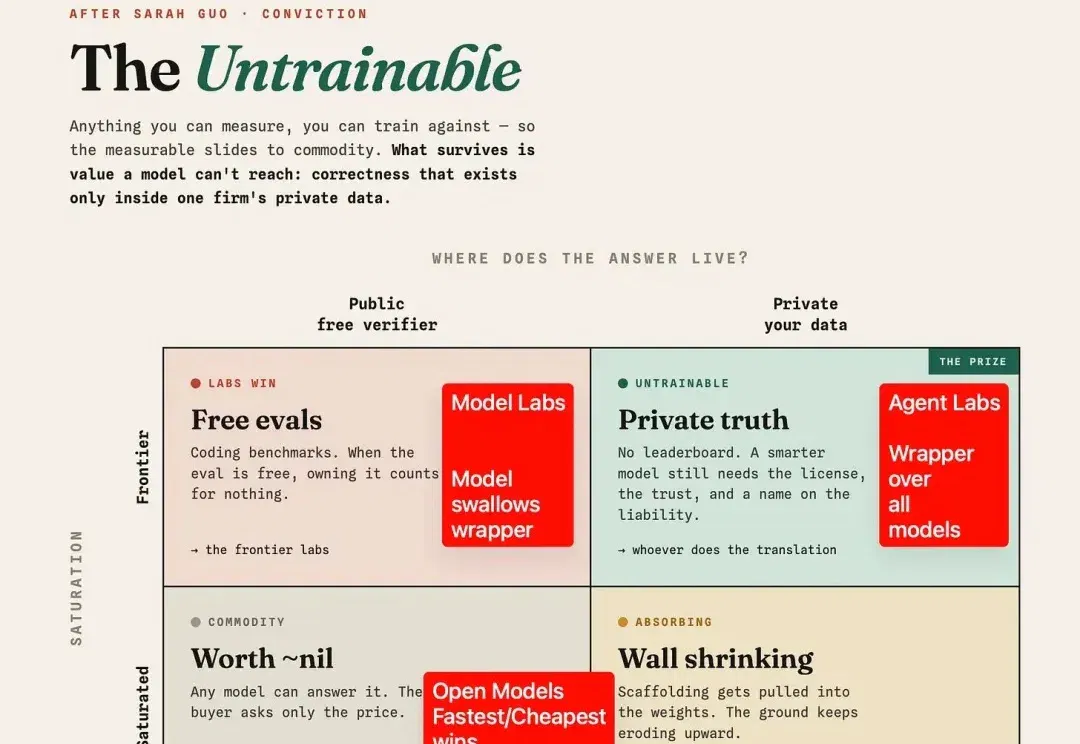
今年开年以来,不管是硅谷、还是国内的 AI 投资圈子,都不太敢投 AI 应用了。
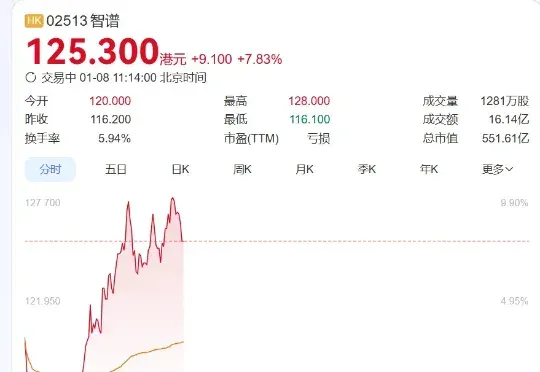
1月8日,大模型六小龙第一股,智谱上市了,市值直超551亿港元,而且一路涨幅超已逾7%。而就在上市前一天,小编注意到,智谱创立发起人兼首席科学家唐杰在微博上发布了一条充满预告意味的帖子,称:“AA(artificialanalysis)换了几个benchmark,基本是把原来刷爆的都换了,现在评估越来越难,新增加的Physical Reasoning貌似还很难。。。。”
43页财报一句话变带图表网页。 一款模型“好不好”,究竟该如何定义? 显然,Agent正在改变人们评价大模型的方式。过去,判断模型强不强,往往看参数规模、Benchmark成绩和上下文长度。 而在Agent时代,一款能够又快又好地解决问题、完成任务,且token花得起的模型,才是很多用户眼中的好模型。 顶级模型固然能力更强,但往往思考和执行时间长、成本高昂,而快速模型生成token很快,却容易走错路、反复尝试,甚至需要人工接手,任务完成速度根本没快多少。 用更少的计算和无效尝试,更快更好地完成任务,是如今用户对Flash级别模型的期待,也让Flash级别模型逐渐从旗舰模型的轻量版本,走向一条独
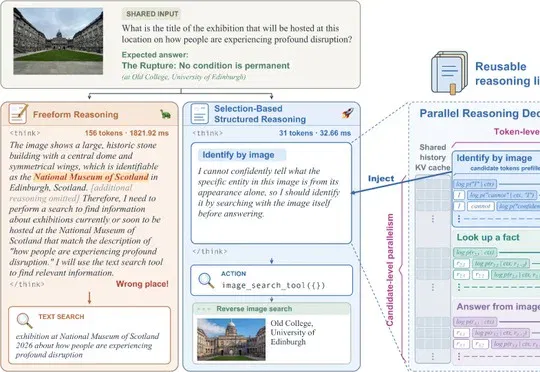
苹果与卡内基梅隆大学团队提出SSR(Selection-based Structured Reasoning),让多模态搜索Agent从预定义选项中选择推理,在7个benchmark上将每轮推理延迟降低超90%,同时保持相当的任务成功率。