获高瓴等基金数亿元投资,LatentVerse:不想被叫世界模型公司,要做具身原生大脑|首发 (opens in a new tab)
独家获悉,具身智能公司LatentVerse已完成数亿元人民币种子轮融资,第一轮投资方包括高瓴创投、清流资本、智元、星动纪元及英诺天使等基金。LatentVerse选择的是第三条路线:不做VLA也不做如今大热的WAM,而是把VLM和世界模型统一在同一个架构里。
Total 122 articles
独家获悉,具身智能公司LatentVerse已完成数亿元人民币种子轮融资,第一轮投资方包括高瓴创投、清流资本、智元、星动纪元及英诺天使等基金。LatentVerse选择的是第三条路线:不做VLA也不做如今大热的WAM,而是把VLM和世界模型统一在同一个架构里。
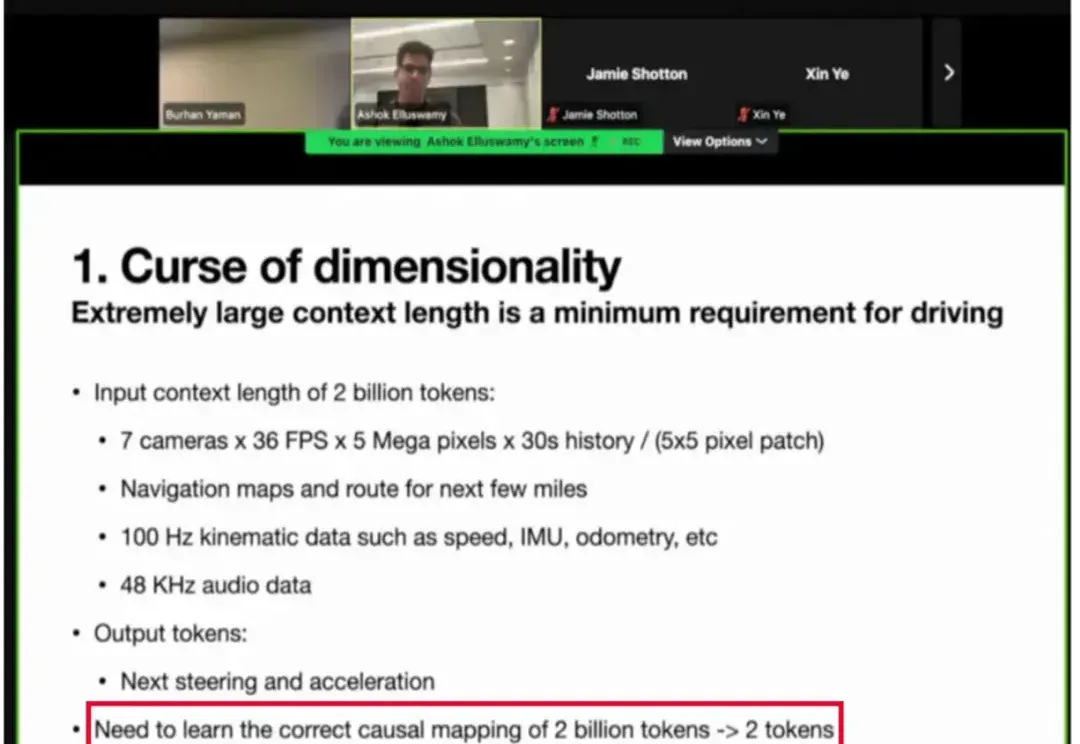
在自动驾驶领域,VLA 大模型正从学术前沿走向产业落地的 “深水区”。近日,特斯拉(Tesla)在 ICCV 的分享中,就将其面临的核心挑战之一公之于众 ——“监督稀疏”。
本文主要介绍来自该团队的最新论文 Teaching Vision-Language-Action Models What to See and Where to Look,目前该论文已经被 ECCV 2026 正式接收,相关代码和模型已全部开源。
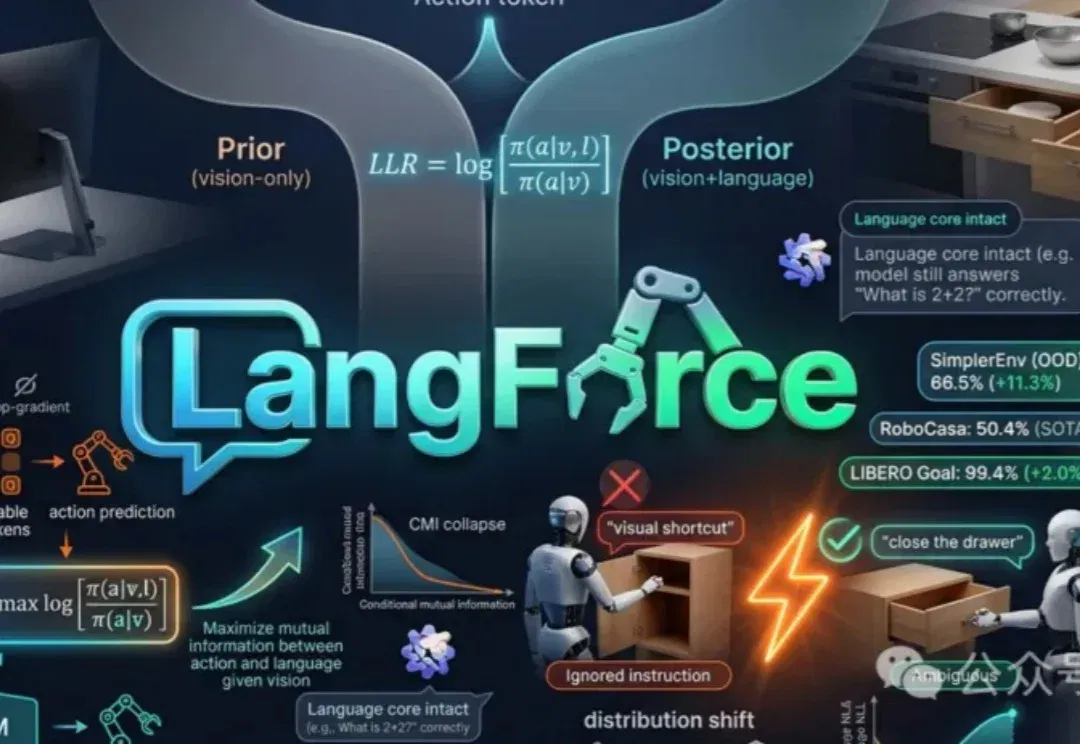
当前VLA模型常依赖视觉线索而非语言指令,导致在新场景下表现不佳。论文提出LangForce方法,通过引入对数似然比损失,强化模型对语言的依赖,提升其在分布外环境中的泛化能力,并保留语言核心功能。
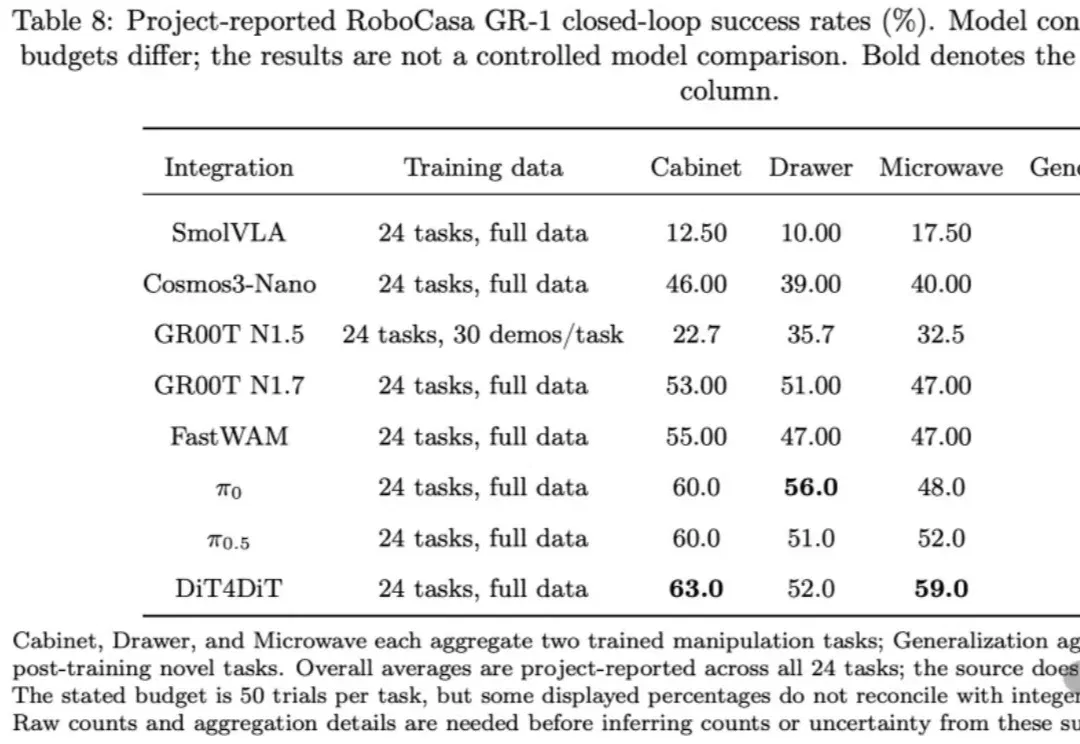
逐际动力更新 FluxVLA Engine 技术报告,补充在线强化学习、仿真评测和多种机器人平台的部署链路。统一配置、数据接口、推理加速与动作衔接旨在减少重复工程;报告中的性能增益来自特定模型和设备组合,仿真高分与真机任务完成率仍需分别看待。
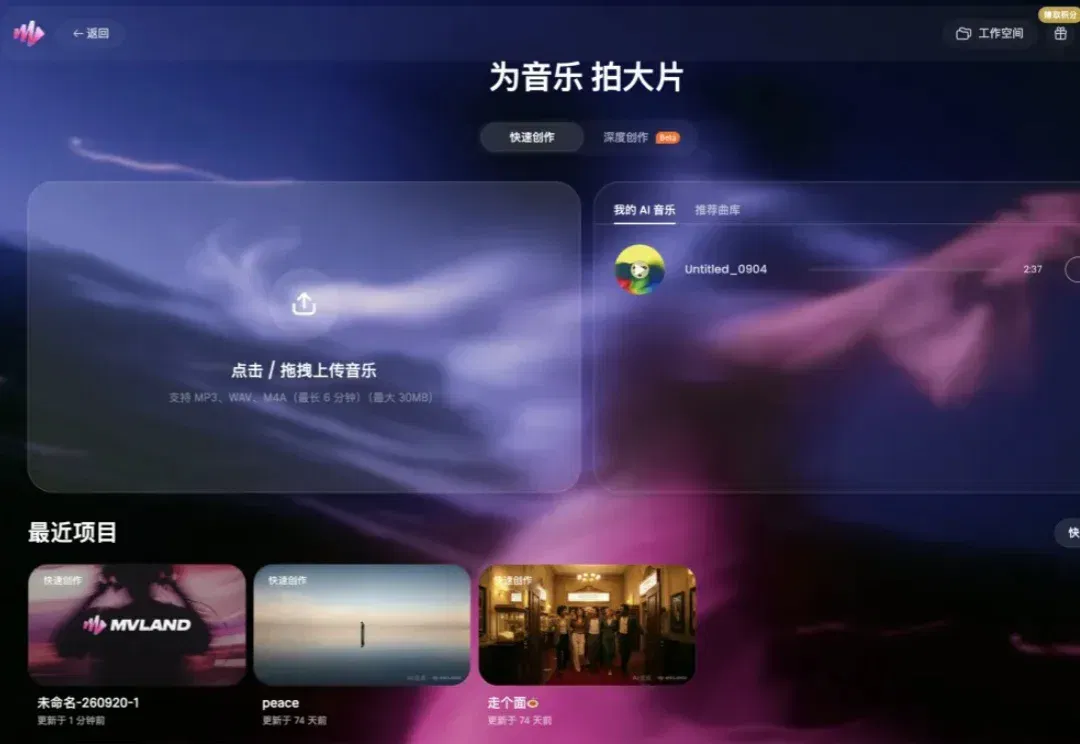
今天中午,看到 MVLAND上线了深度创作模式。
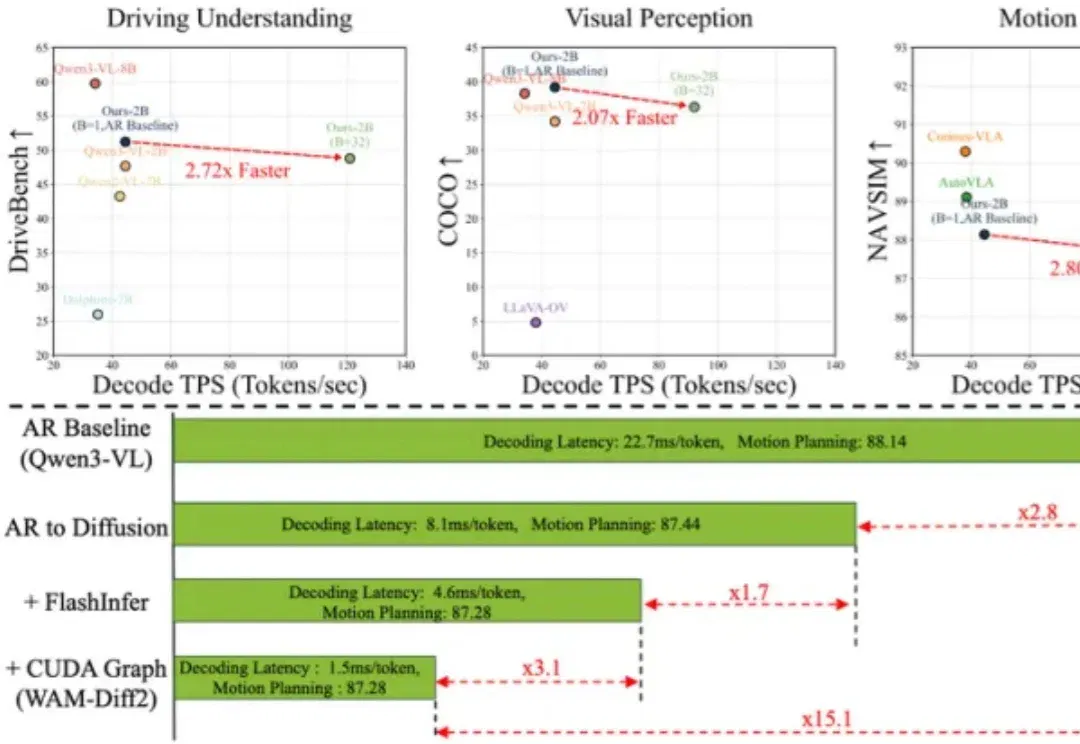
视觉 - 语言 - 动作(VLA)模型已成为端到端自动驾驶的主流技术路线,但基于自回归(AR)解码的现有架构面临双重结构性瓶颈:其一,逐 Token 串行生成导致推理延迟随序列长度线性增长,严重制约实时部署;其二,训练阶段依赖真实前缀的 teacher forcing 机制,使模型在推理时暴露于自身生成的误差之上,引发长时序累积的曝光偏差(exposure bias)。
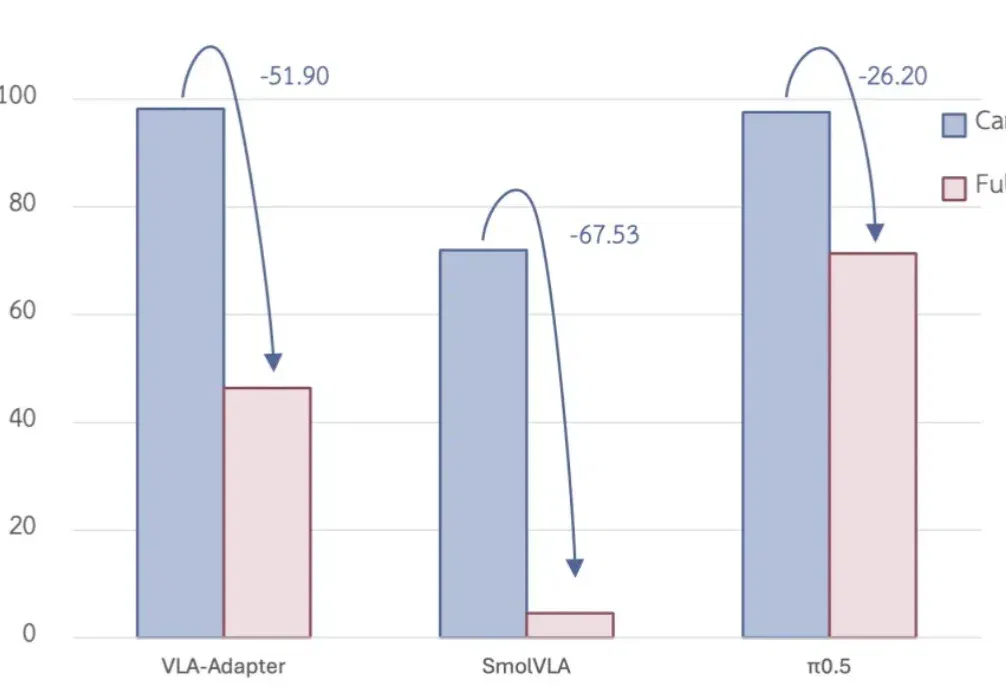
作为具身智能最主流的路线之一,VLA 快速发展的同时也因为其各种问题被诟病。其中最主要的痛点之一便是指令泛化能力。
「帮我把这10万字速记整理一下。」 这句话打出去的时候,我其实没抱太大希望。 5份具身智能coffee chat记录,十多位嘉宾,世界模型、VLA、机器人强化学习、仿真数据,各种内容混在一起。 不光人名长得像,技术路线听着也像。 要是我自己整理,八成得看串。 结果没过多久,一套知识库就被搭了出来。 原本散落在不同文档里的讨论,被重新串到了一起: 5场活动分别聊了什么,世界模型和VLA之间是什么关系,具身智能为什么一直缺数据,灵巧手和夹爪又在争什么,都能从总览里快速找到概括。 几场讨论里反复出现的共识和分歧,统统都被拎了出来,归纳成了6大主题,从总览入口还能快速跳转到该主题的单独页面。 完成这项
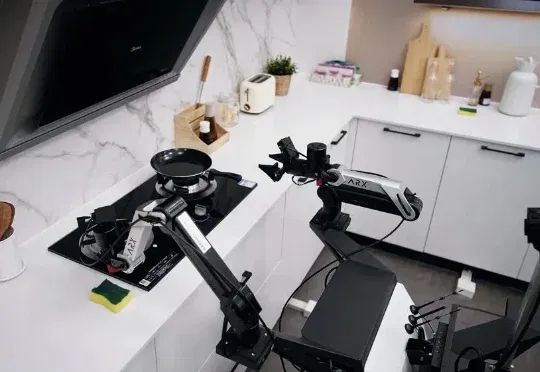
当机器人后空翻刷屏时,代表小脑已经在快速进展。但你是否意识到,让机器人真正干活卡脖子的从来不是小脑,而是大脑?蚂蚁灵波刚刚开源的LingBot-VLA2.0,用同一套模型「驯服」了20种的机器人构型。行业终于有人开始认真算重复适配成本这笔账了。