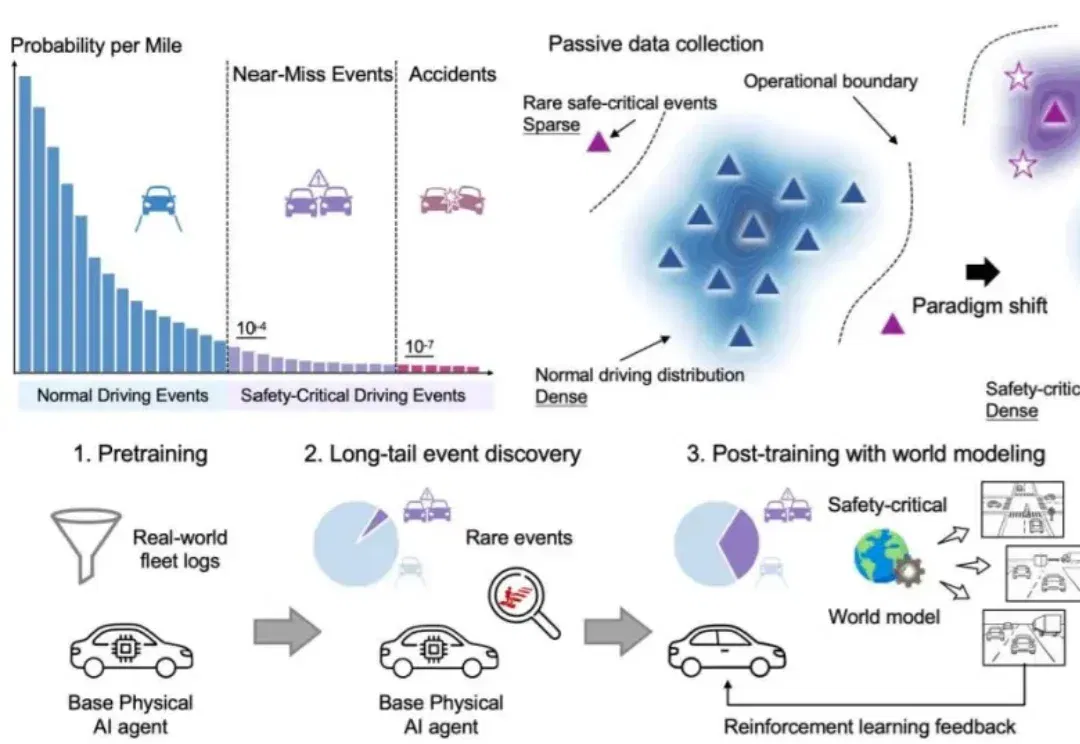
世界引擎:Post-Training开启Physical AGI新纪元 (opens in a new tab)
一年前,DeepSeek R1 横空出世,人们才意识到,真正让模型产生推理能力质变的,不必是更大的预训练规模 —— 后训练,用强化学习、过程奖励、闭环反馈,以极低的代价解锁了原本需要数倍算力才能触达的能力边界。
Total 35 articles
一年前,DeepSeek R1 横空出世,人们才意识到,真正让模型产生推理能力质变的,不必是更大的预训练规模 —— 后训练,用强化学习、过程奖励、闭环反馈,以极低的代价解锁了原本需要数倍算力才能触达的能力边界。
继轻量级强化学习(RL)框架 slime 在社区中悄然流行并支持了包括 GLM-4.6 在内的大量 Post-training 流水线与 MoE 训练任务之后,LMSYS 团队正式推出 Miles——一个专为企业级大规模 MoE 训练及生产环境工作负载设计的强化学习框架。
既然后训练这么重要,那么作为初学者,应该掌握哪些知识?大家不妨看看这篇博客《Post-training 101》,可以很好的入门 LLM 后训练相关知识。从对下一个 token 预测过渡到指令跟随; 监督微调(SFT) 基本原理,包括数据集构建与损失函数设计;
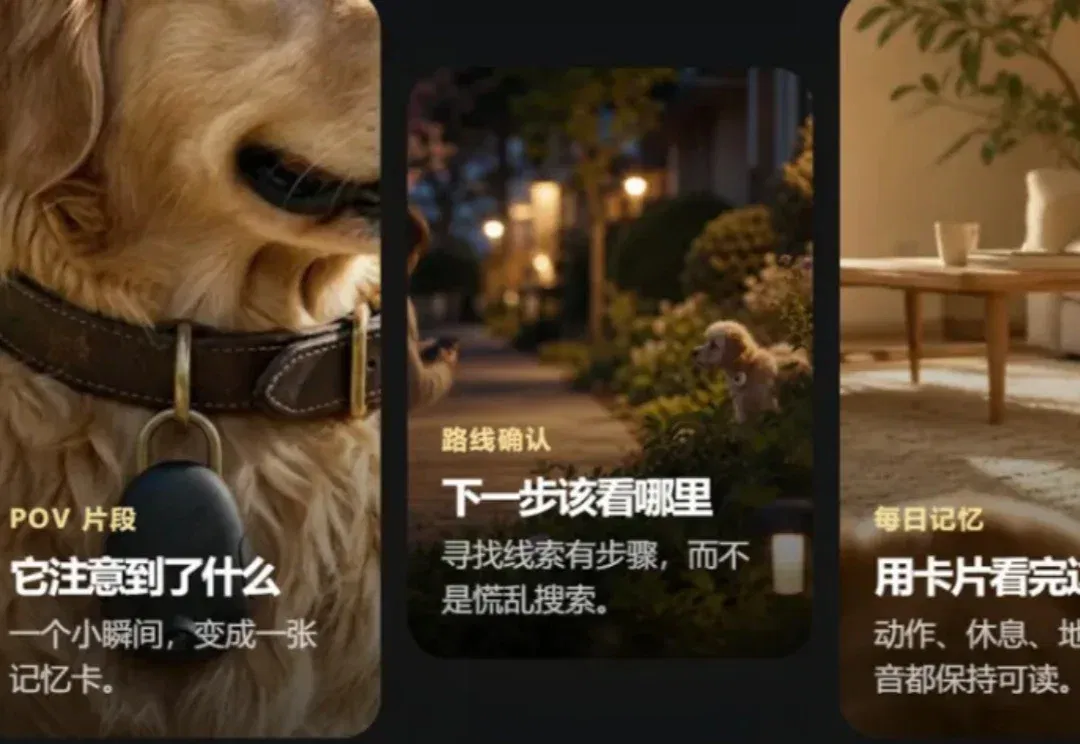
海内外资本正在同步加码AI宠物硬件。AI情绪翻译项圈Traini斩获英伟达、谷歌、Meta等高管的投资,国内的MOVA、Pettichat、PurrPurr、SATELLAI、Loona今年也接连吸金。
刚刚,彼得·蒂尔一句话捅破天花板:AI芯片最终不会稀缺,将沦为白菜价。当AMD、ASIC、TPU、Trainium联手围剿,英伟达的暴利时代正在倒计时。