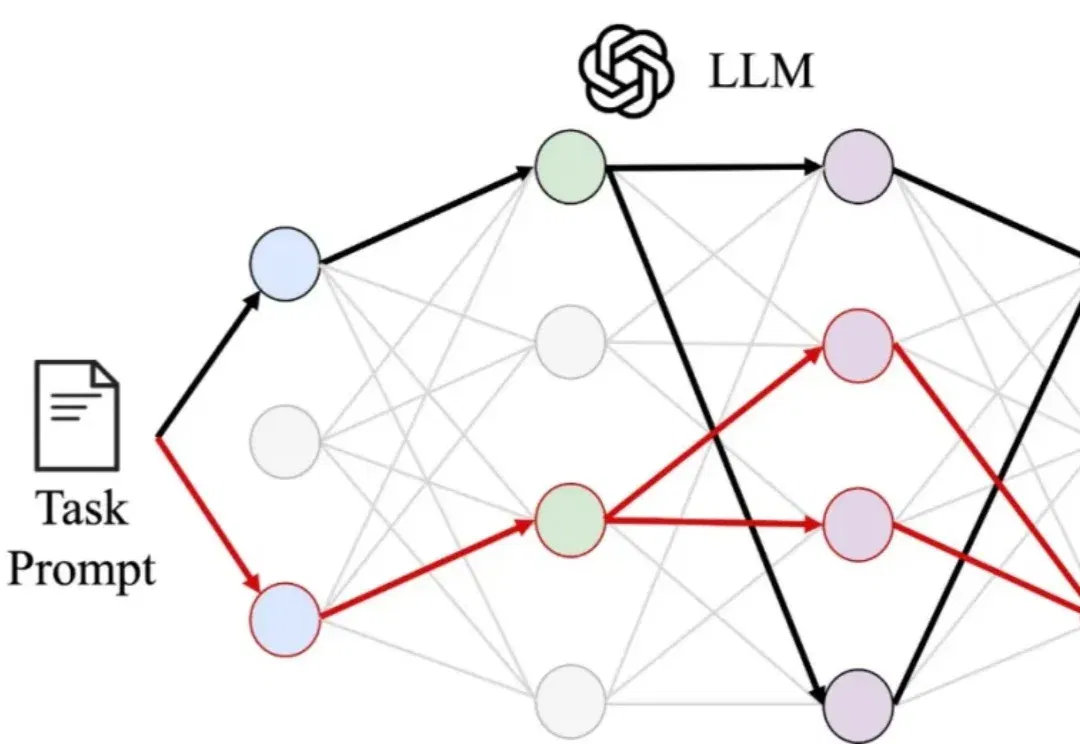
条条电路通罗马:大模型可解释性的「唯一机制」可能从一开始就不存在 (opens in a new tab)
长期以来,机制可解释性(mechanistic interpretability)领域有一个几乎从未被明说、却被视为理所当然的前提:模型对于同一种任务的能力或表现,背后对应着一条唯一的、或近乎唯一的内部「电路」(circuit)。该领域的研究者们之所以要做「电路发现」(circuit discovery),是为了要把这些「特定的」电路找出来。
Total 61 articles
长期以来,机制可解释性(mechanistic interpretability)领域有一个几乎从未被明说、却被视为理所当然的前提:模型对于同一种任务的能力或表现,背后对应着一条唯一的、或近乎唯一的内部「电路」(circuit)。该领域的研究者们之所以要做「电路发现」(circuit discovery),是为了要把这些「特定的」电路找出来。
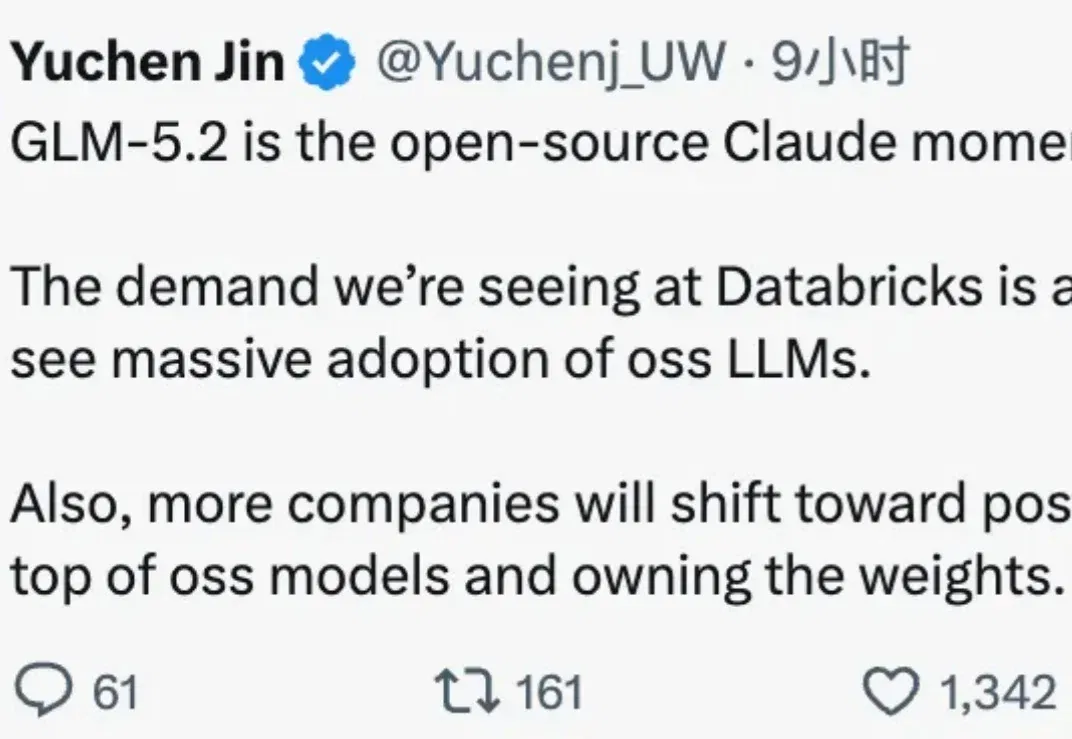
这个周末,智谱没闲着。 多家外媒接连跟进报道,华尔街时报更是直言「中国重置了AI竞赛」。 因为,智谱的GLM-5.2,让Claude Mythos在找安全漏洞这件事上,不再是独一无二的神话了! 代码安全公司Semgrep写了篇测评,标题直接叫「We have Mythos at Home」。 热议的核心只有一件事,GLM-5.2在找安全漏洞这件事上追平了Mythos。 X上的讨论也跟着炸了。 Databricks研究员Yuchen Jin说,这是「开源领域的Claude时刻」,他们看到的需求增长让人震惊。 GLM找漏洞追平Mythos Semgrep做这个测试,最初其实不是为了找最强的开源模型
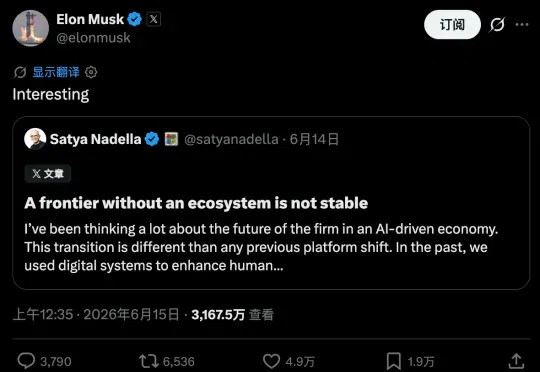
微软CEO 萨蒂亚·纳德拉,上周发的那篇《没有生态的前沿,立不住》(A frontier without an ecosystem is not stable),是近期挺有意思的一篇文章。不在于它提出了多少新概念,里面的很多要点,在近一年里大多已有讨论,而在于说它的不是旁观者,而是亲手运营着庞大 AI 基础设施的人,并且纳德拉用很朴素的语言,把两件非常重要的事情讲清楚了:
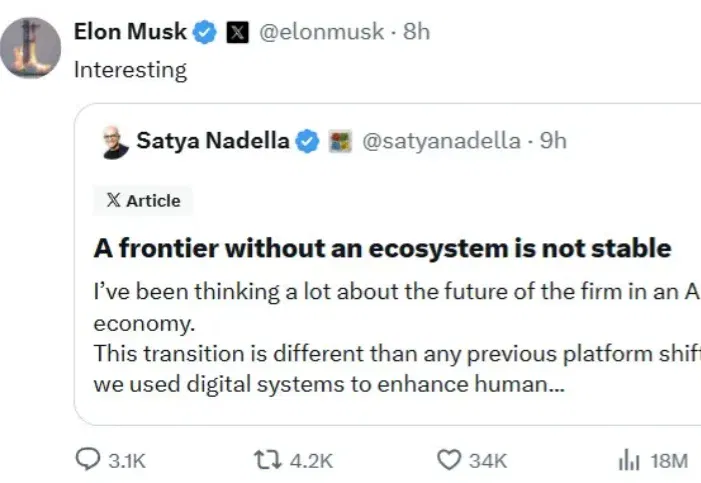
昨天晚上,微软 CEO 萨蒂亚·纳德拉(Satya Nadella)在 𝕏 上发布了一篇长推文《A frontier without an ecosystem is not stable》,即「没有生态系统的前沿是不稳定的」。
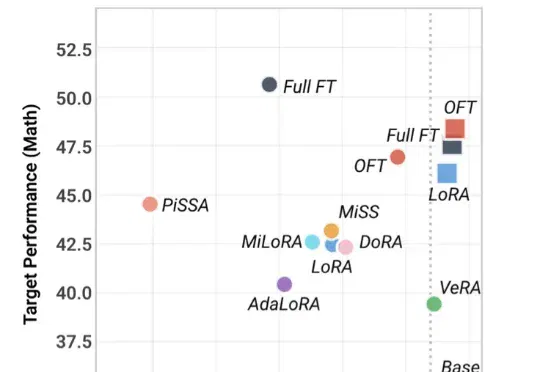
近期,来自香港中文大学、西湖大学、德国马普所等机构的研究者提出了 PEFT-Arena —— 一个从稳定性‑可塑性权衡(stability–plasticity trade-off)视角重新审视 PEFT 方法的评测基准与分析框架。该工作已在 ICLR 2026 相关 workshop 上进行了展示,并开源了完整代码。
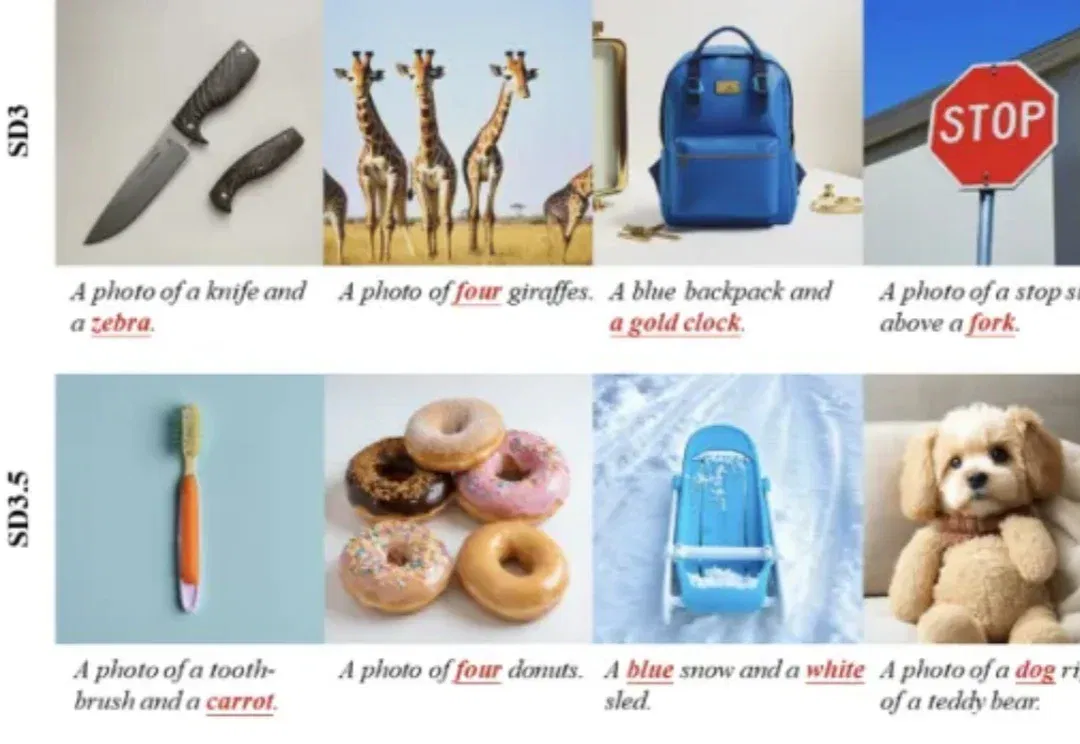
近年来,文生图模型的能力快速提升。从 Stable Diffusion 到 FLUX、Qwen-Image,扩散模型已经能够生成高质量图像,也能处理越来越复杂的文本提示。
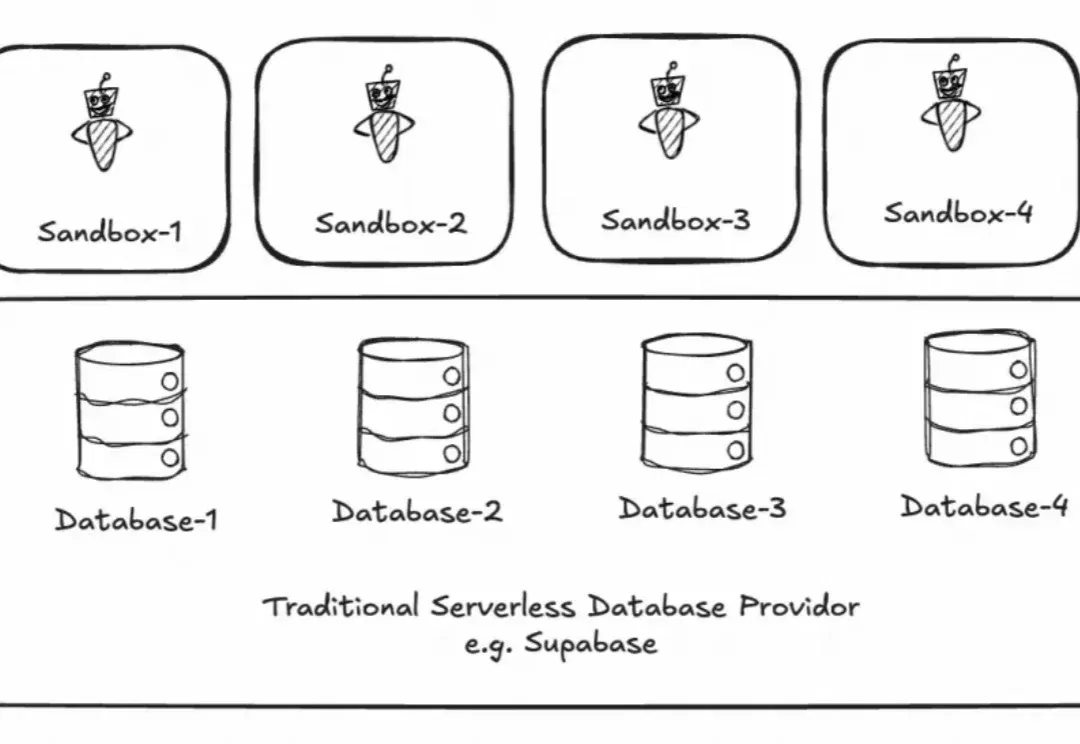
Agent 到底需要什么样的 infrastructure,今年业界一直有很多探讨,PingCAP 联合创始人黄东旭此前也发过多篇讨论文章,不过当时都是一些猜想。随着 agent 今年的爆发,大规模落地的案例出现了。
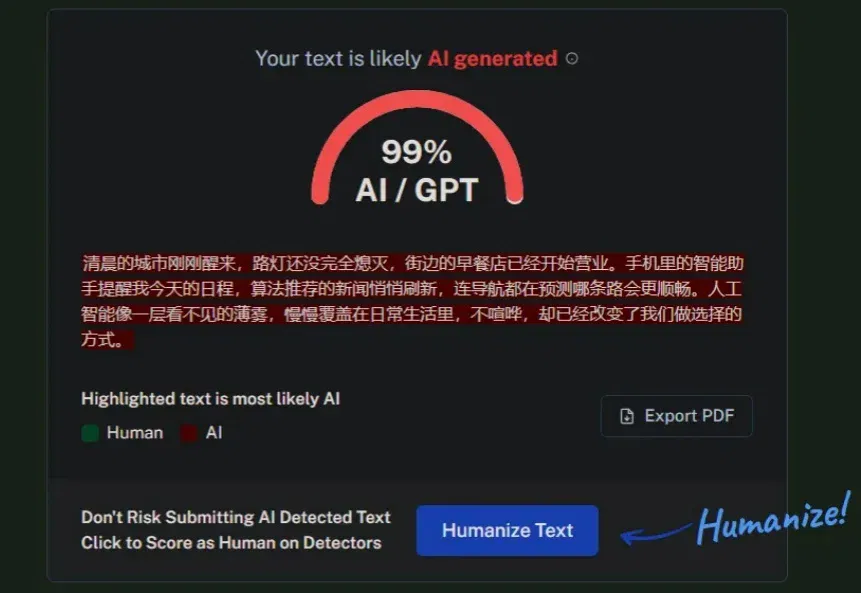
最近看了一个 AI 工具站:undetectable.ai。
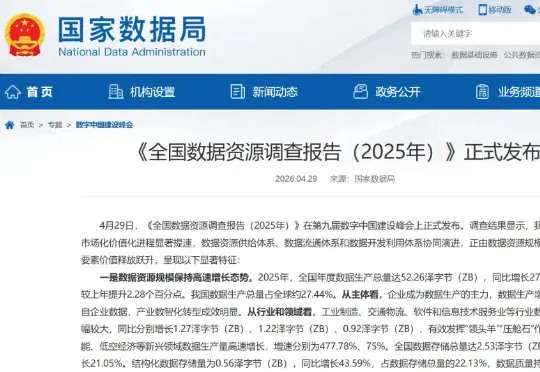
据央视新闻报道,今天,《全国数据资源调查报告(2025 年)》在第九届数字中国建设峰会上发布。报告显示,2025 年,全国数据生产总量同比增长 27.28%,达到 52.26ZB(ZettaByte,泽字节 | 1ZB=1024EB),这相当于全国所有算力中心存储容量的近 30 倍。从国际来看,我国数据生产总量占全球的 27.44%。
直面质疑,Tabbit 详解为什么要做 AI 浏览器。