对话科理新序张载熙:在最冷门时入局AI4S,他想构建科学原生基座模型 (opens in a new tab)
科理新序创始人张载熙讨论 scientific token、科学基座模型与干湿实验闭环。他分享STELLA靶点候选和蛋白设计案例,也强调计算结果与湿实验间的差距。SSI是团队设定的后续目标,自动化实验室及更大模型能力仍在规划和验证。
Total 87 articles
科理新序创始人张载熙讨论 scientific token、科学基座模型与干湿实验闭环。他分享STELLA靶点候选和蛋白设计案例,也强调计算结果与湿实验间的差距。SSI是团队设定的后续目标,自动化实验室及更大模型能力仍在规划和验证。
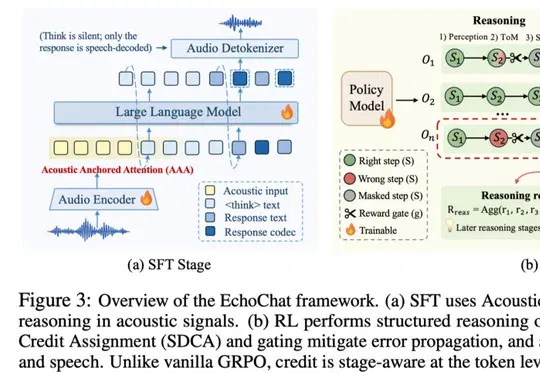
EchoChat将共情语音对话拆分为感知、心智理论推理和回复生成,并通过Acoustic-Anchored Attention与Step-Decomposed Credit Assignment统一优化,在三项评测中取得领先表现。
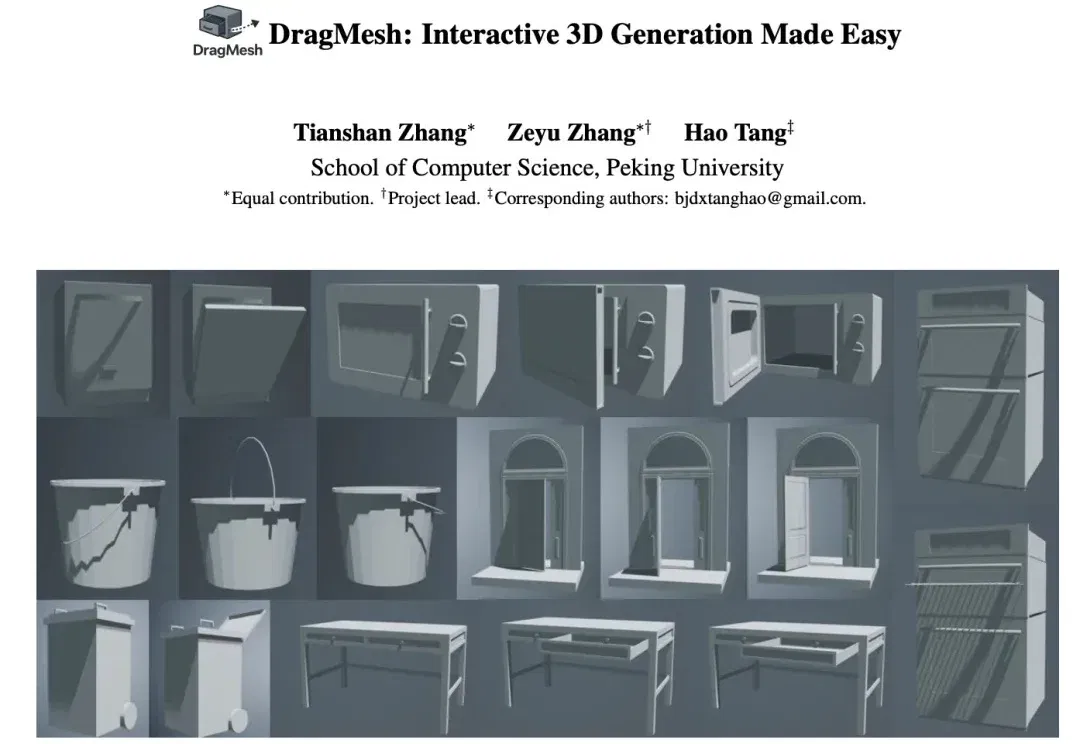
近年来,3D 生成模型在几何质量和渲染效果上进步很快。从 Mesh 到 NeRF、3D Gaussian Splatting,生成一个外观完整的三维物体已经不再困难。现有不少 articulated 3D generation 工作,更多关注的是从输入中生成一整套可动 3D 资产,包括物体几何、部件划分以及关节结构。
美国个人AI助理创企Tab公开亮相约六周后估值达3亿美元,但Assistant Benchmark测试显示其预订、旅行和购物任务仍易因网站限制及支付风控失败。
AI 行业,模型任务分工开始更加垂直。 智能家居社区 Home Assistant 最近出现了一个名为 HA-Jev 的插件。 它的逻辑极其简单,传感器读取洗衣机的功率变化与洗衣房门的状态,然后抛出一个问题给模型,「洗衣机洗完了,衣服是不是被忘在里面了?」模型不输出任何文字分析,只返回一个概率值。当置信度超过 0.8 时,手机就会弹出一则取衣提醒。 HA-Jev 仅仅用来提醒用户洗完的衣服是不是还留在洗衣机里|图片来源:pitchhut 一次判断耗时几十毫秒,花费 0.000015 美元。 插件开发者在论坛里留下一句意味深长的话,「我过去一直在用大语言模型回答根本不需要它的问题。衣服忘没忘拿是
字节跳动旗下豆包在日活跃用户突破2亿后收缩对话团队,通用Session团队规模预计缩减约一半,对话方向的产品后训练团队也在缩减,部分人员转岗至商业化及飞书团队,其余被裁撤,反映出对话产品商业化承压下豆包业务重心的调整。
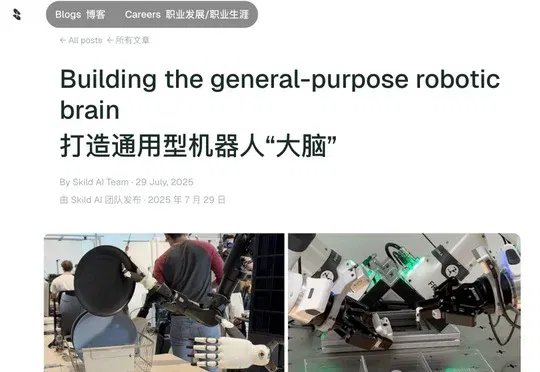
美国具身智能独角兽Skild AI基于其机器人基础模型Skild Brain和S1,借鉴AlphaGo的自我对弈方法,让人形机器人"Messinator"在虚拟足球场中自我对弈约140年,自主习得盘带、护球、抢断和射门等足球技能。
当 AI Agent 开始连续数小时替人工作,真正有价值的就不只是最终成果,还有藏在会话(Session)里的整个过程:它做过什么、哪里失败、为何改变方向。
让GPU学会给三维世界“排队”。 GPU公司通常不太需要向别人解释自己为什么做GPU。 但当一家GPU公司开始亲自下场研究算法,事情就没那么简单了。 最近,摩尔线程团队的一篇论文被计算机视觉三大顶会之一的ECCV 2026正式接收。这篇论文把目光放到了3D Gaussian Splatting,也就是3DGS上,论文名叫LiteGS,做的事情可以概括为:把3DGS训练得更快。 但如果只把它理解成一次普通的算法优化,就低估了这篇论文的意思。 过去两年,空间智能(spatial intelligence)成了AI行业的高频词:李飞飞为它创立了World Labs,国内的具身智能与世界模型创业潮,讲
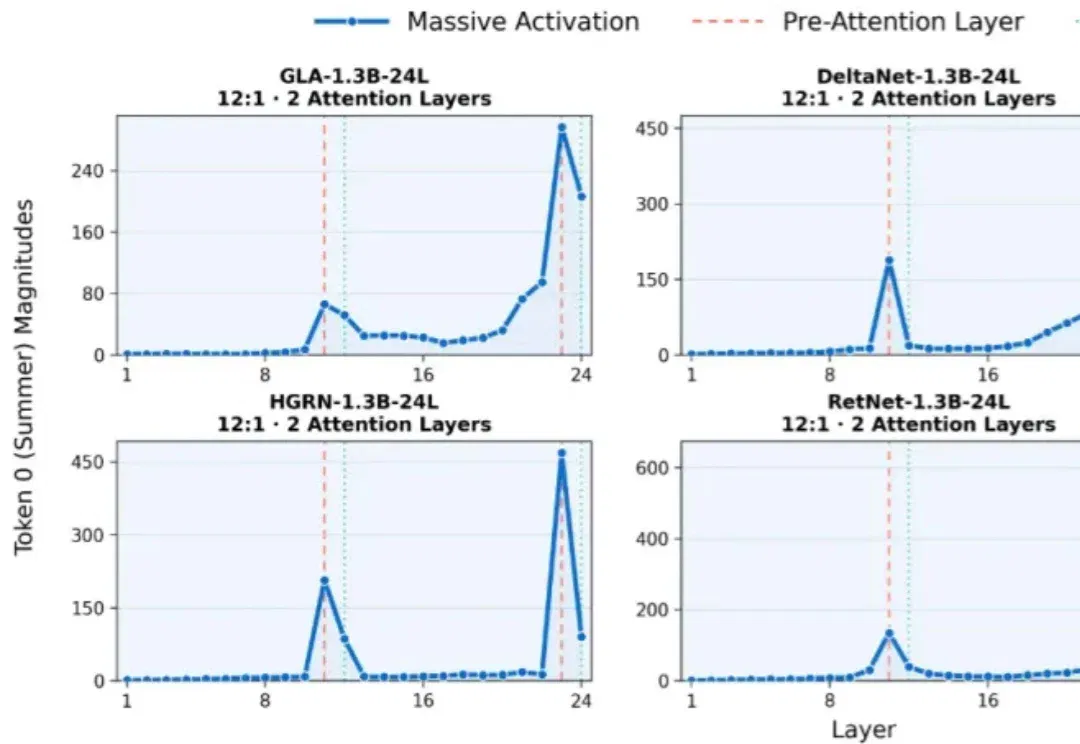
Full Attention 层尚未开始计算,它前一层的激活值已提前「冲上峰值」—— 这就像演唱会主角尚未登台,观众席已提前沸腾。来自 StartLux、清华大学等机构的研究者以 Massive Activations 为探针,首次系统刻画了少数 Full Attention 层在混合线性注意力大模型中留下的「跨层痕迹」,并识别出「注意力前尖峰」(PAS)与「尖峰间平台」(ISP)两种核心形态。