决策模型何时需要思考?StartLux-Decision的按需推理与概率校准 (opens in a new tab)
StartLux-Decision 结合单次概率判断与按需推理,研究置信度门控、RLCD²训练和策略感知校准。论文区分推理长度、终止率与准确率,并用DecisionPivot检验关键条件变化;推理收益及置信度仍受任务分布和路由策略影响。
Total 881 articles
StartLux-Decision 结合单次概率判断与按需推理,研究置信度门控、RLCD²训练和策略感知校准。论文区分推理长度、终止率与准确率,并用DecisionPivot检验关键条件变化;推理收益及置信度仍受任务分布和路由策略影响。
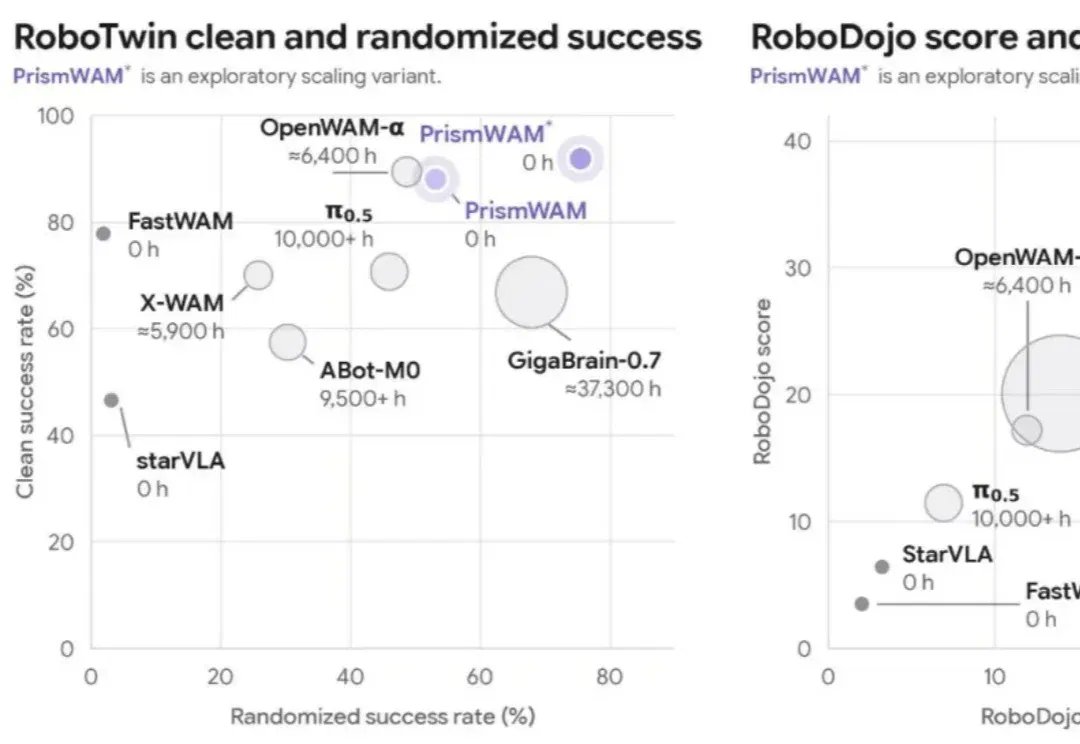
近日,厘清智能创始人、清华大学人工智能学院李一鸣教授团队发布了两项 Physical AI 研究成果:世界动作模型 PrismWAM,以及面向机器人执行诊断与持续改进的 Agentic 框架 RoboDoctor。
Mirendil宣布由1名研究员借助AI智能体训练出100B–500B参数编程基座模型Mirendil-Base,Recursive发布40B模型Flint及Eureka Machine,英伟达研究员Ali Hatamizadeh提出RSI时代研究者应强化判断力与基础能力的四大生存法则。
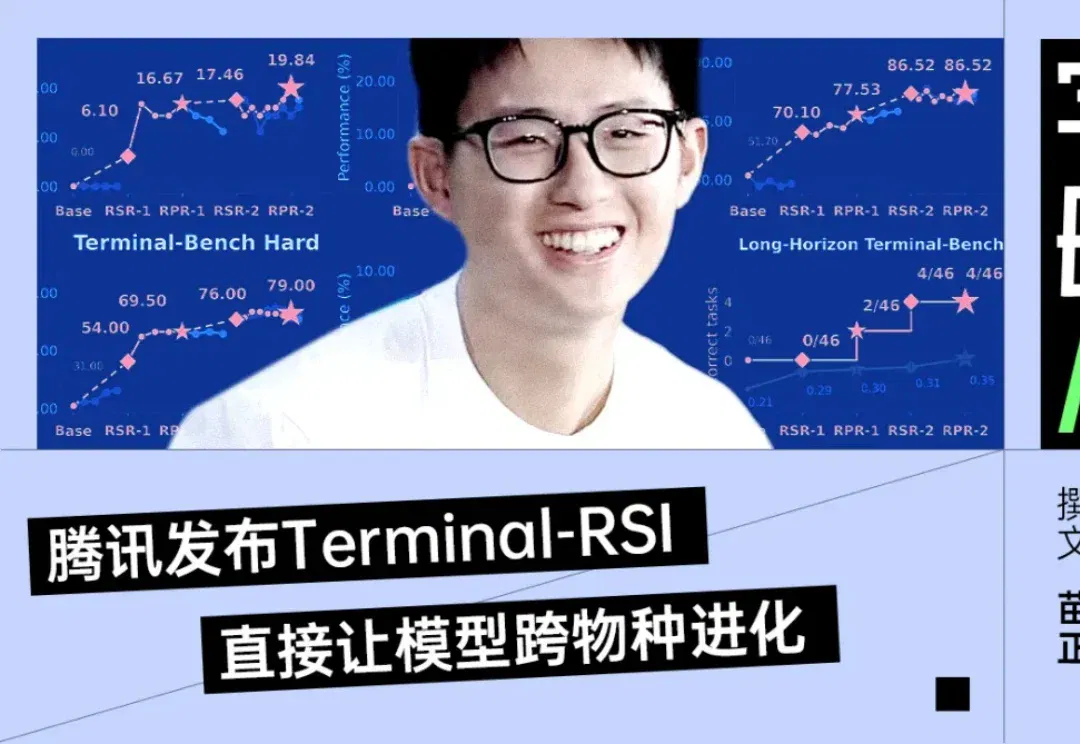
自Hy4 Preview发布以来,它最受人关注的地方就是全链路RSI,这也是腾讯混元首个自己全程参与研发的模型。通过全链路RSI能给模型带来大幅性能提升。
Claude,竟然排在最后? PhAI Labs 最新公布了一项 AI 研究能力对照,结合后续发表的科学文献,考察不同模型提出的研究假设能否为未来的研究思路与探索方向提供启发。报告所列的 Claude Opus 5 组对应比例为 2.3%,排在图中五个模型组的末位。GPT 组为 2.5%,GLM 为 2.8%,DeepSeek 为 5.4%。 排在最前面的,是 DiscoveryRSI:6.3%,约为 GPT 组的 2.5 倍、Claude 组的 2.7 倍。 图 1|五个模型组对未来研究的启发:DiscoveryRSI 总体比例为 6.3%。 这项比较观察的是:AI 提出的研究假设,能否在后
由Transformer奠基论文核心作者Llion Jones创办的 Sakana AI,联手UC Berkeley带来了一项递归自我改进(RSI)新成果:MASS(Multi-Agent Self-Supervision)。
StartLux发布StartLux-Decision新版本,推出Instant与AutoThink双模型矩阵及原创RLCD²,在Decision Index 0.3和DecisionPivot评测中领先多款模型,并公开模型权重与推理代码。
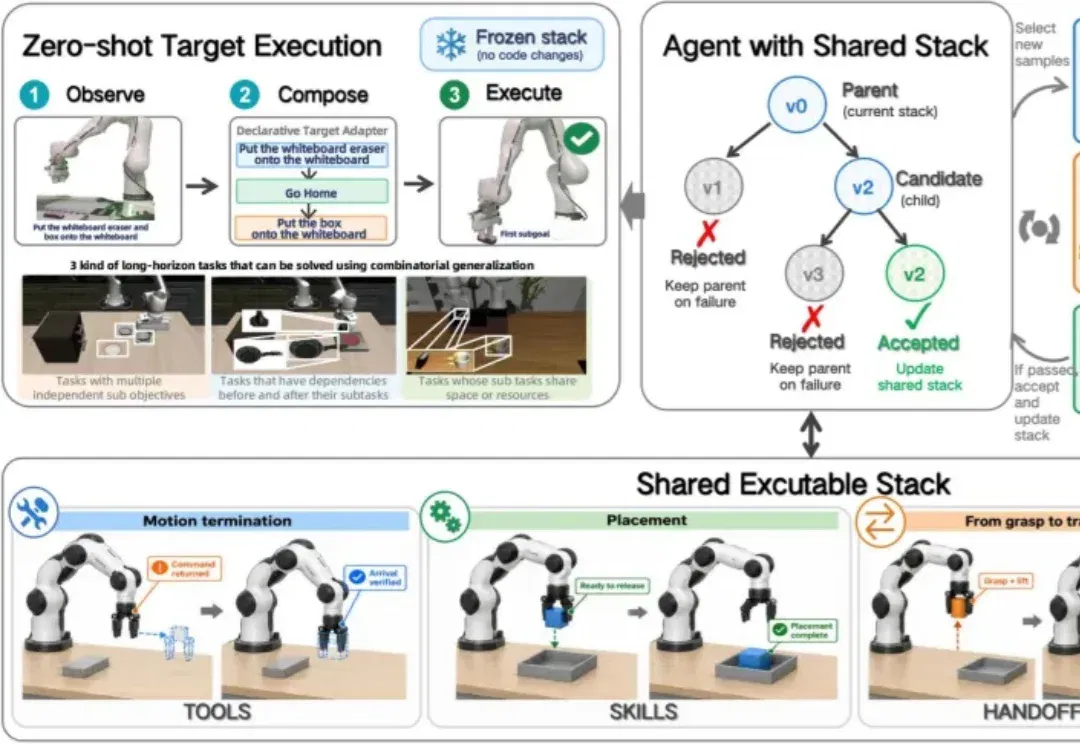
机器人 RSI 时刻远远未到达,先看一个动作:机械臂把碗放到盘子上,再抓起杯子,放进刚刚移动过的碗里。
最近,全球AI圈彻底疯了。 所有核心研究员都在通宵讨论三个致命的英文字母——RSI(递归自我改进)。 换句话说,AI不再需要人类敲代码了,它已经开始自己给自己「动手术」、自己创造下一代更强的AI了! 这一串实锤让人头皮发麻: 谷歌前沿模型的发布周期,从125天被硬生生压缩到了44天,内部员工直接承认:「这是RSI的早期迹象」。 OpenAI神秘模型凭借单条指令、深度思考3小时,直接刷穿4000道世界级数学难题,用的是人类科学家甚至看不懂的「异星逻辑」,而这套逻辑正被用来升级它自己。 Anthropic代码库超八成已由AI自己编写,对齐主管公开把「AI消灭人类的概率」押注在10%以上,罪魁祸首直
英伟达联合MIT和牛津大学团队提出Physis-Lang,通过物理语言描述、自进化准则和能力导向的数据检索提升视频模型的物理理解与生成表现,其Cosmos3-Super和Cosmos3-Nano在Physics-IQ Verified分列第一、第二。