大模型搜索总偷懒?IQuest等联合推出FORT,30B开源搜索Agent刷新同规模SOTA (opens in a new tab)
来自至知创新研究院(IQuest Research)、中国人民大学高瓴人工智能学院、KAUST等机构的研究团队提出了FORT,一个面向Deep Search Agent的shortcut-resistant training-data synthesis framework。
Total 96 articles
来自至知创新研究院(IQuest Research)、中国人民大学高瓴人工智能学院、KAUST等机构的研究团队提出了FORT,一个面向Deep Search Agent的shortcut-resistant training-data synthesis framework。
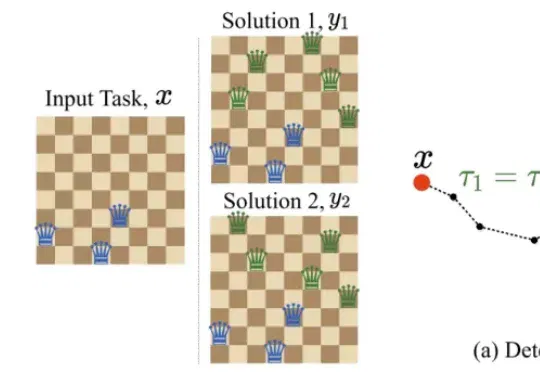
现在,图灵奖得主 Yoshua Bengio 给出了一份全新的并行方案。他们提出了 GRAM(Generative Recursive reAsoning Models,生成式递归推理模型),把确定性的递归潜在推理变成了概率性的多轨迹计算。模型在潜在空间中进行随机递归推理,每一步都可以采样不同的方向,最终形成对解空间的多路径探索。
一个懂审美、更懂你的“AI闺蜜”。 打开小红书或 Pinterest,你看到的是“别人的生活”;打开 Viba,你看到的是“下一个场景里的自己”。 这是 N7 Interactive 创始人梁芊荟对最新产品最朴素的定义。在AI购物工具扎堆比价、试穿、帮你“买得更快”的当下,Viba 选择去解决一个更根本的问题:在用户打开搜索框之前,如何帮TA想清楚“自己想成为谁”? 这家由MIT建筑与计算机双硕士、前华为河图社交产品负责人创立的公司,在MVP阶段已经跑出了令团队兴奋的数据: 用户平均每周收藏13.79个灵感,峰值接近30个;次周留存高达53%;用户自发分享的单条Instagram动态,浏览量破
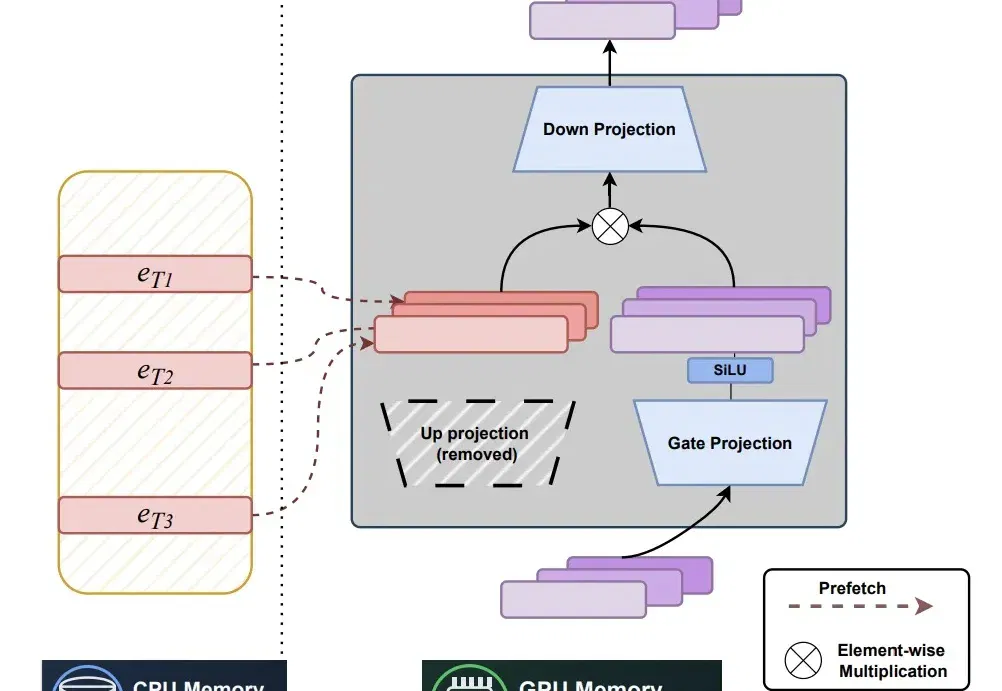
近年来,随着大语言模型规模与知识密度不断提升,研究者开始重新思考一个更本质的问题:模型中的参数应如何被组织,才能更高效地充当「记忆」。
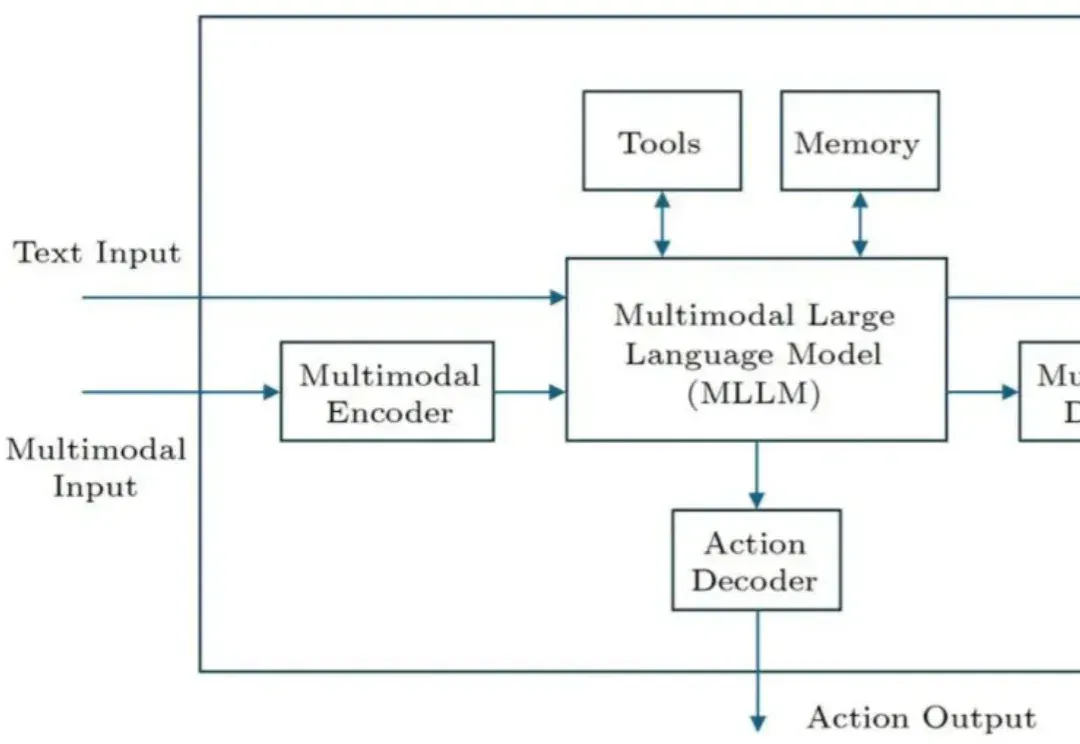
AI 智能体是人工智能领域的重要研究方向之一。近期,字节跳动的李航博士在我国计算机科学领域顶级期刊 Journal of Computer Science and Technology(JCST)上发表了一篇题为《General Framework of AI Agents》的观点论文(将收录于 JCST 创刊 40 周年专辑),提出了一个涵盖软件智能体和硬件智能体的通用框架。
一年一度的英伟达奖学金出炉了。二十五年来,英伟达研究生奖学金计划(NVIDIA Graduate Fellowship Program)一直为研究生提供与英伟达技术相关的杰出工作支持。
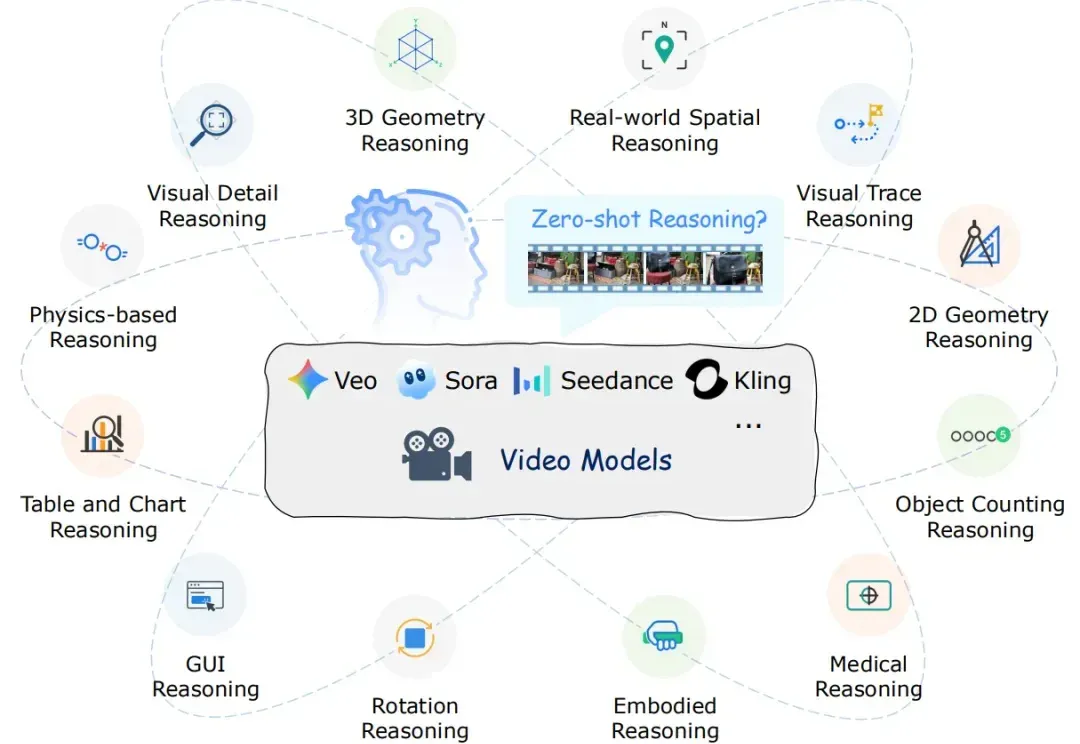
近年来,以 Veo、Sora 为代表的视频生成模型展现出惊人的合成能力,能够生成高度逼真且时序连贯的动态画面。这类模型在视觉内容生成上的进步,表明其内部可能隐含了对世界结构与规律的理解。更令人关注的是,Google 的最新研究指出,诸如 Veo 3 等模型正在逐步显现出超越单纯合成的 “涌现特性”,包括感知、建模和推理等更高层次能力。
复杂的简历,AI也能读懂了。 阿里巴巴集团研究团队,开发出了一套基于布局感知的简历解析框架。 该框架在简历解析任务上的准确率逼近Claude-4等业界顶尖大模型,处理整份简历仅需1-2秒。 而且这项创新直击自动化简历解析的三大痛点——版面格式多样、大模型成本高昂及响应速度慢,为智能招聘树立了新的效率与精度标杆。 该技术框架的论文《Layout-Aware Parsing Meets Efficient LLMs: A Unified, Scalable Framework for Resume Information Extraction and Evaluation》已发布。 长久以来,自动
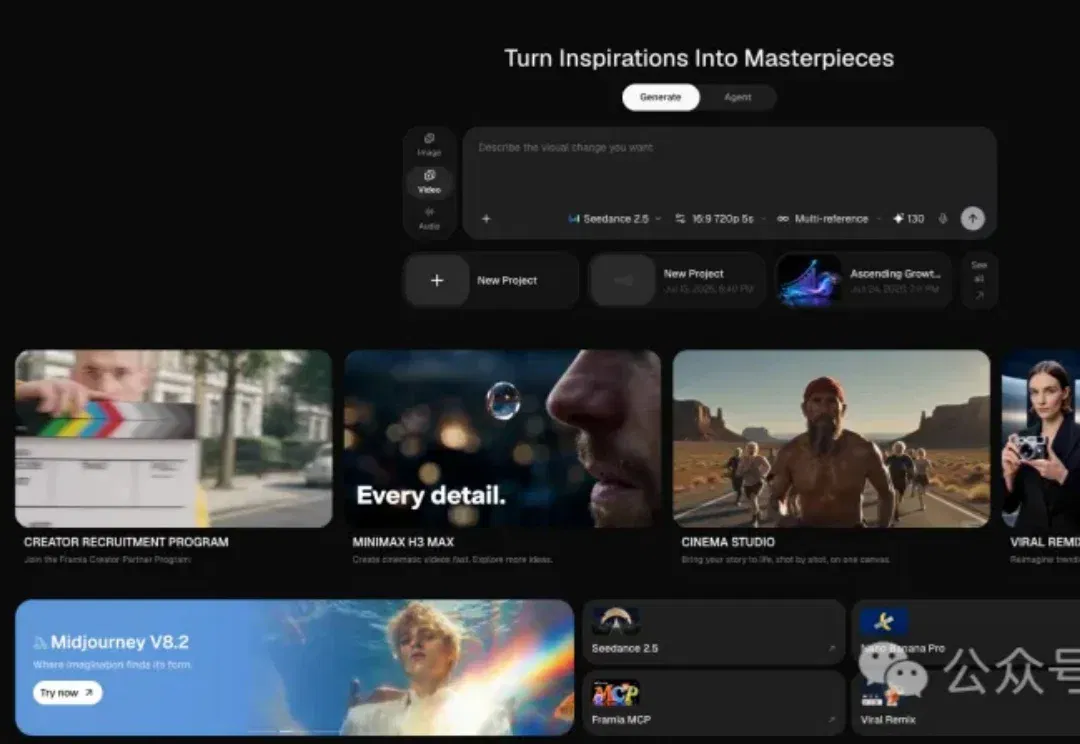
作者以食谱网站为例,体验 Converge AI 的 Framia 与 Enter:先生成图片和视频并存入共享资产库,再在应用构建过程中调用、修改素材。文章还介绍登录、支付与团队协作功能,讨论减少跨工具搬运的价值及仍需人工判断的产品问题。
在 Cheeky Pint 访谈中,奥特曼从全球 DRAM 供应紧张与利用率出发,认为为低频本地 AI 配置大量闲置内存不如集中于云端,并批评厂商扩产保守。文章也讨论科学研究成本、智能体与计费方式;这番资源配置主张引发了围绕本地计算和个人硬件选择的争论。