对话桥介数物:机器人运动的下一步是让任何机器人半小时内学会跳特定的舞 (opens in a new tab)
桥介数物创始人尚阳星透露,公司将做了三年的项目制全身运动控制业务升级为平台产品RoboCraft AI,用户上传视频即可在半小时内完成动作提取、仿真与实机部署,并刚刚完成由中国移动链长基金领投的亿元级融资。
Total 45 articles
桥介数物创始人尚阳星透露,公司将做了三年的项目制全身运动控制业务升级为平台产品RoboCraft AI,用户上传视频即可在半小时内完成动作提取、仿真与实机部署,并刚刚完成由中国移动链长基金领投的亿元级融资。
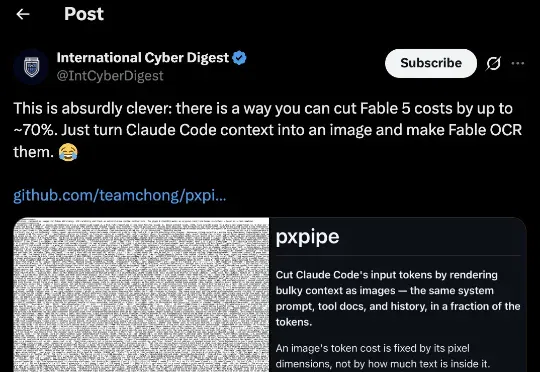
这两天,有位机智的老哥发现,只要把Fable 5的上下文转换成一张张密密麻麻写满文字的图片,再让模型通过OCR读回来,token输入成本最多能省下70%。更离谱的是,不只是普通对话,系统提示、工具文档、历史记录,全都能一股脑塞进图里。
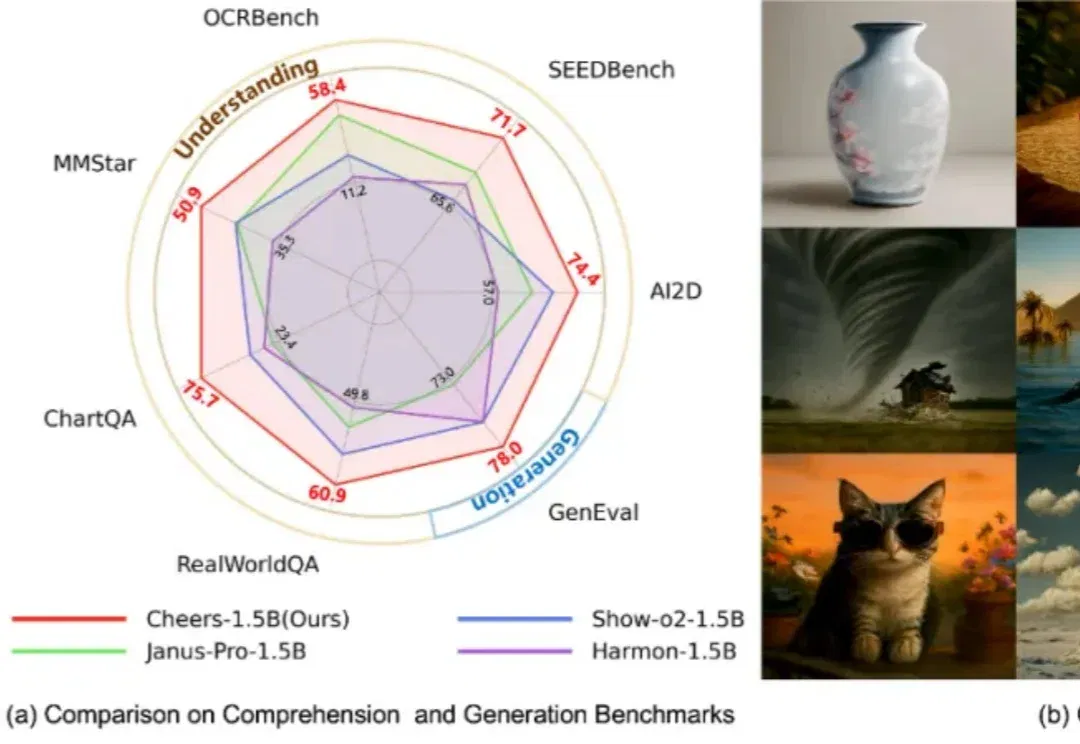
过去几年,多模态模型在理解任务上快速演进,图像问答、OCR、视觉推理、跨模态对话等能力不断提升;与此同时,图像生成模型也在视觉质量、指令遵循和细节表达上持续突破。下一步一个自然的问题是:能否用同一个模型,同时做好理解与生成?这正是统一多模态模型(Unified Multimodal Models, UMMs)正在回答的问题。
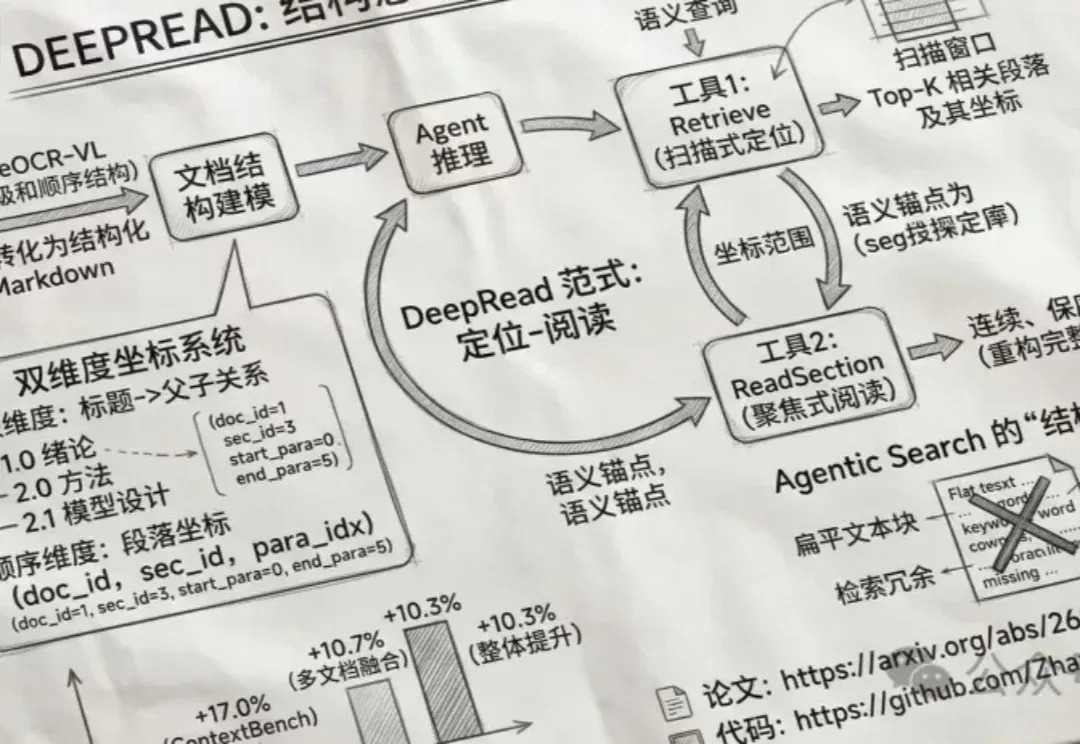
DeepRead让AI像人一样阅读文档:利用OCR识别章节结构,先精准定位相关段落,再完整读取上下文,避免碎片化检索。实验显示,其长文档问答准确率提升17%,能自动跳过冗余信息,精准提取财报、论文等复杂内容,无需额外知识图谱,轻量高效。
DeepSeek开源DeepSeek-OCR2,引入了全新的DeepEncoder V2视觉编码器。该架构打破了传统模型按固定顺序(从左上到右下)扫描图像的限制,转而模仿人类视觉的「因果流(Causal Flow)」逻辑。
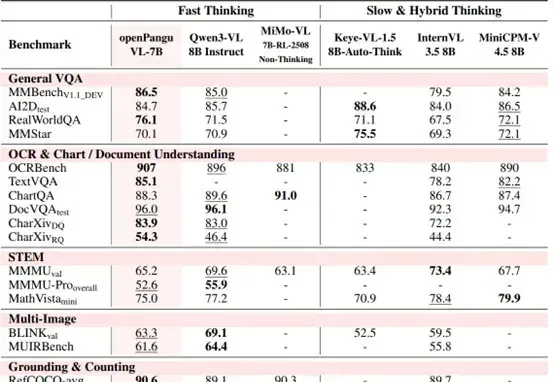
7B量级模型,向来是端侧部署与个人开发者的心头好。
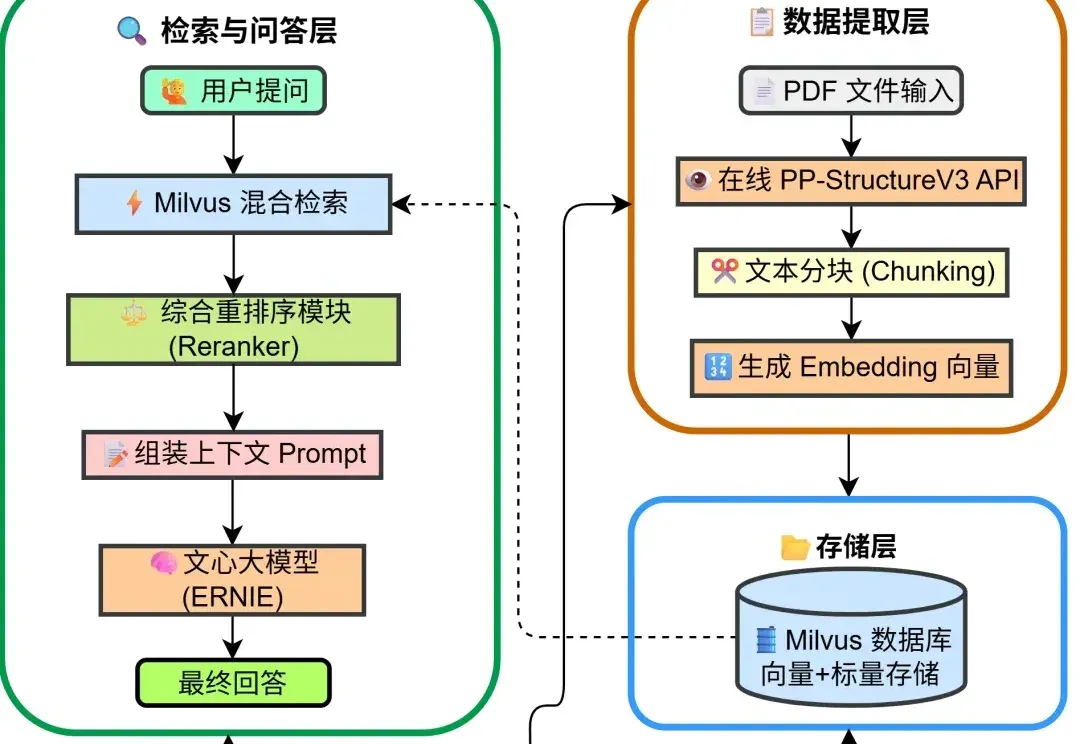
在大型语言模型(LLM)的应用落地中,RAG(检索增强生成)是解决模型幻觉和知识时效性的关键技术。
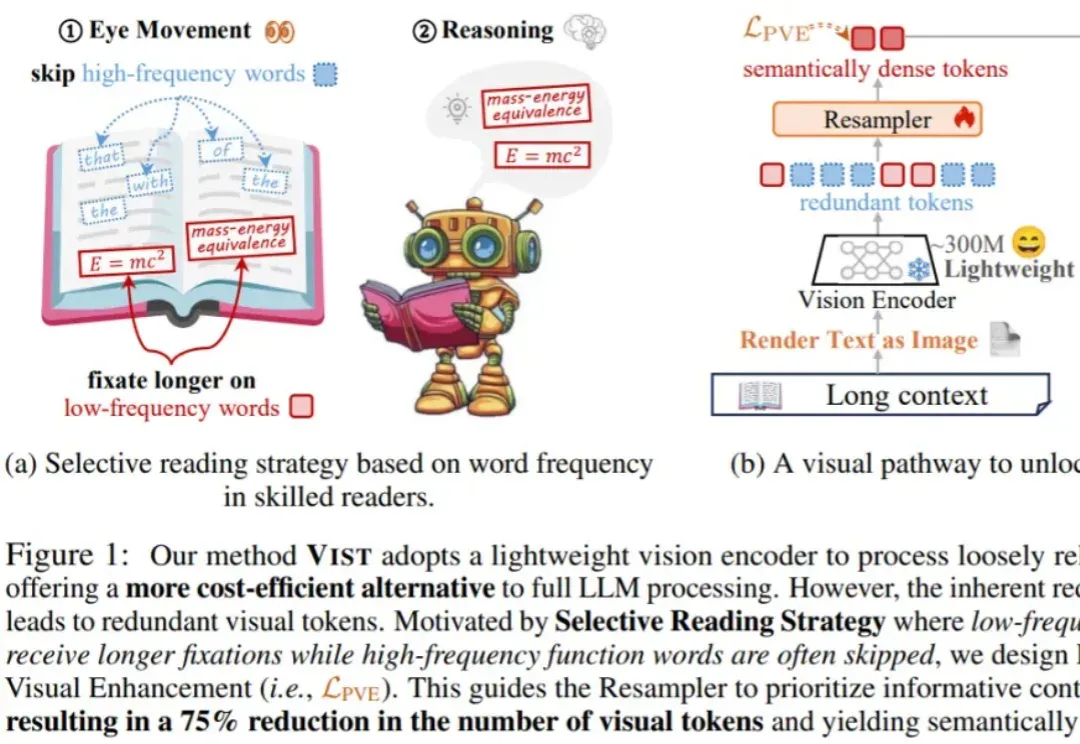
在处理短文本时,大语言模型(LLM)已经表现出惊人的理解和生成能力。但现实世界中的许多任务 —— 如长文档理解、复杂问答、检索增强生成(RAG)等 —— 都需要模型处理成千上万甚至几十万长度的上下文。
在NeurIPS 2025论文中,来自「南京理工大学、中南大学、南京林业大学」的研究团队提出了一个极具突破性的框架——VIST(Vision-centric Token Compression in LLM),为大语言模型的长文本高效推理提供了全新的「视觉解决方案」。值得注意的是,这一思路与近期引起广泛关注的DeepSeek-OCR的核心理念不谋而合。
dots.ocr 支持多语言文档的解析,能够在单一模型中统一完成版面检测、文本识别、表格解析、公式提取等任务,并保持良好的阅读顺序。他们之所以在一个模型中完成这些任务,是因为他们相信这些任务之间可以相互促进,为彼此提供更多的 context,从而达到更高的性能上限。目前,该项目的 star 量已经超过了 5000。