Nvidia都在点赞的LoopWM世界模型,竟然来自一家中国初创FaceMind? (opens in a new tab)
在世界模型这条路上,行业一直卡在一个几乎无解的矛盾里:想要更真实的长程模拟,就必须给模型更深的计算;可一旦把模型做得更深,部署成本、参数规模和误差累积又会迅速抬头。结果就是,大家都知道世界模型要 “想得更久”,却很难让它在现实系统里 “算得起、跑得稳”。
Total 62 articles
在世界模型这条路上,行业一直卡在一个几乎无解的矛盾里:想要更真实的长程模拟,就必须给模型更深的计算;可一旦把模型做得更深,部署成本、参数规模和误差累积又会迅速抬头。结果就是,大家都知道世界模型要 “想得更久”,却很难让它在现实系统里 “算得起、跑得稳”。
自动化研究,这一次真正走出代码沙盒,进入了真实的物理世界。
刚刚,田渊栋创业公司,交出了首个研究成果。田渊栋在X上宣布,其创立的Recursive,在NVIDIA官方的GPU kernel优化榜SOL-ExecBench上拿下了整体和四个子类别的SOTA。
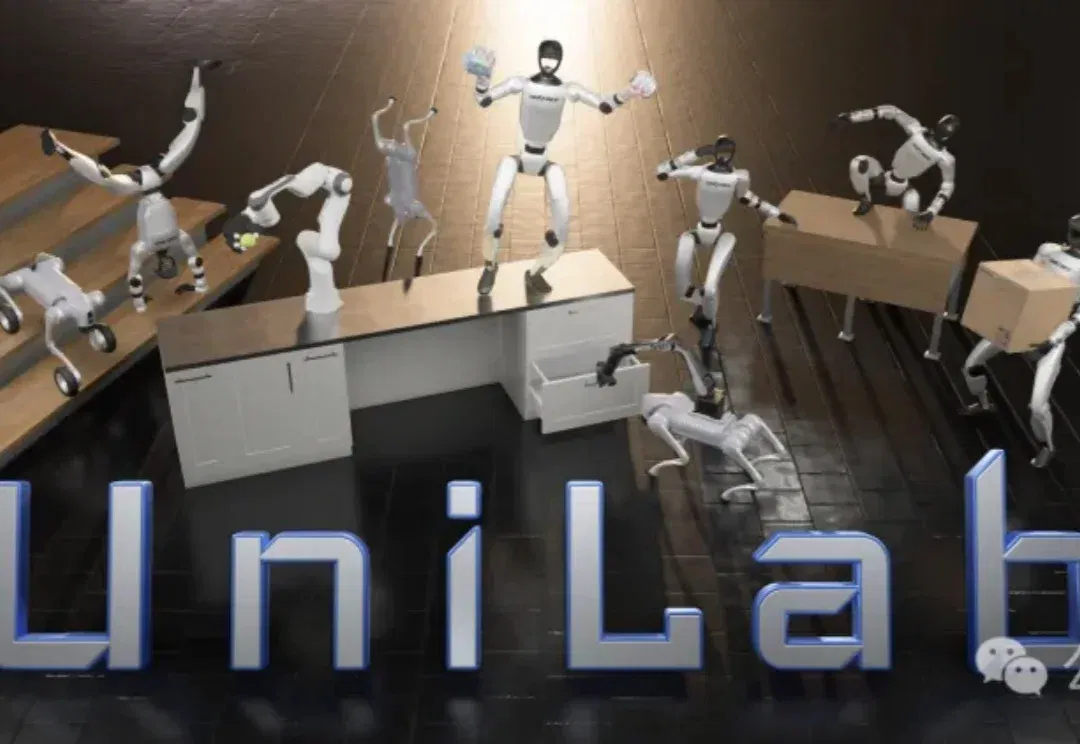
在具身智能训练中,“把计算全部塞进GPU”似乎成了唯一的提速密码,机器人运控并行训练的框架,IsaacLab、MuJoCoPlayground、mjlab都默认遵循这一范式,这些系统都牢牢绑定在NVIDIA生态中。
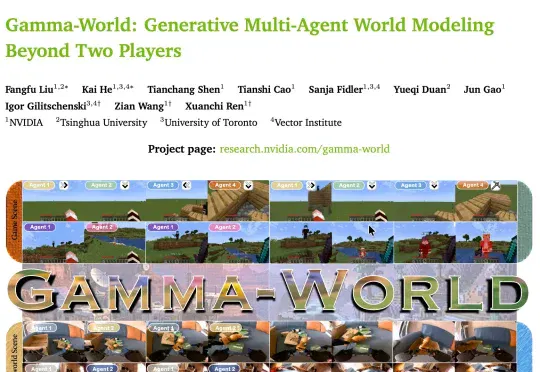
5 月下旬,NVIDIA 联合清华大学、多伦多大学和 Vector Institute 发布 Gamma-World,共一第一为清华大学电子系博士刘芳甫,核心 Research 方向是世界模型和空间智能。
众所周知,大模型训练成本极高。 但大家又知道,降低训练精度能够显著降低训练成本。DeepSeek-V3 用 FP8 训练把成本打到了 560 万美元,已经让全行业侧目。 在 FP8 成功后,行业仍然在不断探索低精度的边界:从 FP8 降到 FP4,训练成本还能再降多少? 理论上,FP4 的计算吞吐可以是 FP8 的两倍。NVIDIA Blackwell 和 AMD MI350 系列都已经在硬件层面原生支持了 FP4 运算,前者在 B200 上标称 FP4 算力可达 4500 TOPS(稀疏)。硬件已经准备好了,但软件和算法那一侧,一直卡在一个问题上: 用 FP4 从头训练大模型,训练过程非常不
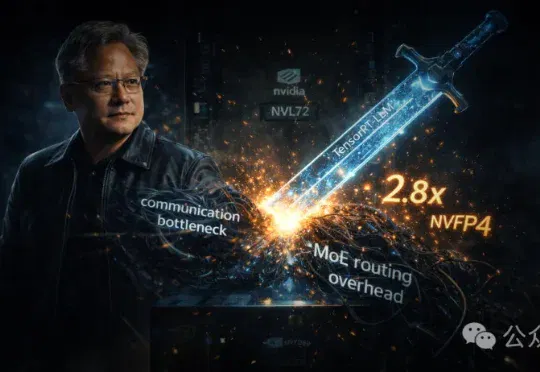
MoE模型的稀疏激活本是优势,却常陷通信瓶颈。NVIDIA以软件为利剑,通过程序化依赖启动和全对全通信革新,在三个月内将GB200的单GPU吞吐提升2.8倍,真正释放Blackwell硬件潜力。
谷歌还在闭源守宝,NVIDIA已把Lyra 2.0全开源:35步去噪变4步,2D图片直出3D高斯泼溅+网格。社交狂欢背后,是对具身AI仿真的巨大潜力——以后造世界,不用再去真实世界采数据了。
由 NVIDIA 支持的 Vast Data (一家为人工智能任务开发数据存储软件的公司)表示,已筹集约 10 亿美元,估值超过三倍增至 300 亿美元。
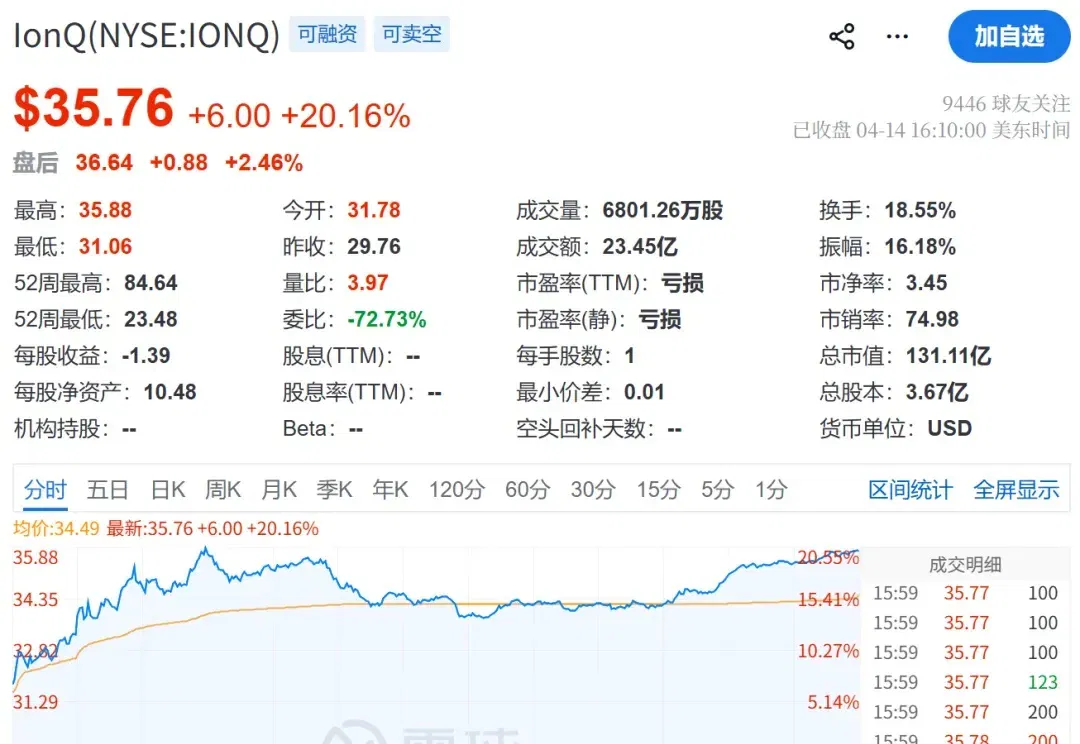
「Ising 改变了一切。」 昨夜,美股量子计算概念公司集体飙升。 本周二,英伟达宣布推出全球首个开源量子 AI 模型系列 NVIDIA Ising,把量子计算从实验室技术推到了接近工程落地的程度。它通过 AI 的方式,提供了比传统方法快达 2.5 倍、准确度高 3 倍的量子纠错解码能力。 长期以来,量子计算面临着两个致命的工程瓶颈:脆弱性(噪声)和难以扩展。量子比特(Qubit)对环境极其敏感,哪怕是微小的温度变化或电磁干扰都会导致计算出错。Ising 正是瞄准了这些痛点。 英伟达认为,人工智能是把当今的量子处理器转变为大规模、可靠的计算机的关键。而开放模型使开发者能够在完全掌控自身数据和基