国产大模型杀疯了!一手横测 MiniMax、DeepSeek V4、Kimi K2.6、MiMo 后,我找到了最能干活的 AI 牛马 (opens in a new tab)
从去年开始做这个账号以来,我其实写过不少测模型的文章。我相信也有很多朋友是因为看了我测评的文章关注我的。但从过年之后,真的就很少写模型评测的文章了。主要是我写文章的速度甚至一度跟不上模型发布的速度了。
Total 46 articles
从去年开始做这个账号以来,我其实写过不少测模型的文章。我相信也有很多朋友是因为看了我测评的文章关注我的。但从过年之后,真的就很少写模型评测的文章了。主要是我写文章的速度甚至一度跟不上模型发布的速度了。
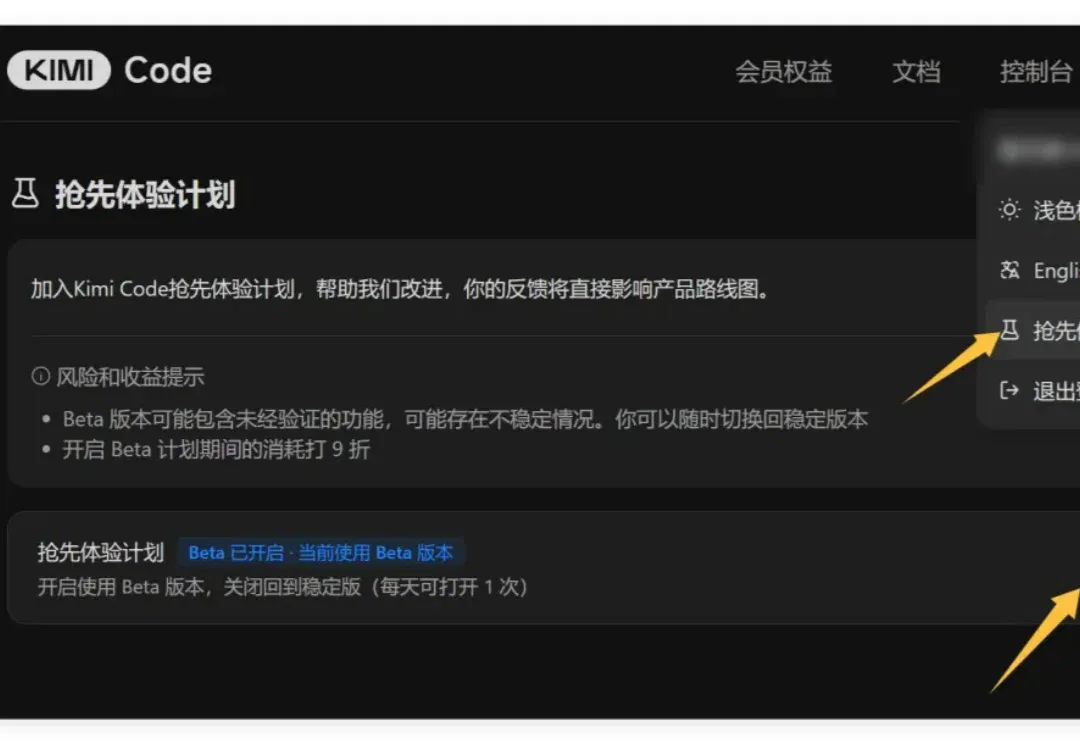
刚测完 Kimi K2.5,就拿到 Beta 版内测模型了。 一点喘息的机会都不给啊~~
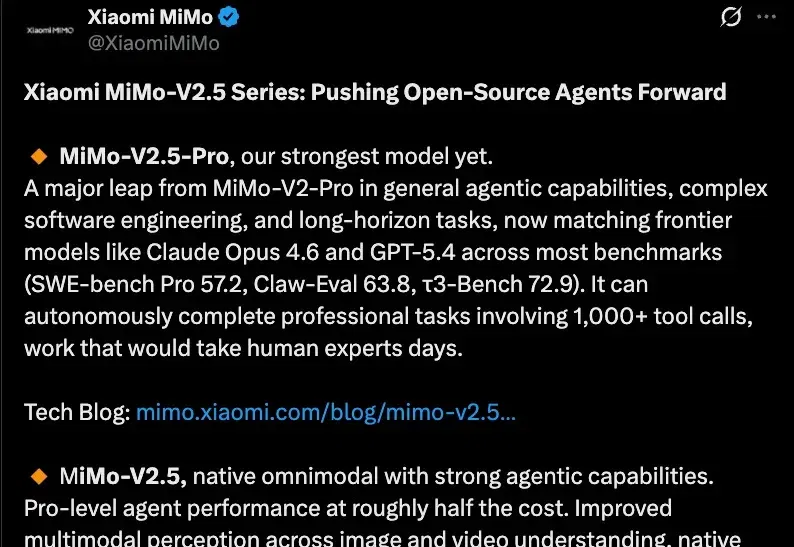
小米大模型时隔一月能力飙涨,比Kimi K2.6省42% Token。
今天,智谱正式开源其最强模型GLM-5.1,这一模型在专业软件开发基准测试SWE-Bench Pro中,GLM-5.1刷新全球最佳成绩,得分达到58.4,超过了GPT-5.4、Claude Opus 4.6等已经正式发布的闭源模型,和MiniMax M2.7、Kimi K2.5等开源模型。
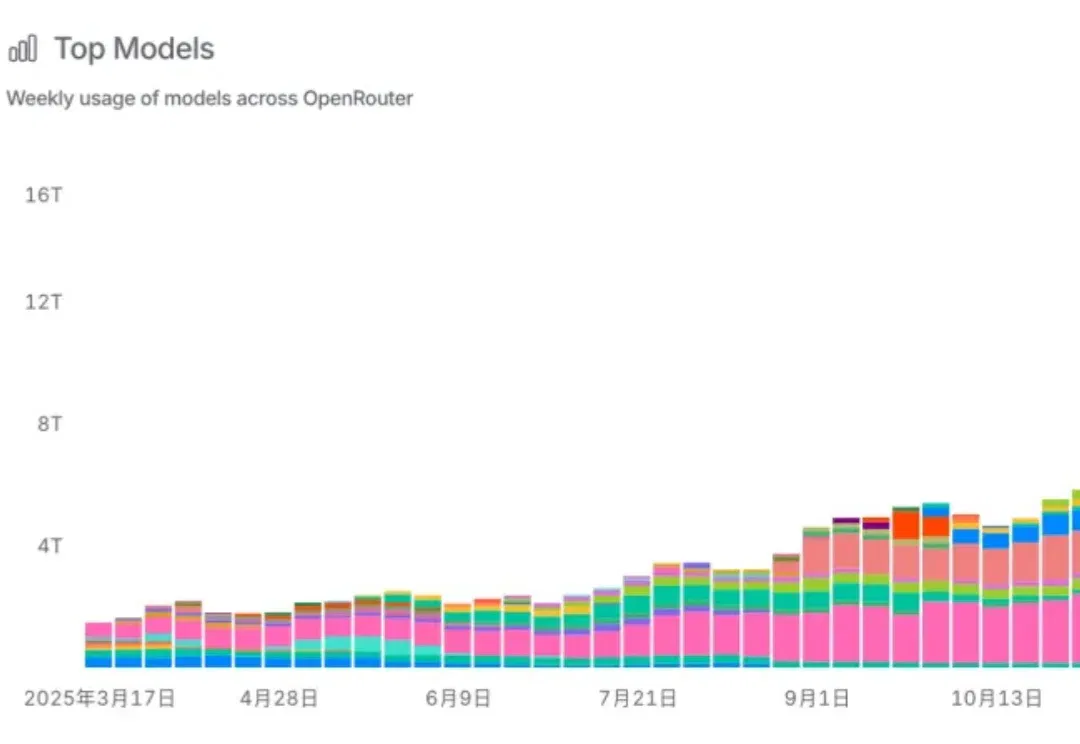
好家伙!龙虾老吃家还得看中国。 全民“养虾”热潮直接带动国产大模型喜迎黄金周。 根据OpenRouter最新数据,上周中国大模型的周调用总量飙升至4.19万亿Token。 这是继今年2月首度反超美国后,中国大模型再度强势登顶,重回全球榜首。 OpenClaw继续霸榜热门应用第一,其中本月最受养虾人青睐的算力搭子中,国产大模型依旧遥遥领先。 榜单前三分别是Kimi K2.5、Step 3.5 Flash和MiniMax M2.5,均超1T tokens。 果然在吃这回事上,国产玩家真夯!喝完奶茶吃龙虾,妙哉妙哉~(doge) 🦞爱吃中国大模型 整体来讲,上周3月2日-8日,中美大模型活跃度出现
最近,小编注意到一位全栈工程师 Rohith Singh 在Reddit上发表了一篇帖子,介绍他如何对四个模型(Kimi K2 Thinking、Sonnet 4.5、GPT-5 Codex 和 GPT-5.1 Codex)进行了实测。
阿里迄今为止,参数最大的模型诞生了!昨夜,Qwen3-Max-Preview(Instruct)官宣上线,超1万亿参数性能爆表。在全球主流权威基准测试中,Qwen3-Max-Preview狂揽非推理模型「C」位,直接碾压Claude-Opus 4(Non-Thinking)、Kimi-K2、DeepSeek-V3.1。
机器之心发布 随着 ChatGPT、Gemini、DeepSeek-V3、Kimi-K2 等主流大模型纷纷采用混合专家架构(Mixture-of-Experts, MoE)及专家并行策略(Expert
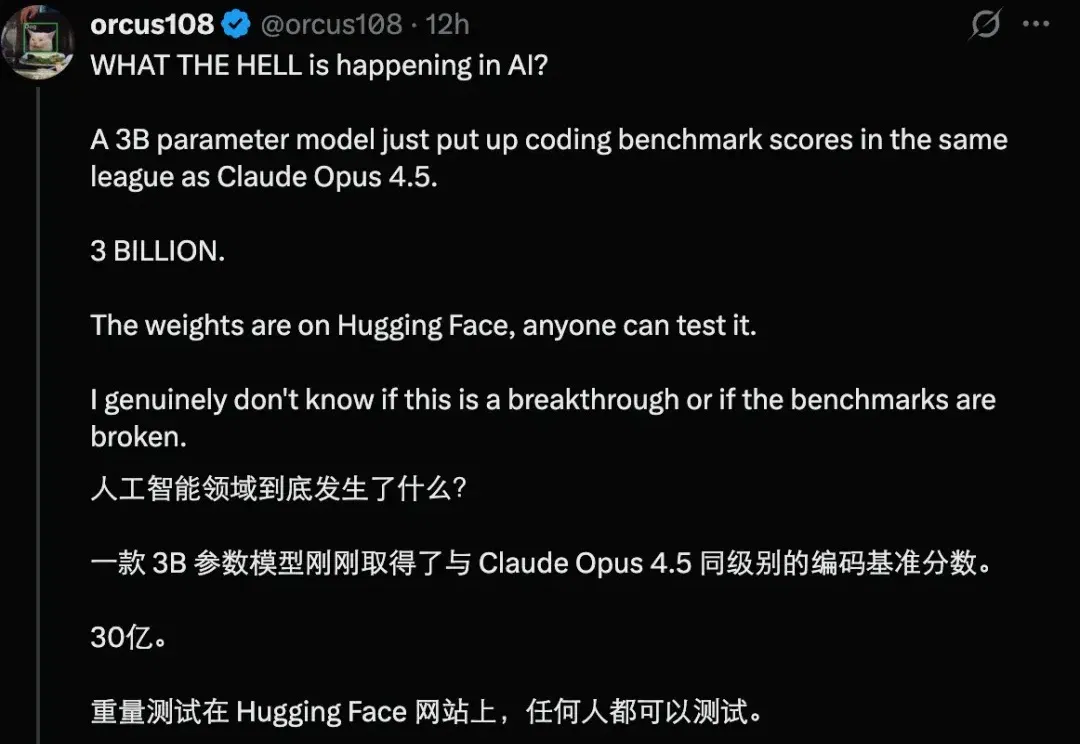
最近几天,一个 3B 的小模型在 X 上火了,因为在一些难度可验证的推理任务上(比如编程),它进入了 Gemini 3 Pro、GPT-5 high、Claude Opus 4.5、GLM-5、Kimi K2.5 等前沿模型的性能区间,而它的体积远小于这些模型。
本报告基于XSCT Arena平台,对 Qwen3.6-Plus-Preview(阿里云,2026-04-02 发布)在文字能力(xsct-l)、网页生成(xsct-w)、Agentic 任务(xsct-a)三大场景下的表现进行系统评测,并与Claude Sonnet 4.6、GPT-5.4、Gemini 3.1 Pro、Kimi K2.5、