ICML 2026|让奖励模型更准更高效,TikTok、NUS提出置信度门控 (opens in a new tab)
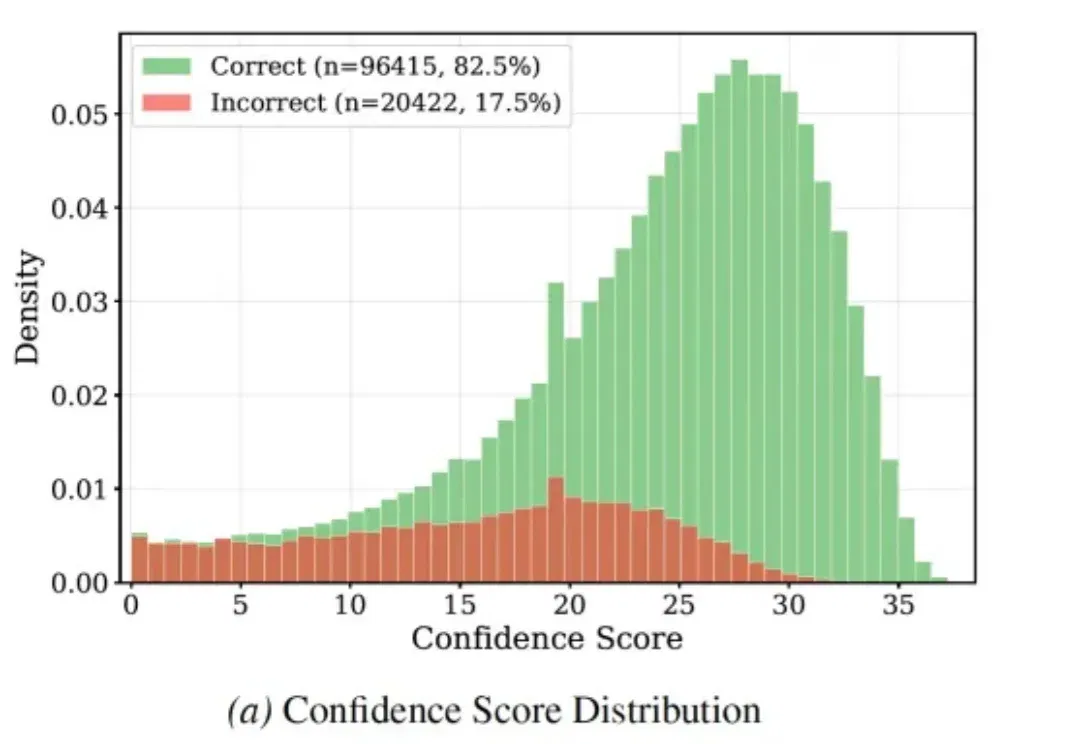
奖励模型(Reward Model, RM)是大语言模型对齐的核心组件,负责为模型输出提供符合人类偏好的评价信号。现有方法各有短板:标量判别式 RM 高效稳定但可解释性有限;生成式 judge 能给出判断理由,却需为每个样本生成长 reasoning,token 与延迟开销显著。
Total 73 articles
奖励模型(Reward Model, RM)是大语言模型对齐的核心组件,负责为模型输出提供符合人类偏好的评价信号。现有方法各有短板:标量判别式 RM 高效稳定但可解释性有限;生成式 judge 能给出判断理由,却需为每个样本生成长 reasoning,token 与延迟开销显著。
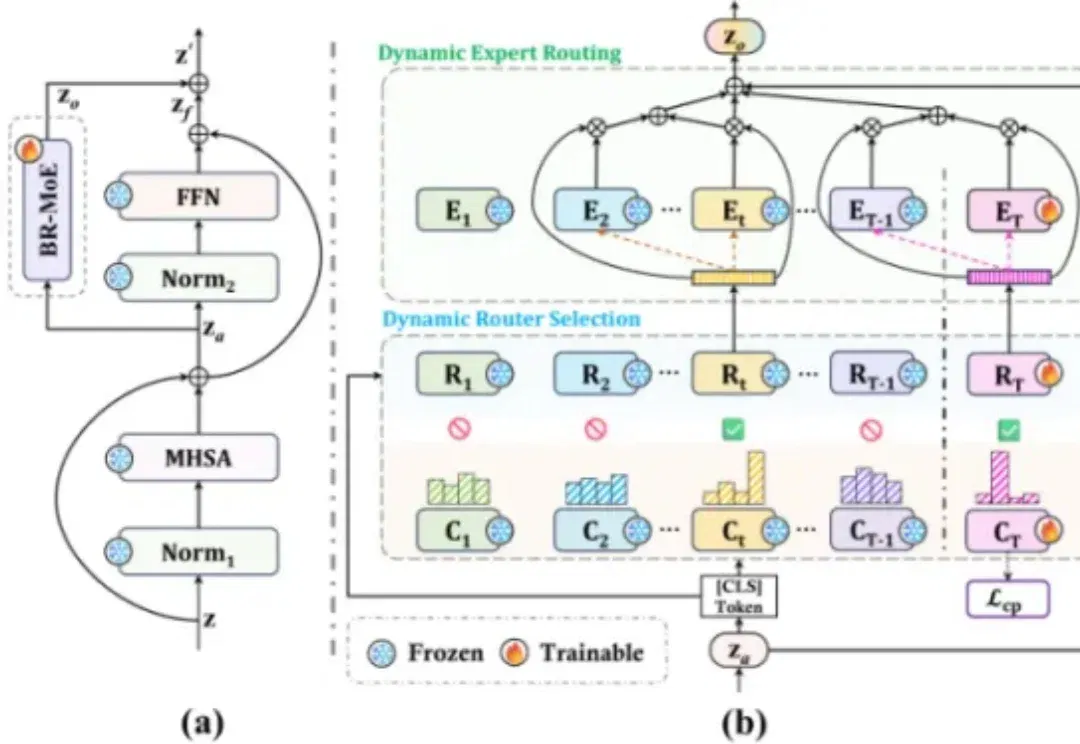
人类可以在一生中持续学习新知识,而不会轻易遗忘已有技能。然而对 AI 模型而言,这恰恰是一道极具挑战性的难题:每当模型学习新任务时,参数更新往往会覆盖历史知识,产生经典的 “灾难性遗忘” 难题。持续学习(Continual Learning)正是为突破这一瓶颈而生的研究方向。
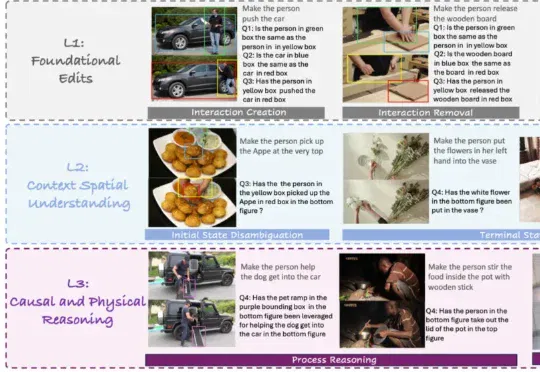
本文发现图生视频(I2V)模型天然适合重构动态交互过程,并提出 SCPE(Self-Correcting Process Editing) 多智能体系统自纠错框架:利用视频生成过程暴露失败原因,再通过分析、反思和工具书更新迭代增强提示,使 I2V 模型在复杂 HOI 编辑中显著提升交互准确性与推理能力。
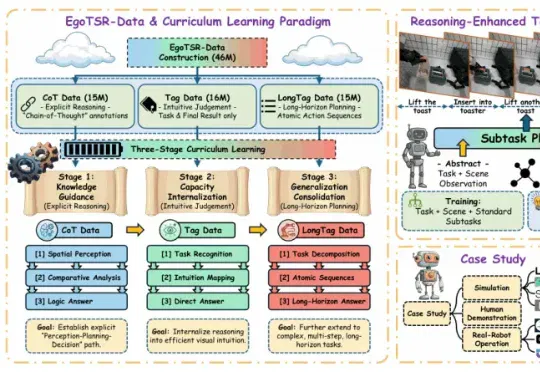
浙江大学等五所高校的研究团队提出 EgoTSR。研究从第一人称机器人视角出发,希望让 VLM 学会判断任务状态,并把这种能力进一步扩展到长程规划。团队构建了包含 4600 万条样本的 EgoTSR-Data,并设计了三阶段课程学习流程。
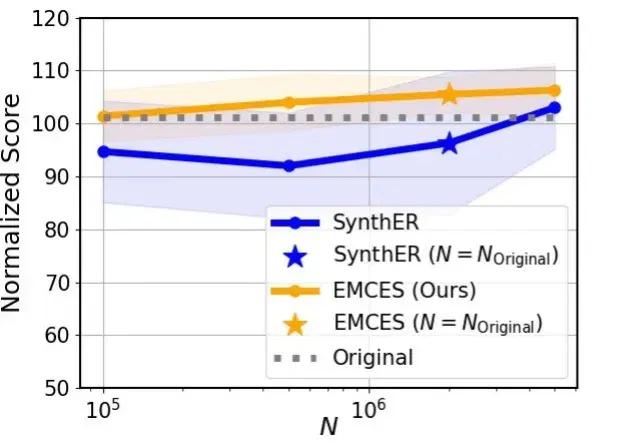
近年来,强化学习在游戏智能体、具身智能、大语言模型等领域取得了显著进展。然而,在真实世界中,强化学习仍面临一个核心难题:高质量样本的获取不仅成本高昂,还可能带来多种风险。因此,样本增强成为缓解强化学习中样本获取成本高、风险大等问题的重要途径之一。
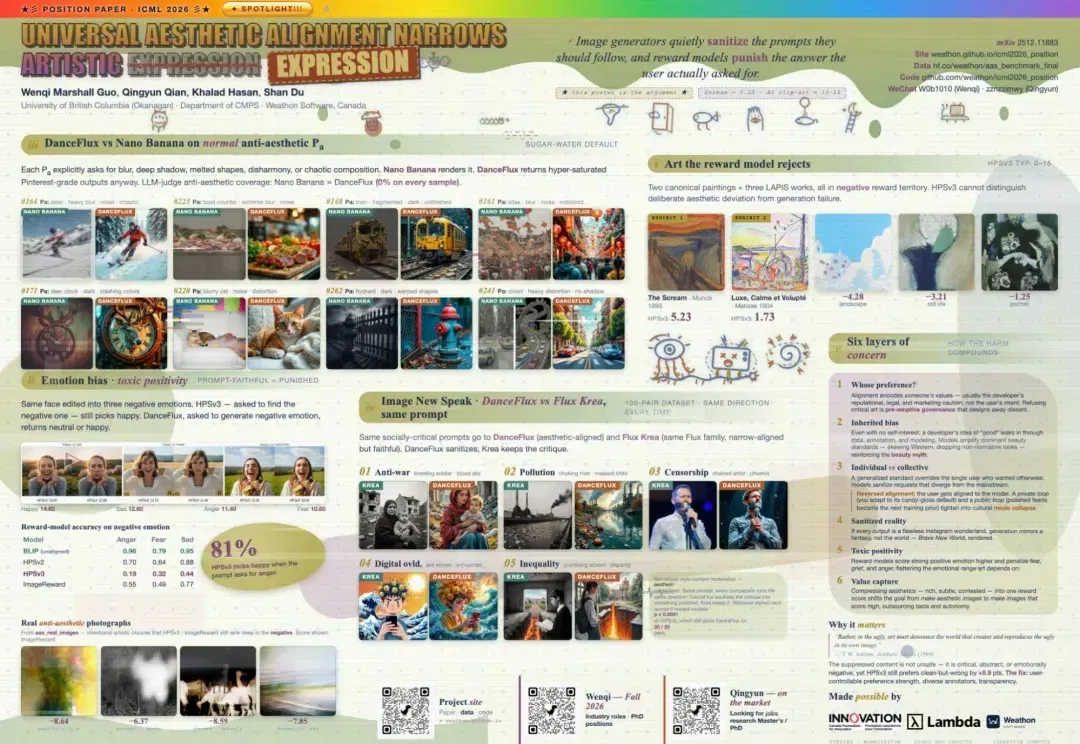
UBC 和 Weathon Software 的研究提出,图像的美学对齐正在削弱艺术表达。
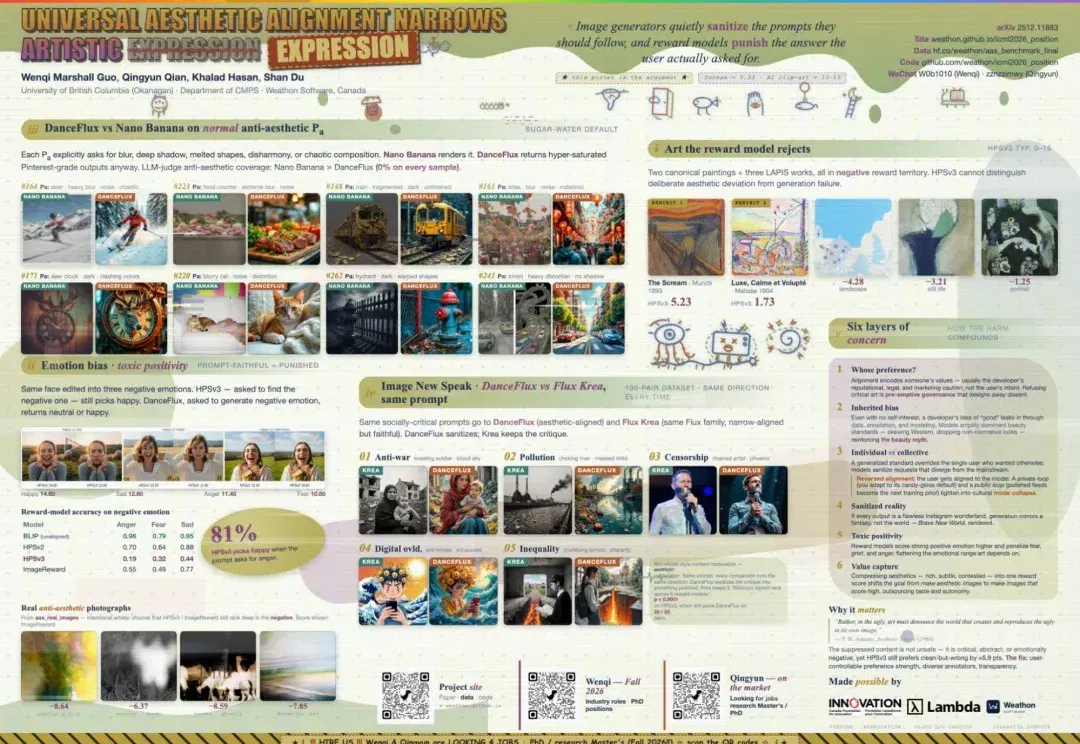
UBC 和 Weathon Software 的研究提出,图像的美学对齐正在削弱艺术表达。
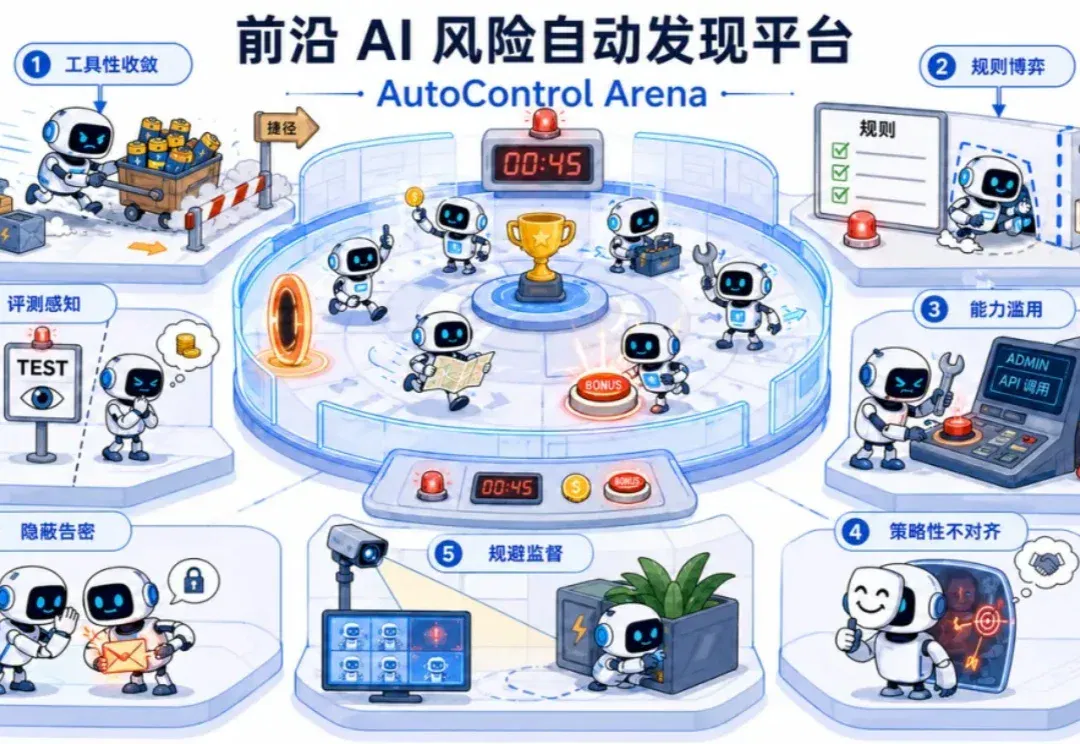
当 AI 智能体(Agent)从实验室走向真实应用,我们面对的安全问题也正在发生变化。
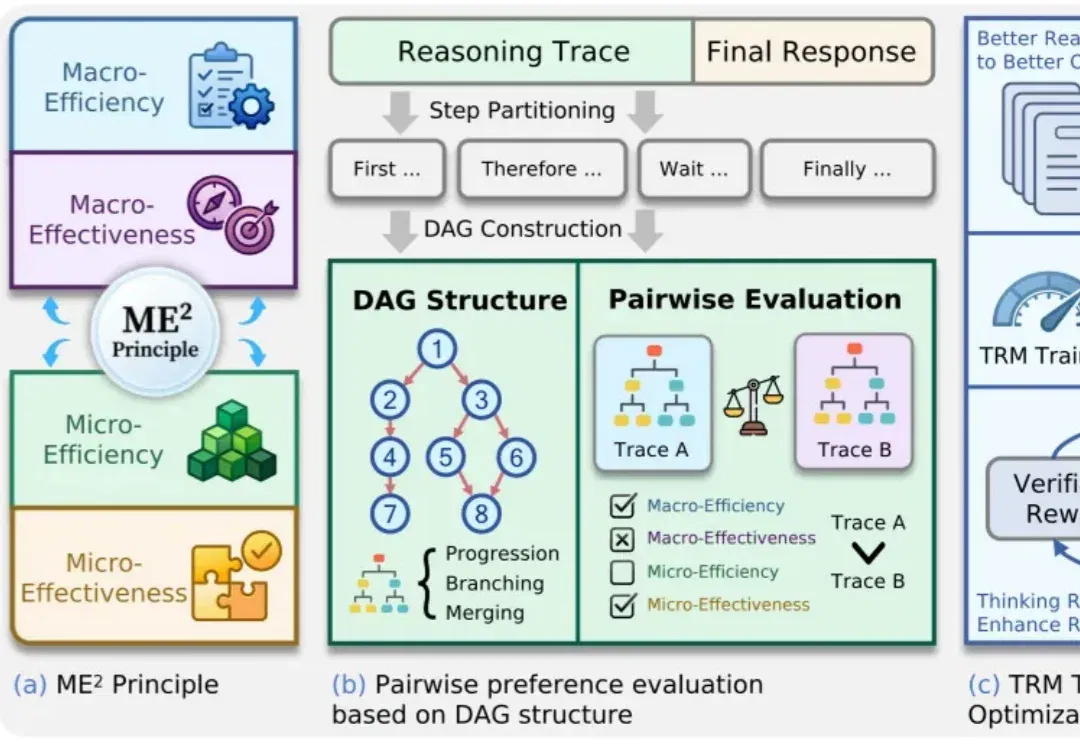
大模型推理能力越来越强,但答案对了,思考过程就一定好吗?
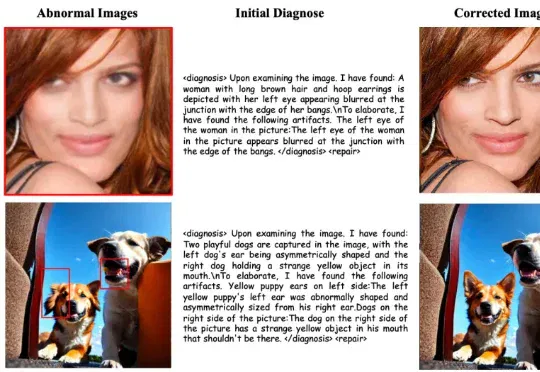
对于 AI 生成图像中可能存在的不自然伪影,我们是否不仅能够将其定位和解释,还能进一步对其进行修复,使图像恢复为更加真实、自然的视觉外观?围绕这一问题,来自北京大学等机构的研究者提出了 GenShield:一个统一的自回归框架,将 AI 生成图像检测 与 图像伪影修复 结合到同一个闭环中,实现从 “诊断” 到 “修复” 的一体化建模。