永别了,人类冠军!AI横扫天文奥赛,GPT-5得分远超金牌选手2.7倍 (opens in a new tab)
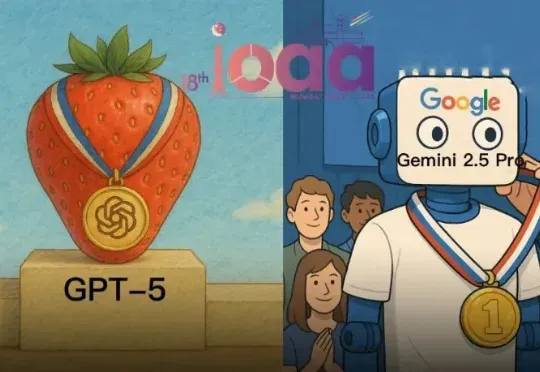
国际奥赛又一块金牌,被AI夺下了!在国际天文与天体物理奥赛(IOAA)中,GPT-5和Gemini 2.5 Pro完胜人类选手,在理论和数据分析测试中,拿下了最高分。在理论考试上,Gemini 2.5 Pro总体得分85.6%,GPT-5总体得分84.2%;
Total 80 articles
国际奥赛又一块金牌,被AI夺下了!在国际天文与天体物理奥赛(IOAA)中,GPT-5和Gemini 2.5 Pro完胜人类选手,在理论和数据分析测试中,拿下了最高分。在理论考试上,Gemini 2.5 Pro总体得分85.6%,GPT-5总体得分84.2%;
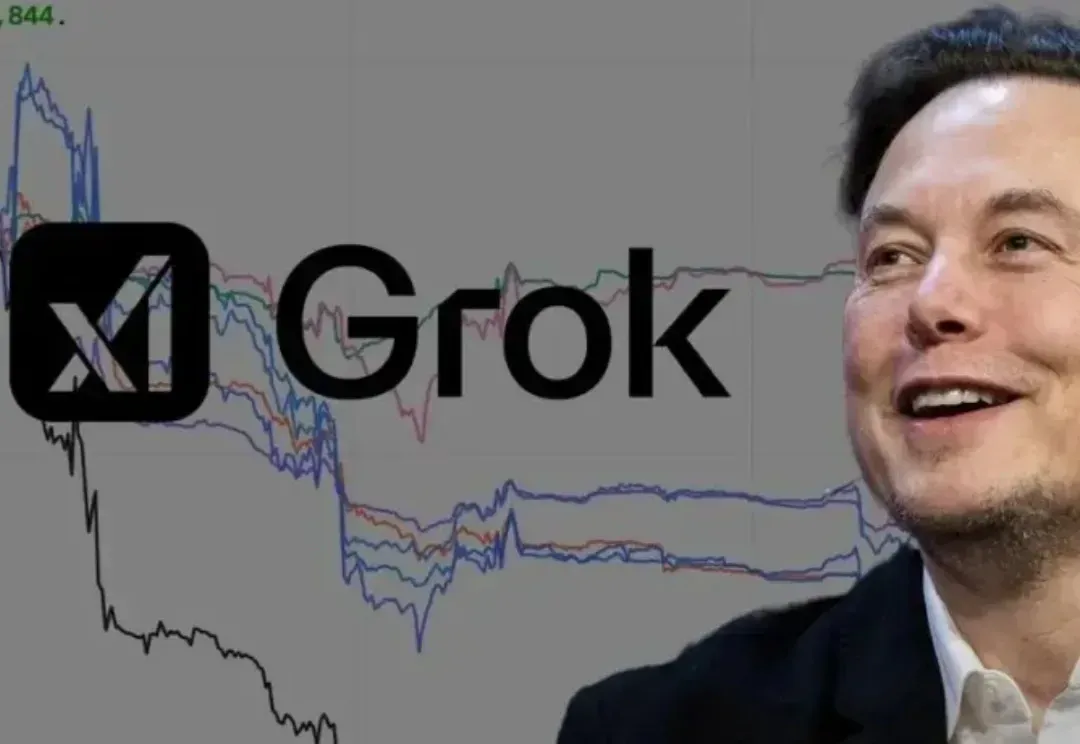
在Alpha Arena 1.5赛季的美股真金白银实盘中,Grok 4.20完胜GPT-5.1和Gemini 3.0 Pro等一众顶流模型,在对手全线亏损的情况下,独自斩获了12.11%的正收益。成功背后的秘密是Grok对X的推文反映的市场情绪的及时精准捕捉。
最近,视频会议软件公司 Zoom 发布了一条出人意料的消息:他们宣称在“人类最后的考试”(Humanity s Last Exam,简称 HLE)这个号称当前 AI 领域最具挑战性的基准测试上,取得了 48.1% 的成绩,比此前由 Google Gemini 3 Pro(带工具)保持的 45.8% 高出 2.3 个百分点。
谷歌Antigravity团队公布Teamwork多智能体编排框架成果,轻量级Gemini 3.7 Flash复现了Gemini 3.1 Pro解出的3道博士级数学难题,并从零构建RISC-V CPU模拟器、改进Eigen和ParlayHash开源库代码,证明小模型通过制度化博弈编排也能完成顶尖科研与工程任务。
宾夕法尼亚大学沃顿商学院(The Wharton School)今年发布了一系列名为《Prompting Science Reports》的重磅研究报告。他们选取了2024-2025最常用的模型(如GPT-4o, Claude 3.5 Sonnet, Gemini Pro/Flash等),在极高难度的博士级基准测试(GPQA Diamond)上进行了数万次的严谨测试。
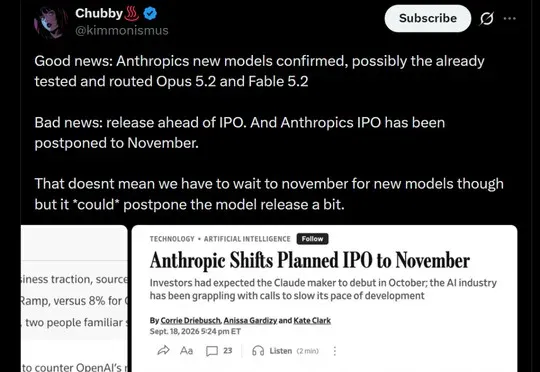
Anthropic、谷歌、OpenAI、Kimi、DeepSeek及阿里Qwen等全球AI大厂正密集备战,在中秋国庆假期前后集中推出或预告Claude 5.2、Gemini 4 Pro、Kimi K3.1、DeepSeek V4.1 Pro、Qwen4等旗舰基模,集体围攻OpenAI此前发布的GPT-6 Astra。
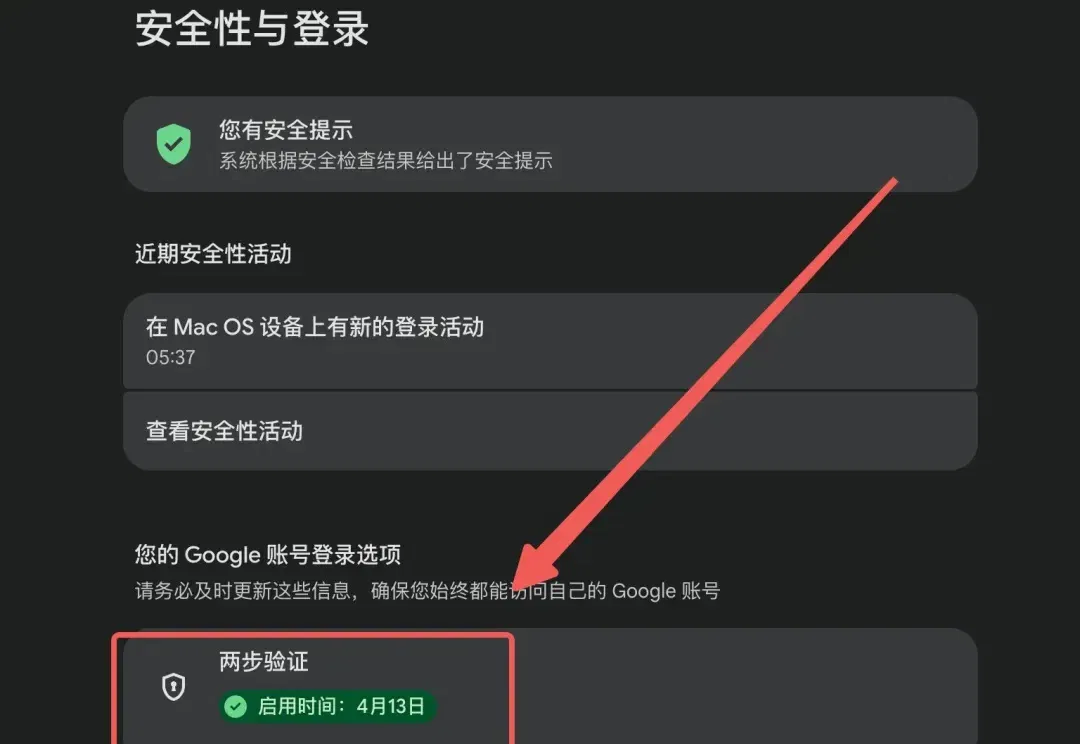
去年带大家靠学生优惠白嫖了一年的 Gemini Pro,前几天发邮件提醒我快到期了。
2月以来,OpenClaw(前身为Clawdbot、Moltbot)卷疯AI圈。在2月21日OpenClaw发布的最新版本中,正式接入了Google Gemini 3.1 Pro预览版,还将Discord引入实时语音与连续路由功能。
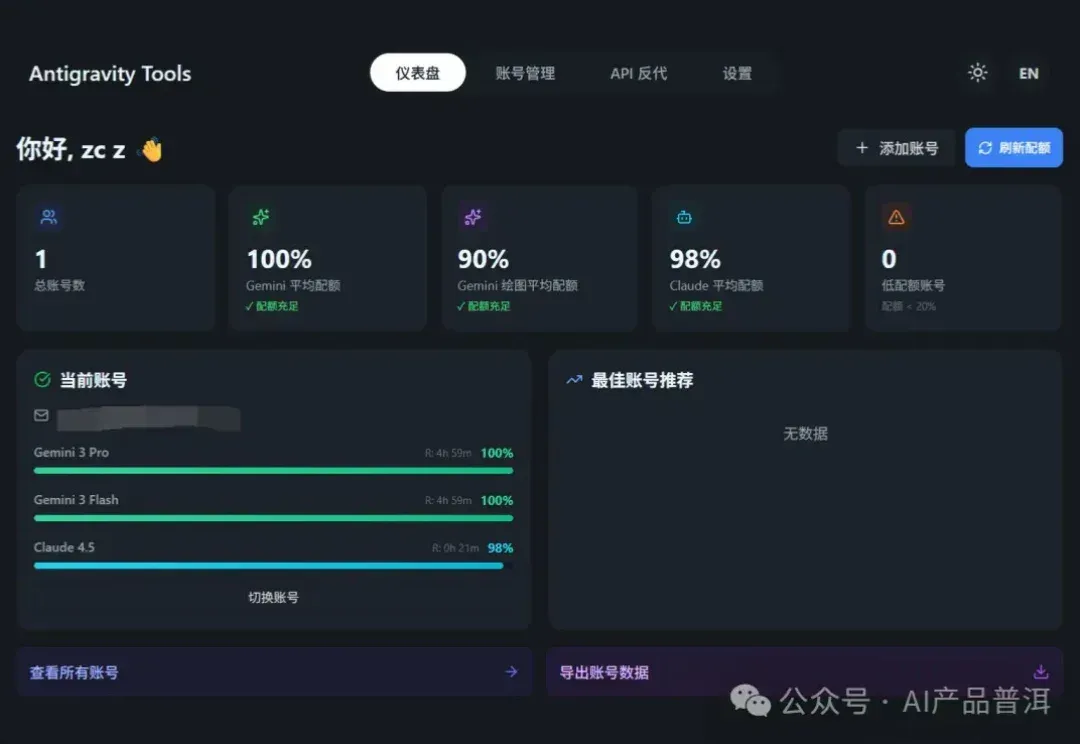
上上周跟大家盘了 Gemini 学生教育优惠。
AI一分钟,人类十年功! 一觉醒来,AI推理模型已横扫特许金融分析师CFA考试。在一级考试中,Gemini 3.0 Pro创下97.6%的历史最高纪录。二级考试中,GPT-5以94.3%的成绩领先。