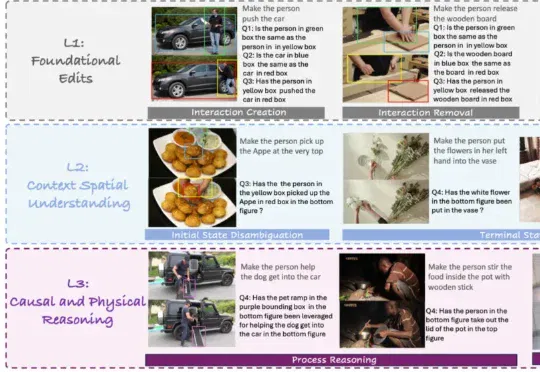
ICML 2026 | 图像编辑进入「交互理解」时代,北大提出HOI-Edit基准与SCPE自纠错框架 (opens in a new tab)
本文发现图生视频(I2V)模型天然适合重构动态交互过程,并提出 SCPE(Self-Correcting Process Editing) 多智能体系统自纠错框架:利用视频生成过程暴露失败原因,再通过分析、反思和工具书更新迭代增强提示,使 I2V 模型在复杂 HOI 编辑中显著提升交互准确性与推理能力。
Total 56 articles
本文发现图生视频(I2V)模型天然适合重构动态交互过程,并提出 SCPE(Self-Correcting Process Editing) 多智能体系统自纠错框架:利用视频生成过程暴露失败原因,再通过分析、反思和工具书更新迭代增强提示,使 I2V 模型在复杂 HOI 编辑中显著提升交互准确性与推理能力。
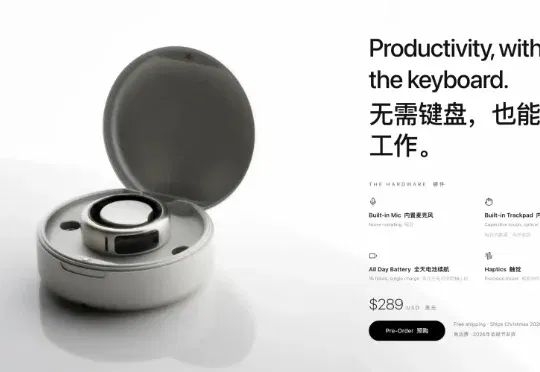
就在前几天,一家名为 Oasis Devices 的迈阿密初创公司,发布了一款专门适用于不方便打字也不方便大声说话的新 AI 录音听写硬件,OASIS 1 智能戒指。这枚售价 289 美元的钛合金戒指,最大的卖点,就是把 Wispr Flow 的 AI 听写技术,从一个放在手机上的 App 里,转到了一个离我们嘴巴更近的载体里。
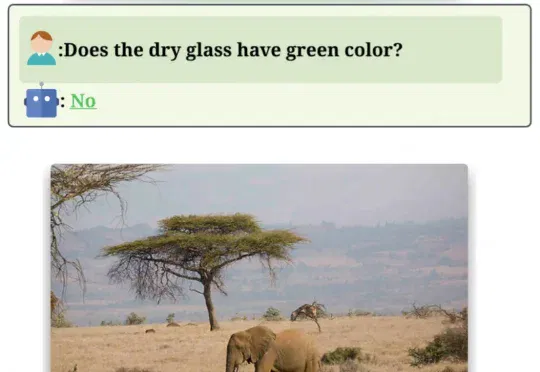
来自上海交大、马来亚大学、CMU、MBZUAI、KIT和KAUST的团队提出VisNec(Visual Necessity Score,视觉必要性分数),用一个分数衡量每条训练样本里“图像到底起了多大作用”,被ECCV 2026收录。
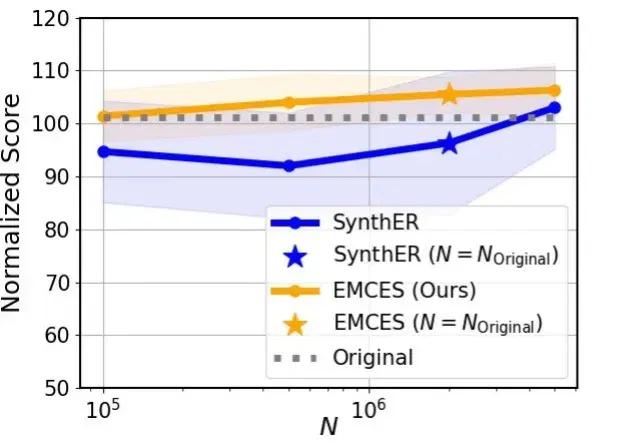
近年来,强化学习在游戏智能体、具身智能、大语言模型等领域取得了显著进展。然而,在真实世界中,强化学习仍面临一个核心难题:高质量样本的获取不仅成本高昂,还可能带来多种风险。因此,样本增强成为缓解强化学习中样本获取成本高、风险大等问题的重要途径之一。
飞拓星驰(FitX AI)宣布完成数百万美金融资,由日初资本领投,光点资本跟投。这笔融资将用于Fit-OS空间智能 Agent 平台的研发,以及首款客厅 AI Native 终端的量产准备——预计 2027 年 CES 全球首发。
4 月 10 日晚,灵初智能发布了大模型、数据集与合作计划:包括策略模型 Psi-R2、世界模型 Psi-W0,以及总规模近 10 万小时的人类操作数据。它想回答的问题也很直接 —— 当真机数据不再是唯一解,机器人还能靠什么继续 scaling?
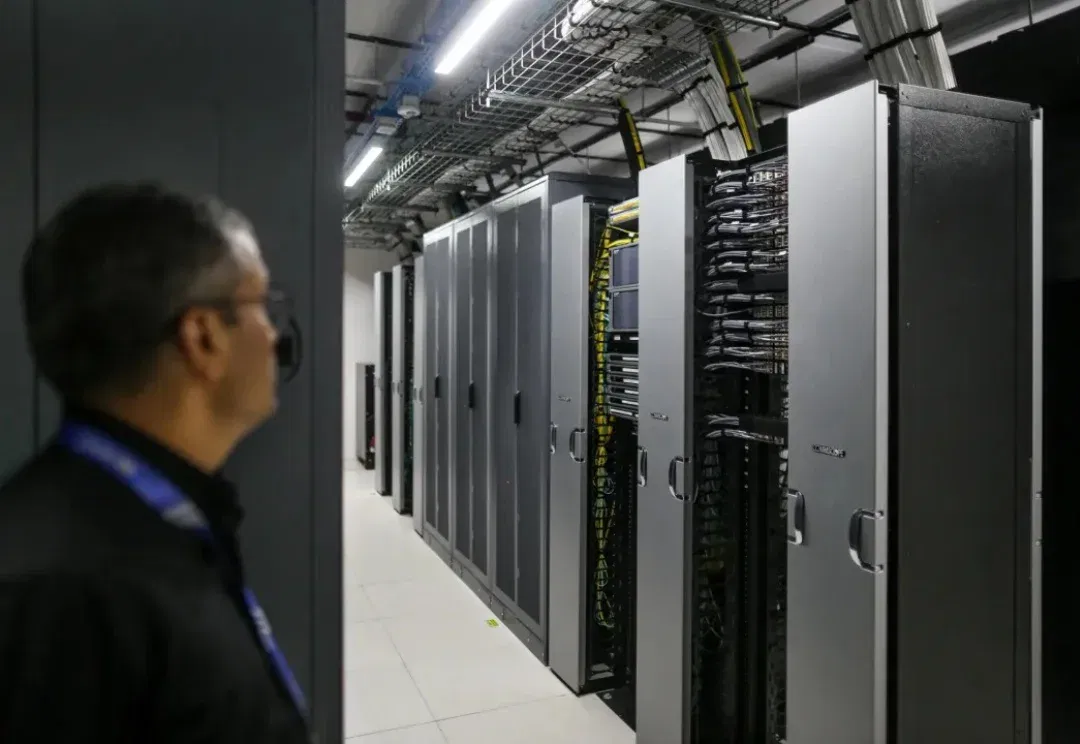
Yotta Data Services Pvt. 作为运营印度最大规模英伟达公司人工智能处理器集群的数据中心运营商,正寻求以约 40 亿美元估值进行新一轮融资,同时准备提交首次公开募股的招股说明书草案。
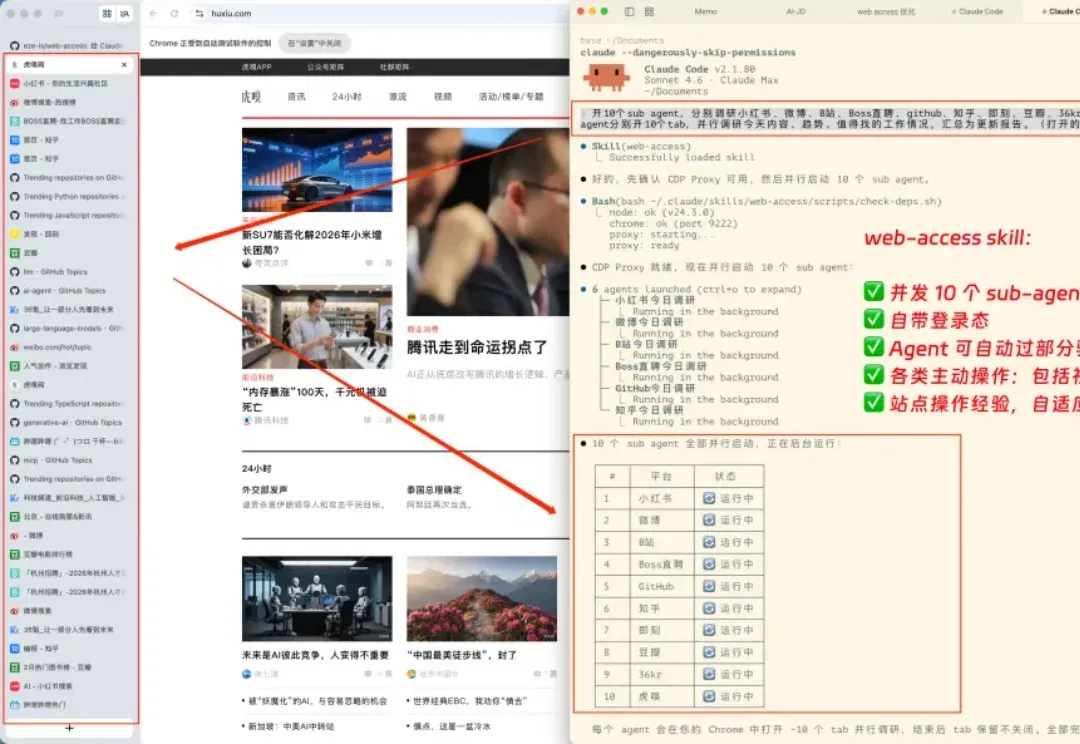
这个 Skill,能让你的 Agent 联网能力提升到最离谱的一集。
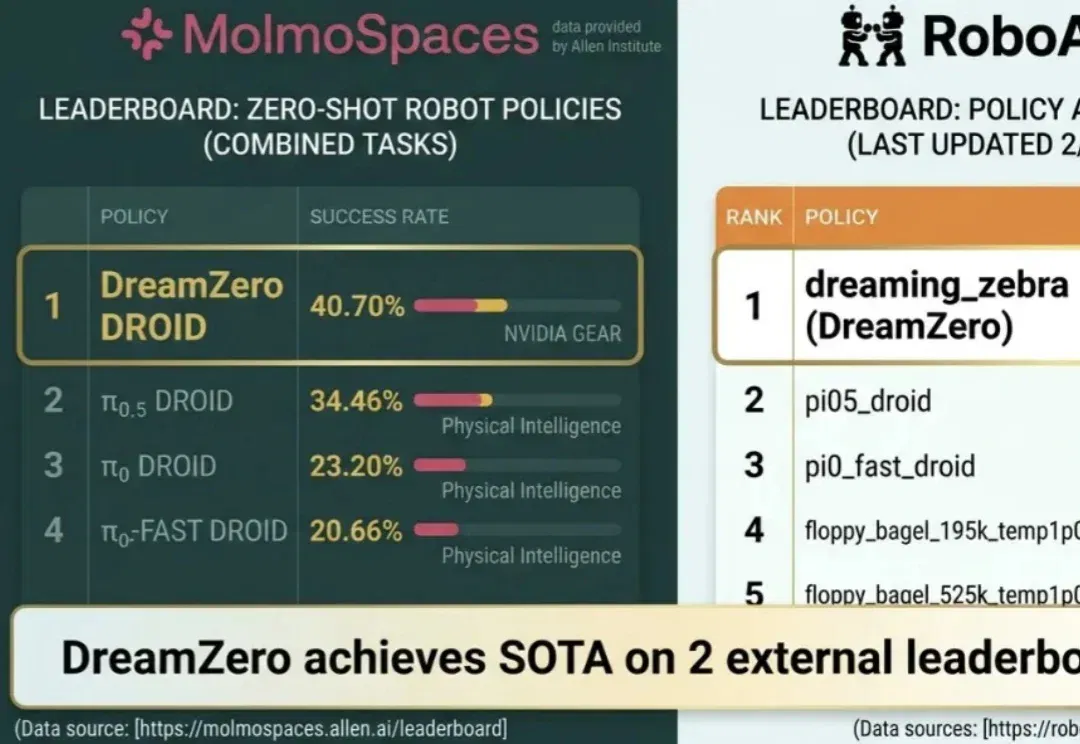
近日,NVIDIA 发布的世界 - 动作模型 DreamZero,在两项颇具代表性的机器人基准测试 RoboArena 、MolmoSpaces 上双双登顶。
年化经常性收入已达699亿。 智东西2月13日报道,今天凌晨,AI独角兽Anthropic宣布已完成300亿美元(约合人民币2070.19亿元)G轮融资,投后估值达3800亿美元(约合人民币2.62万亿元),公司年化经常性收入已达140亿美元(约合人民币699.09亿元),在过去三年中每年平均增长超10倍。 ▲Anthropic公告(来源:X) 据Anthropic公告透露,本次融资的资金将助力前沿研究、产品开发及基础设施扩建,目前Claude是唯一在三大全球云平台Amazon Web Services Bedrock、Google Cloud Vertex AI、Microsoft Azur