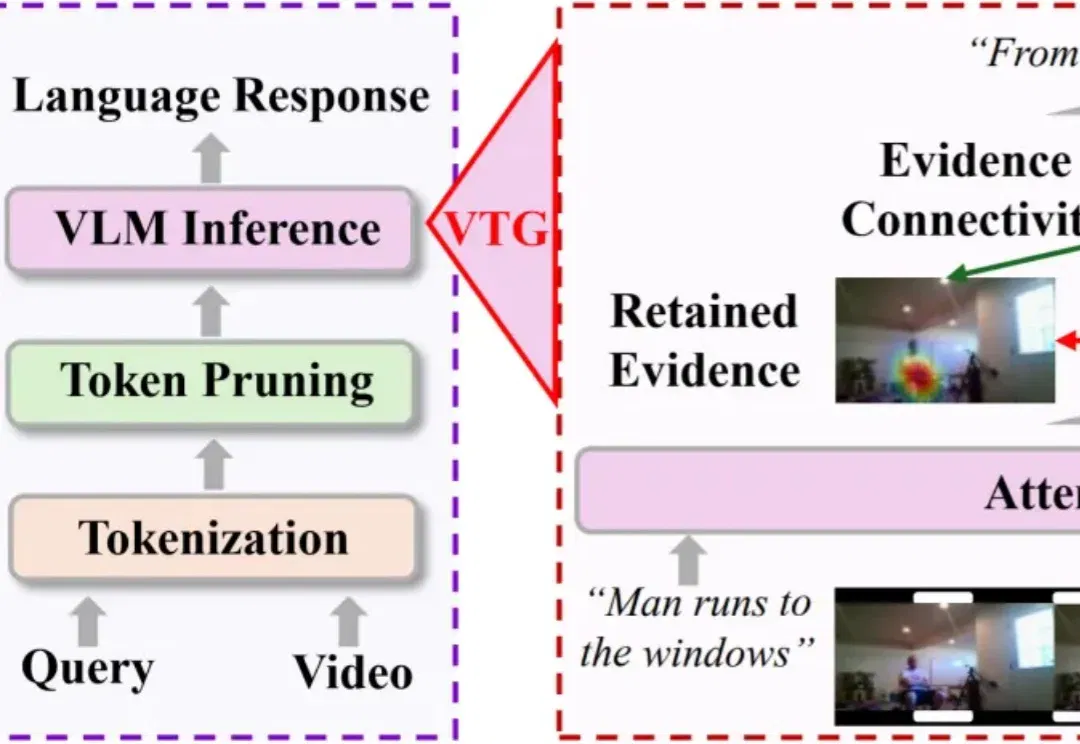
三类视觉Token分配,能直接解决高压缩时序碎片化 | ECCV‘26 (opens in a new tab)
长视频理解,正在成为多模态大模型的重要能力。
Total 37 articles
长视频理解,正在成为多模态大模型的重要能力。
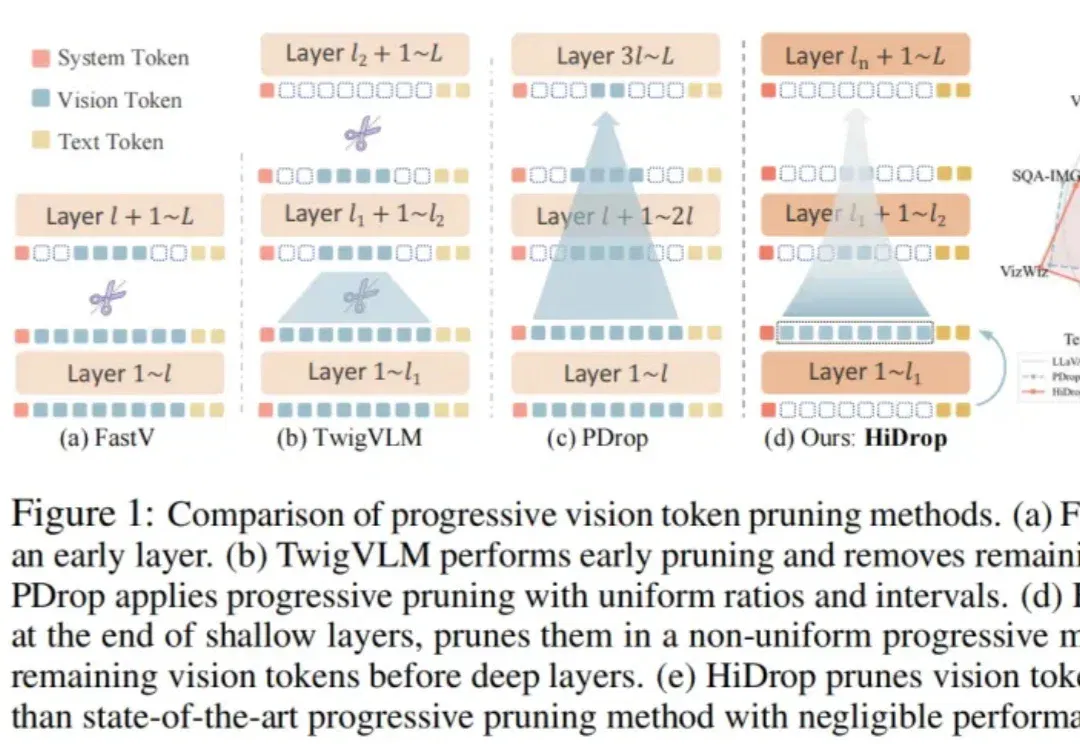
随着多模态大语言模型(MLLM)支持更长上下文,高分辨率图像和长视频会产生远多于文本的视觉 Token,在自注意力二次复杂度下迅速成为效率瓶颈。
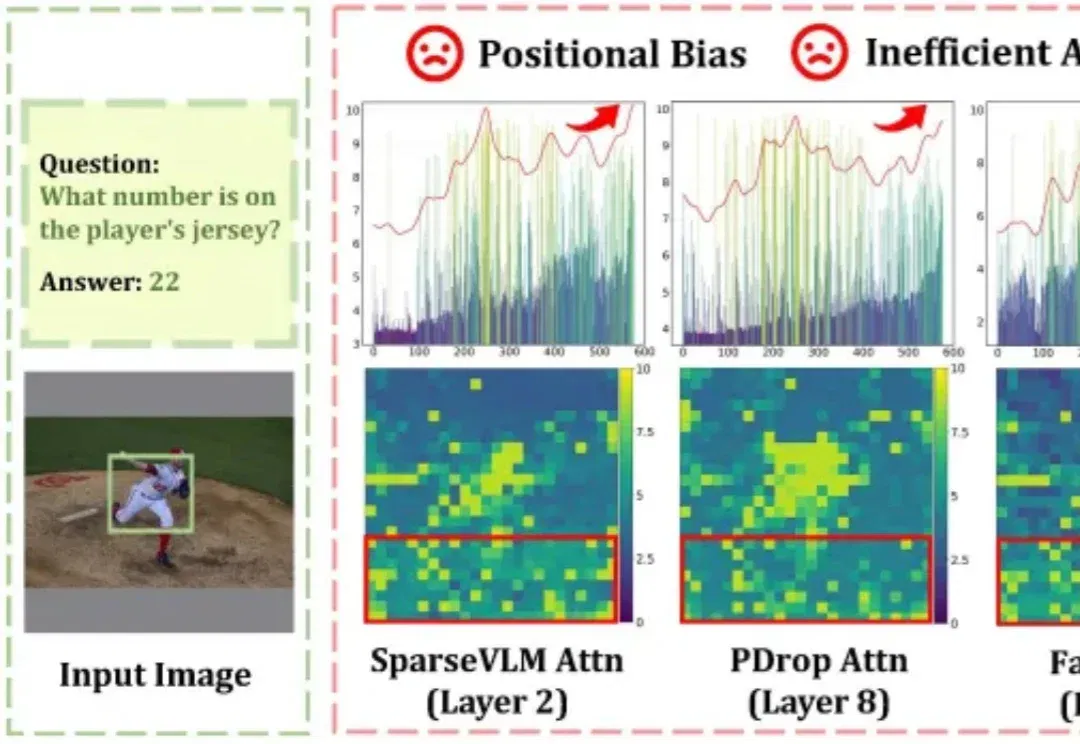
随着高分辨率图像理解与长视频处理需求的爆发式增长,大型视觉语言模型(LVLMs)所需处理的视觉 Token 数量急剧膨胀,推理效率成为落地部署的核心瓶颈。Token 压缩是缩短序列、提升吞吐的直接手段,但现有方法普遍依赖注意力权重来判断 Token 重要性,这一路线暗藏两个致命缺陷:
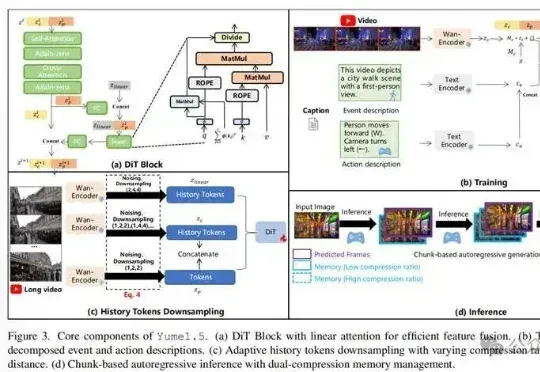
上海AI Lab联合多家机构开源的Yume1.5,针对这一核心难题提出了时空信道联合建模(TSCM),在长视频生成中实现了近似恒定计算成本的全局记忆访问。
去年,谢赛宁(Saining Xie)团队发布了 Cambrian-1,一次对图像多模态模型的开放式探索。但团队没有按惯例继续推出 Cambrian-2、Cambrian-3,而是停下来思考:真正的多
TC-Light 是由中科院自动化所张兆翔教授团队研发的生成式渲染器,能够对具身训练任务中复杂和剧烈运动的长视频序列进行逼真的光照与纹理重渲染,同时具备良好的时序一致性和低计算成本开销,使得它能够帮助减少 Sim2Real Gap 以及实现 Real2Real 的数据增强,帮助获得具身智能训练所需的海量高质量数据。
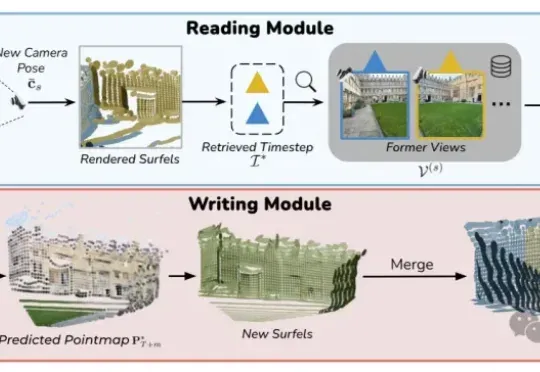
VMem用基于3D几何的记忆索引替代「只看最近几帧」的短窗上下文:检索到的参考视角刚好看过你现在要渲染的表面区域;让模型在小上下文里也能保持长时一致性;实测4.2s/帧,比常规21帧上下文的管线快~12倍。