大模型开挂了!64量子比特,让11亿参数模型逆袭80亿 (opens in a new tab)
加拿大蒙特利尔大学、Mila 人工智能研究所和麦吉尔大学团队提出 HyperQ,以逐 Token 自适应量子电路增强扩散语言模型,使 11 亿参数模型在六项零样本测试中超过 Qwen3-8B 等 80 亿参数模型,并在 IBM 156 量子比特量子集群完成验证。
Total 38 articles
加拿大蒙特利尔大学、Mila 人工智能研究所和麦吉尔大学团队提出 HyperQ,以逐 Token 自适应量子电路增强扩散语言模型,使 11 亿参数模型在六项零样本测试中超过 Qwen3-8B 等 80 亿参数模型,并在 IBM 156 量子比特量子集群完成验证。
推理大模型 (如 DeepSeek-R1、o1) 靠长思维链拿高分,却普遍「想太多」: 研究统计了五个代表性模型里,发现有 41–52% 的 token 是在模型给出它的最终答案之后生成的。
Pixel 擅长表达 appearance,Code 擅长表达 structure;未来会进入 Pixel-Code 联合的视觉表达。
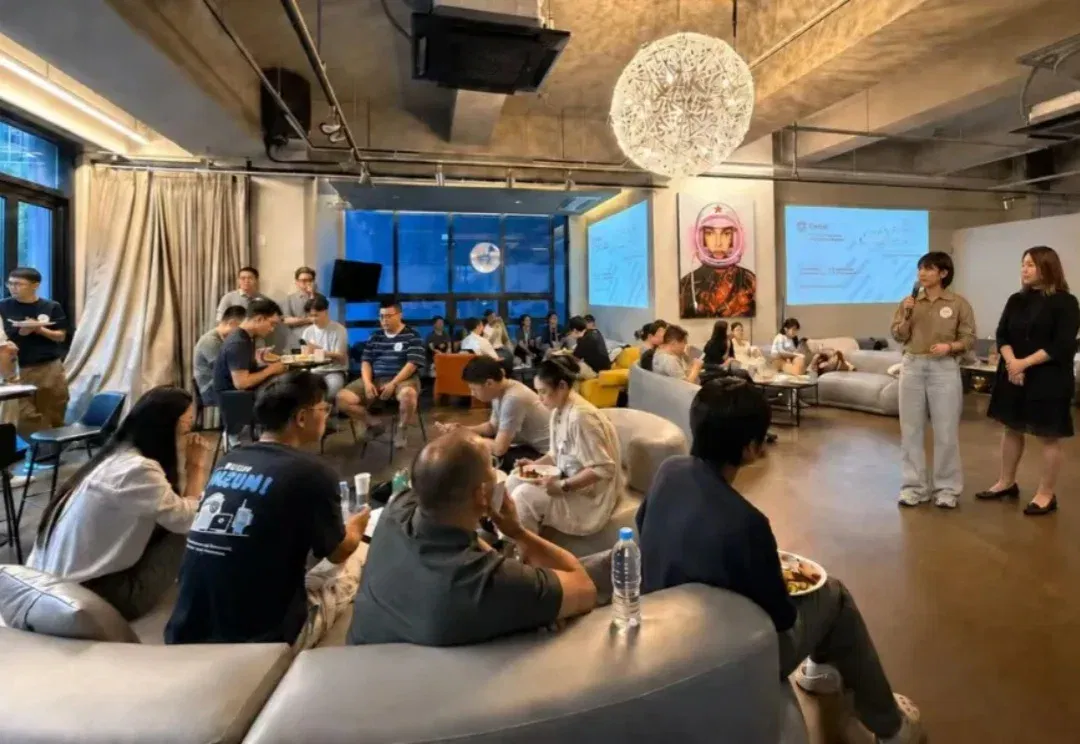
ICML 2026落幕了。 但今年最有意思的讨论,很多并没有发生在Session里。 Coffee Break的走廊上、Poster板前、晚餐桌边——来自全球Frontier AI Labs、顶尖高校、创业公司和投资机构的研究者们,聊的早已不只是论文本身: 下一代扩散语言模型还有多大空间?世界模型的机会到底在哪?当Agent开始参与研究流程,科研本身会变成什么样? 这些还没写进论文的思考,往往才是下一轮共识的起点。 就在本次ICML期间,九坤创投发起的Global AI Bridge组织了三场小规模闭门交流。 其中有ICML杰出论文奖得主,有Frontier Lab研究员,有华为天才少年,也有
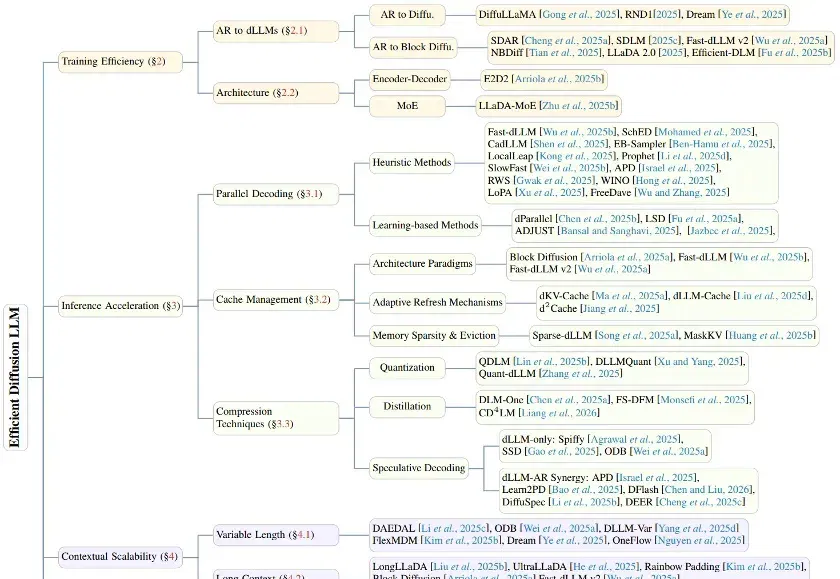
在生成式 AI 的浪潮中,自回归(Autoregressive, AR)模型凭借其卓越的性能占据了统治地位。然而,其「从左到右」逐个预测 Token 的串行机制,天生限制了并行生成的可能性。
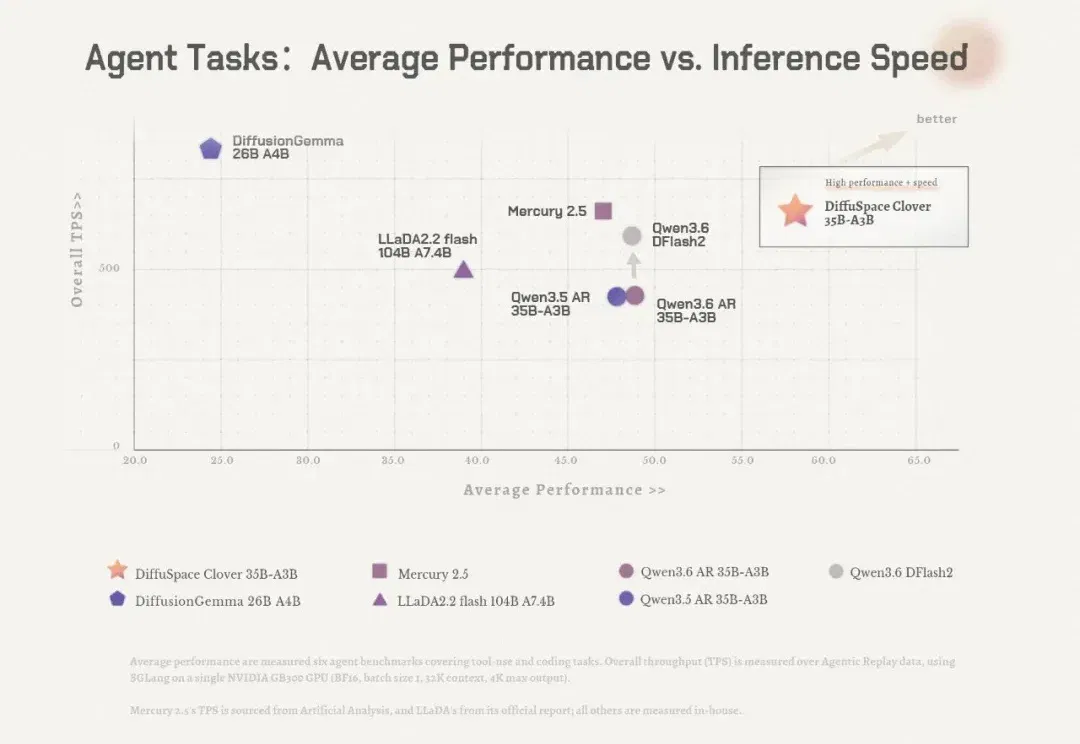
Clover-35B-A3B-Preview 以块内并行去噪和历史状态复用提高生成效率。团队报告编程、工具使用及端侧量化结果,并介绍双向交互与联合决策探索。单用户生成速度与整机吞吐不同,性能比较受硬件、精度、框架和任务设置影响。
今年,由倪赞林担任第一作者,王慎执、乐洋共同参与的《The Flexibility Trap》获得 ICML 2026 Outstanding Paper Award。ICML 2026 投稿量达到创纪录的 24,000+ 篇,仅评出 2 篇 Outstanding Paper,该论文成为ICML历史上首篇完全由国内单位学者完成的获奖成果,为更好地理解和设计扩散语言模型做出了重要贡献。
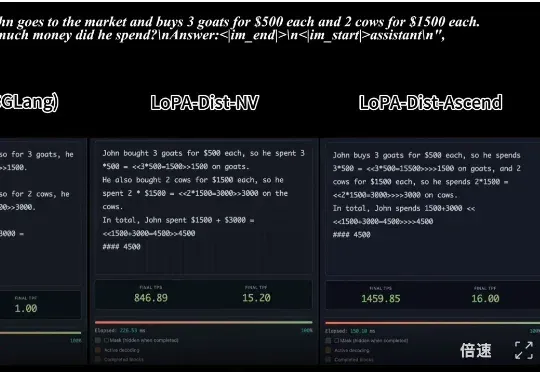
,时长 00:20 视频 1:单样例推理速度对比:SGLang 部署的 Qwen3-8B (NVIDIA) vs. LoPA-Dist 部署 (NVIDIA & Ascend)(注:NVIDIA 平台