Search

Results for “多模态大模型”

Total 85 articles

PrimalVerse(元昊动力)完成数亿元种子轮融资,清华教授要做4D世界模型

PrimalVerse(元昊动力)完成数亿元种子轮融资,清华教授要做4D世界模型 (opens in a new tab)

联想之星、银杏谷资本、啟赋资本等投了。 机器人前瞻7月23日报道,今天,PrimalVerse(元昊动力)宣布完成数亿元种子轮融资,由联想之星、银杏谷资本、啟赋资本、卓源亚洲等知名财务投资机构联合参与,手术机器人领域头部产业方精锋医疗战略投资。 据悉,PrimalVerse本轮融资资金将主要用于4D世界模型基模研发及团队扩充,并持续推进其在具身智能、游戏影视、自动驾驶、医疗手术等垂直场景中的应用验证。 PrimalVerse于2026年在北京成立,专注于第五代多模态4D世界模型基模研发,致力于将3D/4D重建、神经渲染、物理仿真与机器人技术融合。 该公司提出的第五代多模态大模型,是以原生4D
AI news
0
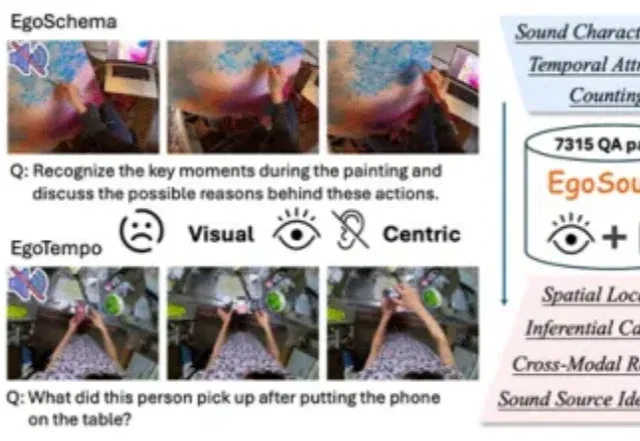
复旦等推出「第一人称视听基准」,补齐多模态模型「听觉拼图」

复旦等推出「第一人称视听基准」,补齐多模态模型「听觉拼图」 (opens in a new tab)

多模态大模型掉进真实世界,会“失聪”。 你把它放在厨房:背后有人说话、金属碰撞、蒸汽嘶嘶——画面里啥也没有,但声音已经把关键信息全透露了。此时最强模型也开始“失灵”:看得懂动作,听不懂发生了什么;能描述现象,推不出原因。 问题不是模型不会“看”,而是还不会真正“听”。 声音,从来不是配角 而在人类的日常认知里,声音从来不是配角: 它提供空间线索(声源左/右、远/近、是否移动)它揭示画面外事件(镜头外的对话、敲门、摔落、报警)它承载因果与意图(某个动作触发了某个声音;某个声音提示下一步行为) 但长期以来,第一人称视频理解基准高度“视觉中心化”:音频存在,但缺乏系统评测;听觉重要,却很少被认真考察

AI guides
0
ICLR 2026 | 让多模态模型学会主动说话:主动交互从训练到评估的完整方案

ICLR 2026 | 让多模态模型学会主动说话:主动交互从训练到评估的完整方案 (opens in a new tab)

本文综合北京大学王选计算机研究所发布的 ProactiveVideoQA 和 MMDuet2 两篇论文,介绍视频多模态大模型如何实现 “主动交互”—— 在视频播放过程中自主决定何时发起回复,而非等待用户提问。ProactiveVideoQA 提出评估指标和 benchmark,MMDuet2 则通过强化学习训练方法实现了 SOTA 性能,无需精确的回复时间标注即可训练出及时、准确的主动交互模型。

AI guides
0
刚刚智谱发布原生多模态大模型GLM-5.3-Flash:前沿智能进入普惠时代

刚刚智谱发布原生多模态大模型GLM-5.3-Flash:前沿智能进入普惠时代 (opens in a new tab)

今天,我们上线并开源GLM-5.3-Flash (320B-A18B),这是GLM-5系列的首个原生多模态模型。大家好像已经习惯将前沿智能与前沿价格绑定,并认为这是技术进步必须支付的成本。今天,GLM-5.3-Flash来了:320B总参数,能力超过GLM-5.2,在全球权威的Artificial Analysis Intelligence Index(AA综合智能指数)中取得57分

AI news
0
多模态大模型中Attention机制暗藏「骗局」,需用一个公式修正丨上大×南开

多模态大模型中Attention机制暗藏「骗局」,需用一个公式修正丨上大×南开 (opens in a new tab)

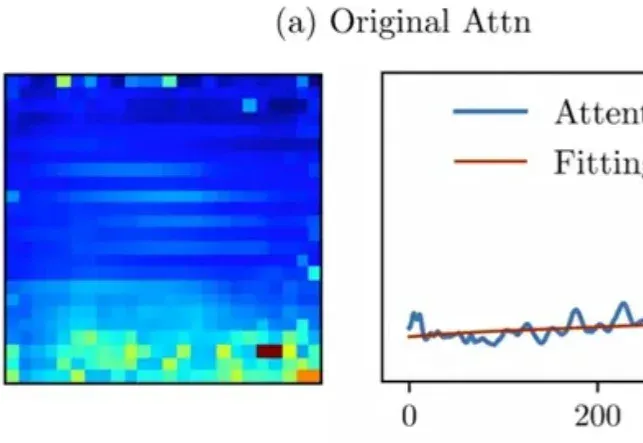
Attention真的可靠吗? 近年来,Vision-Language Models(VLMs)在多模态理解任务中取得了显著进展,尤其是在视觉问答、图像理解和视频理解等场景中,模型通常通过language-to-vision attention来衡量视觉token与文本之间的相关性,并据此进行visual token pruning,以降低推理成本、提升运行效率。 然而,一个长期被忽视的问题是:attention本身是否真的能够作为“语义重要性”的可靠指标? 在最新研究中,上海大学曾丹团队系统分析了主流VLM中attention的行为模式,发现一个关键却容易被忽略的现象——attention并

AI guides
0