来一手Qwen-Image-2.0实测,好像还不错?! (opens in a new tab)
BUBBLE 2026 — ISSUE #18 家人们, 马上没几天快过年了,明显各个厂商已经开始疯狂卷了。 上周到现在,让我们来算算有多少东西了, 5.3 Codex,4.6 Opus, 可灵3.0
Total 43 articles
BUBBLE 2026 — ISSUE #18 家人们, 马上没几天快过年了,明显各个厂商已经开始疯狂卷了。 上周到现在,让我们来算算有多少东西了, 5.3 Codex,4.6 Opus, 可灵3.0
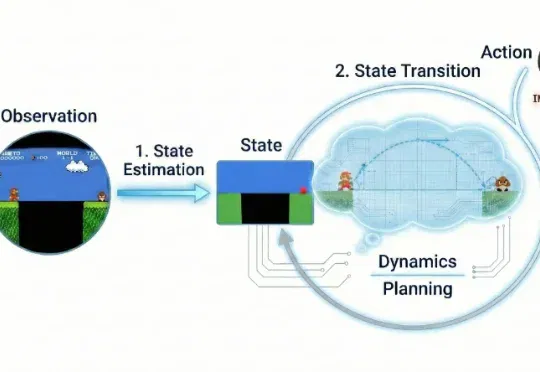
近年来,视频生成(Video Generation)与世界模型(World Models)已跃升为人工智能领域最炙手可热的焦点。从 Sora 到可灵(Kling),视频生成模型在运动连续性、物体交互与部分物理先验上逐渐表现出更强的「世界一致性」,让人们开始认真讨论:能否把视频生成从「逼真短片」推进到可用于推理、规划与控制的「通用世界模拟器」。
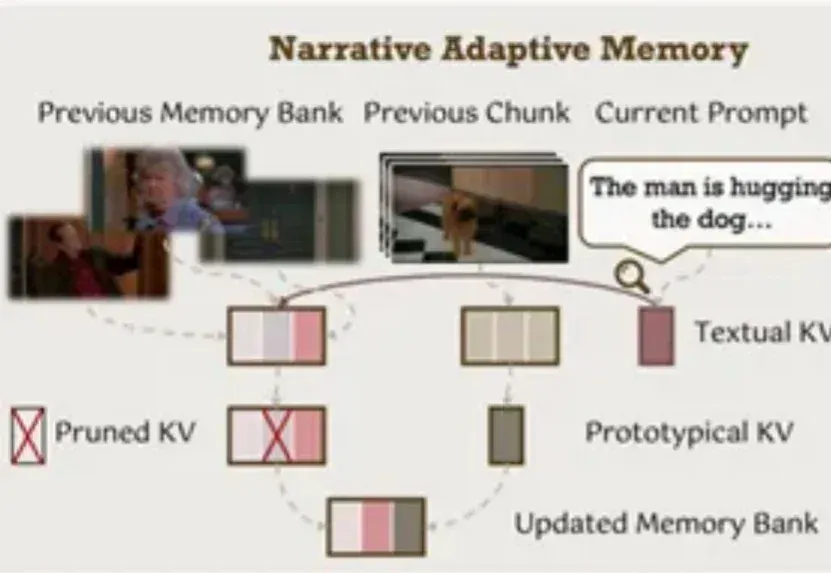
你是否曾被AI视频生成的不连贯性所困扰?
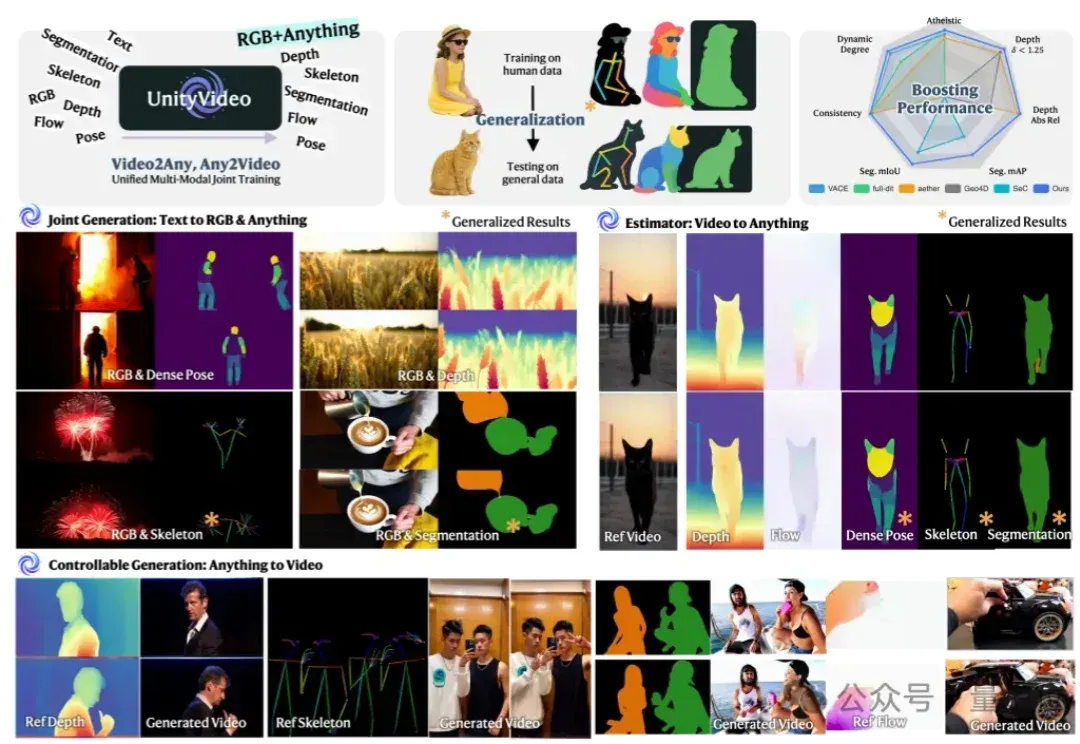
不仅能“听懂”物体的颜色纹理,还能“理解”深度图、人体姿态、运动轨迹……
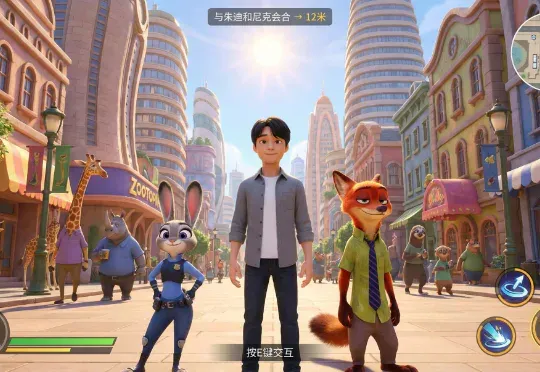
左下角的血条、右下角的小地图,还有这一连串丝滑的跑酷动作…… 看到这个画面,你是不是以为《疯狂动物城2》这边刚拿下中国影史进口动画片票房第一,那边就趁势要推出 3A 开放世界游戏了?甚至这光影和物理碰撞,比很多大厂的游戏都要真实。
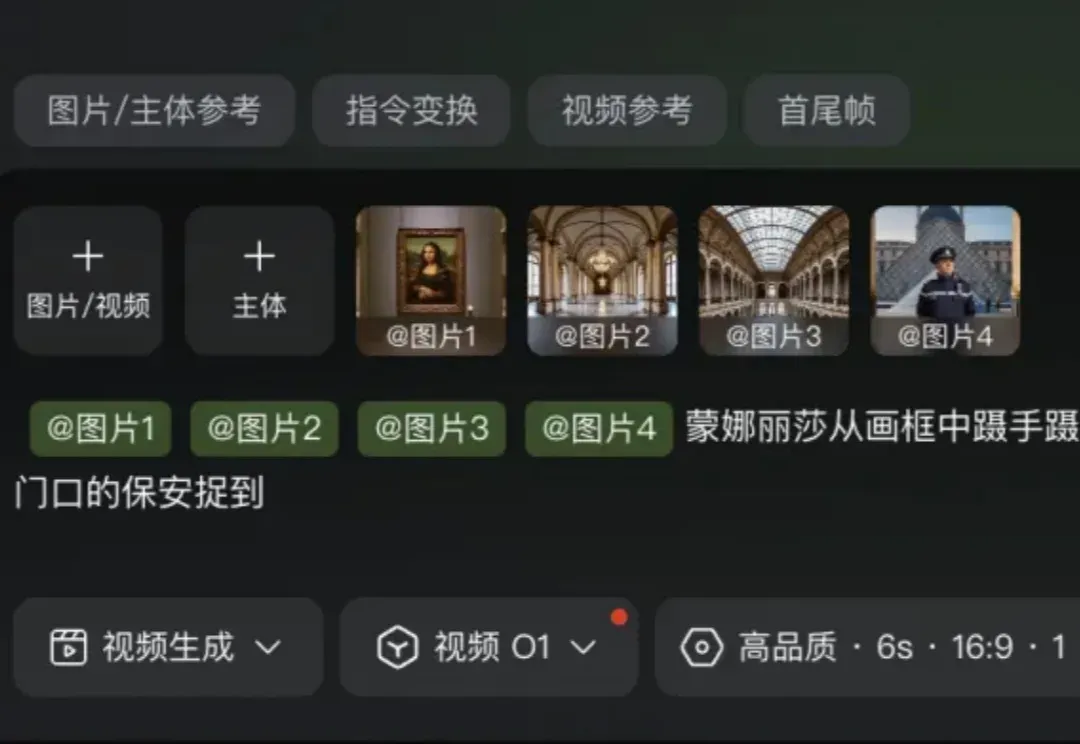
ChatGPT发布三周年,OpenAI没发布,各大AI玩家倒纷纷整出大活。
昨晚,AI视频领域,终于来了一点新东西。
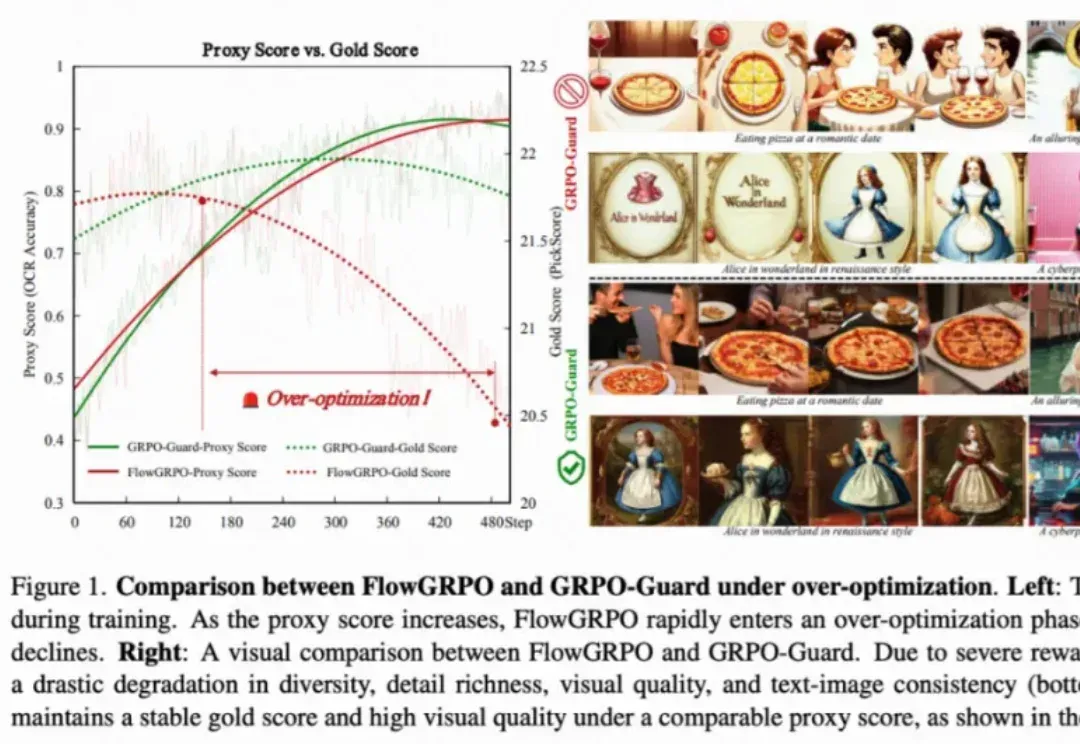
目前,GRPO 在图像和视频生成的流模型中取得了显著提升(如 FlowGRPO 和 DanceGRPO),已被证明在后训练阶段能够有效提升视觉生成式流模型的人类偏好对齐、文本渲染与指令遵循能力。
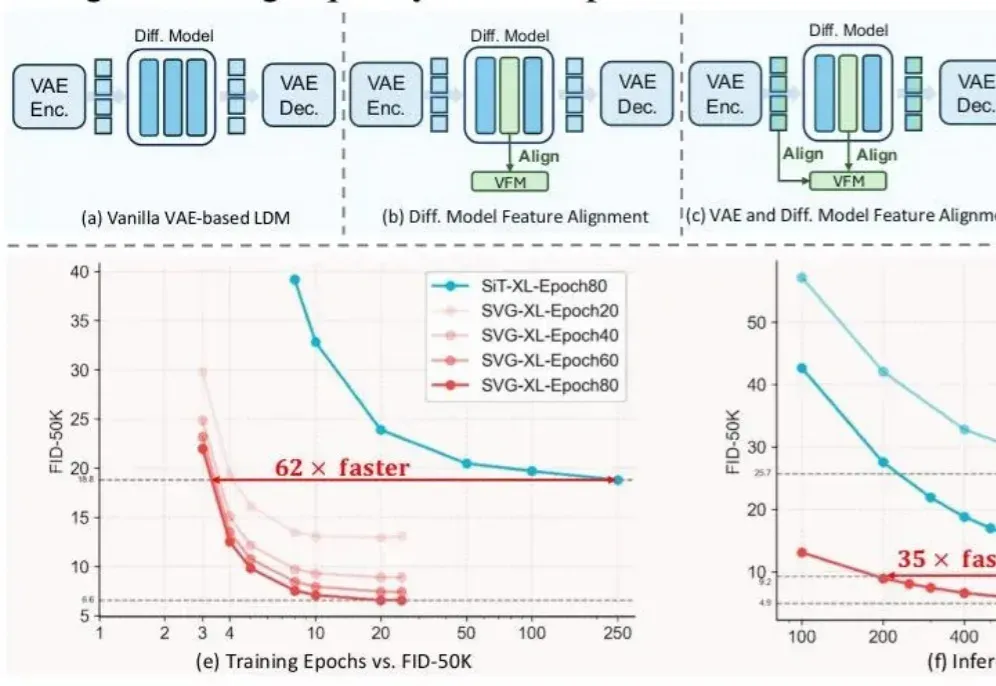
前脚谢赛宁刚宣告VAE在图像生成领域退役,后脚清华与快手可灵团队也带着无VAE潜在扩散模型SVG来了。
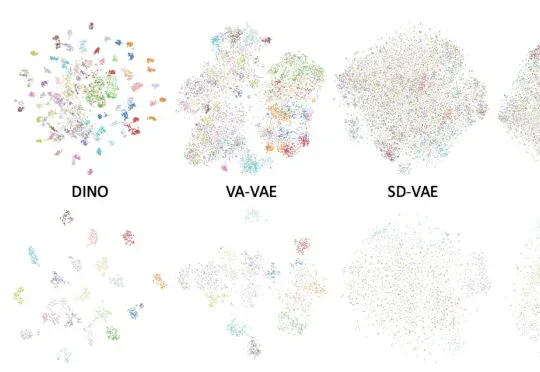
长期以来,扩散模型的训练通常依赖由变分自编码器(VAE)构建的低维潜空间表示。然而,VAE 的潜空间表征能力有限,难以有效支撑感知理解等核心视觉任务,同时「VAE + Diffusion」的范式在训练