最新AI军事模拟:Claude、Gemini、GPT对决,95%对局发射核弹 (opens in a new tab)
最新 AI 模拟军事博弈揭示致命真相:面对地缘危机,最先进的 AI 在 95% 的对局中按下了核按钮。机器不懂恐惧,拒绝投降,安全协议在压力下全面失效。而五角大楼正将其引入真实指挥室,人类的和平岁月岌岌可危。
Total 483 articles
最新 AI 模拟军事博弈揭示致命真相:面对地缘危机,最先进的 AI 在 95% 的对局中按下了核按钮。机器不懂恐惧,拒绝投降,安全协议在压力下全面失效。而五角大楼正将其引入真实指挥室,人类的和平岁月岌岌可危。
基于Gemini 3 Deep Think的谷歌数学智能体Aletheia在更难的挑战赛FirstProof中拿下的最佳成绩。在公布的完整成绩单中,10道题Aletheia全程0人工参与解出6道,其中5题专家全票通过,还有一题拿到了5/7的通过率。
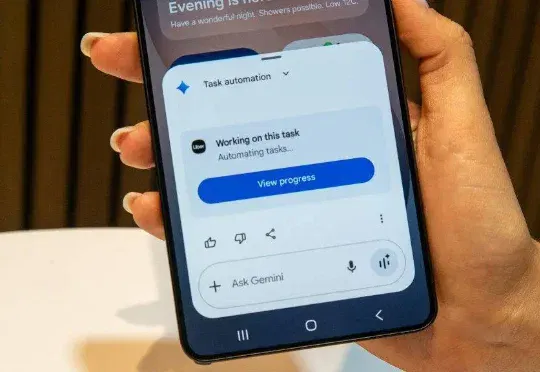
原本以为,三星 Galaxy S26 系列早已被曝光,发布会也就走个流程。没想到三星和 Google 还藏了一手。 两家公司共同展示了 S26 搭载的全新 Gemini 智能体能力:口头吩咐一句话,G
SSI-Bench是首个在约束流形中评估模型空间推理能力的基准,强调真实结构与约束条件,通过排序任务考察模型是否能准确理解三维结构的几何与拓扑关系,揭示当前大模型在空间智能上严重依赖2D信息,实际表现远低于人类。研究指出,模型需提升三维构型识别和约束推理能力,才能真正理解空间问题。
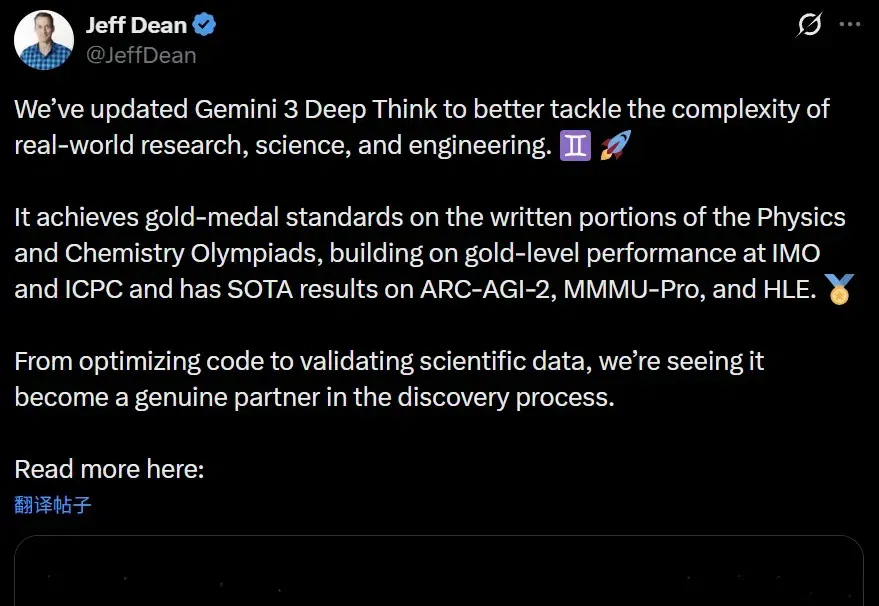
从此以后,AI 不再是工具,要尊称为「硅基博学家」了。
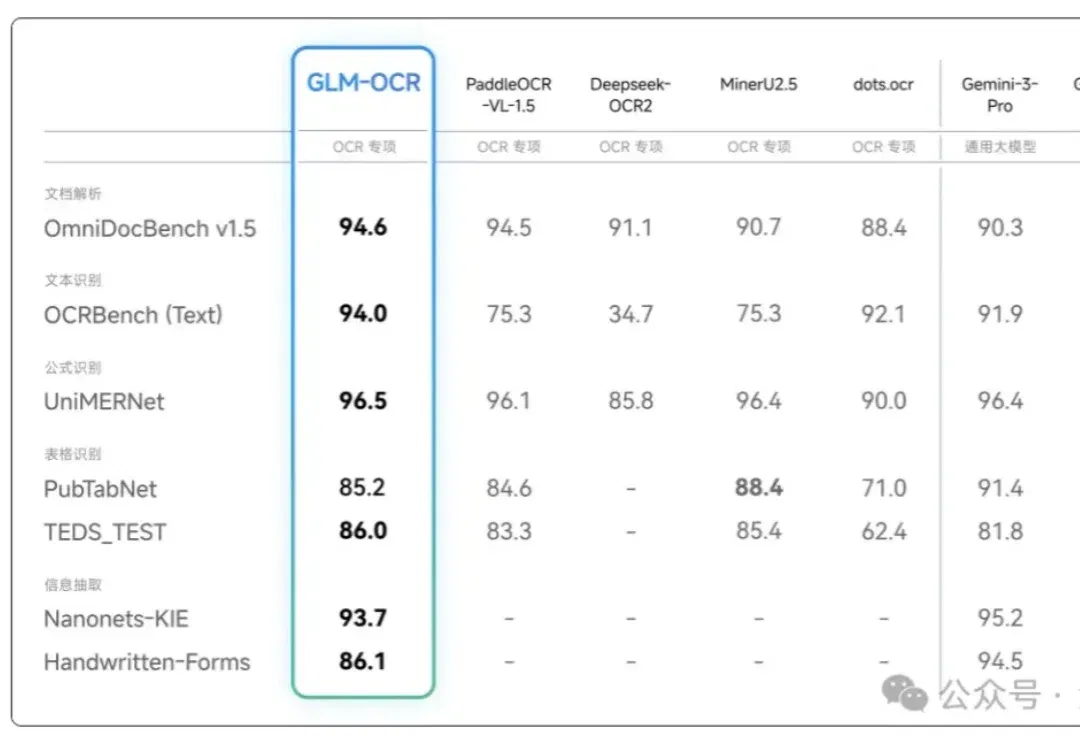
OCR模型究竟能干什么?干得怎么样? 2025年末2026年年初,科技圈最卷的技术无疑就是——O!C!R! 这不,就在前两天,智谱也下场整活儿了,发布了自家的「GLM-OCR」开源模型~ 别看参数就0.9B,在OmniDocBench V1.5榜单上可是一通乱杀。 拳打Gemini-3-Pro!脚踢GPT5.2!(开玩笑 在手写体、代码文档、印章识别、跨单元格等场景的性能表现直通SOTA: 这两天处于工作的原因,我也深度上手使用了GLM-OCR一番,这波用下来的感受是: 在日常基础文档解析场景里用起来确实爽爽爽! but,涉及到字迹不清晰或复杂排版的信息时,翻车现象还是有的…… 顺带,帮友友们
今天,国产大模型再次迎来硬核进阶! 科大讯飞小年放出推理王炸——星火大模型X2。 什么概念呢?从星火X1.5到星火X2,仅仅间隔3个月,推理性能直接飙升50%~ 不仅快,而且猛。更重要的是,完全基于国产算力。 一方面,模型通用能力突出,Benchmark评测稳居行业一流水平,即使是和GPT-5.2、Gemini-3-Pro这些国际顶尖模型同台竞技也毫不逊色。 尤其是在数学计算、逻辑推理等核心能力上表现亮眼;同时130多种语言综合能力依旧稳稳在线,继续保持“国家队”水准。 另一方面,星火X2将升级的重点放在了场景落地上。 依靠深度优化的算法、高质量垂域数据和行业专家的参与,三位一体推动行业大模型
很多人都没注意到,谷歌悄悄放了一个大招,既不是 Gemini 也不是 nano banana pro,而是一份报告。这份报告调研了全球 3446 名企业高管(这些企业年营收都不低于 1000 万美元,不是小卡拉米)。
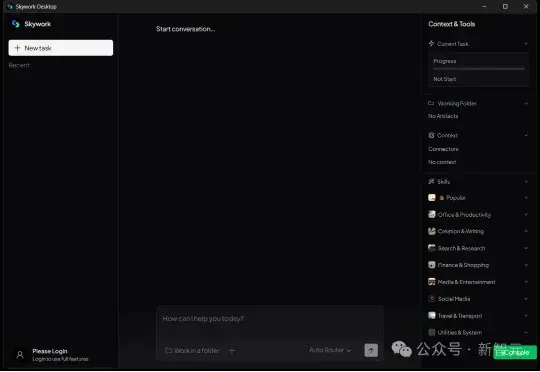
Windows终于迎来自己的「神级辅助」!左手Claude右手Gemini,让打工人效率狂飙的「物理外挂」来了。国产重磅玩家昆仑天工正式入局,甩出了下一代生产力王炸——天工Skywork桌面版。
在 AI 上日渐落后的苹果,最近几个月加紧了前进步伐。抛弃 OpenAI,携手 Google Gemini 后,苹果近日又有新动作。当地时间 1 月 29 日,苹果公司完成了一项近 20 亿美元的收购,目标是以色列 AI 初创公司 Q.ai。