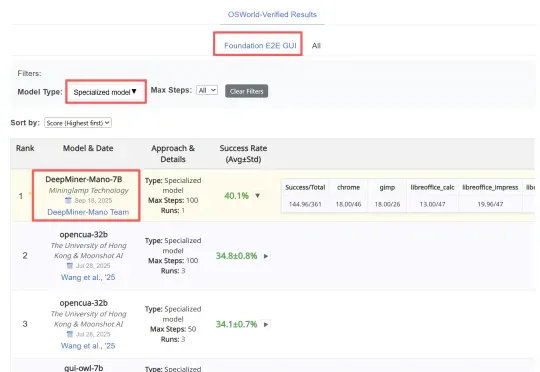
全球双榜SOTA!明略科技专有大模型 Mano开启GUI智能操作新时代 (opens in a new tab)
近日,明略科技推出的基于多模态基础模型的网页 GUI 智能体 Mano,凭借其强大的性能,在行业内公认的两大挑战基准 ——Mind2Web 和 OSWorld 上同时刷新纪录,取得当前最佳成绩(SOTA)。
Total 362 articles
近日,明略科技推出的基于多模态基础模型的网页 GUI 智能体 Mano,凭借其强大的性能,在行业内公认的两大挑战基准 ——Mind2Web 和 OSWorld 上同时刷新纪录,取得当前最佳成绩(SOTA)。
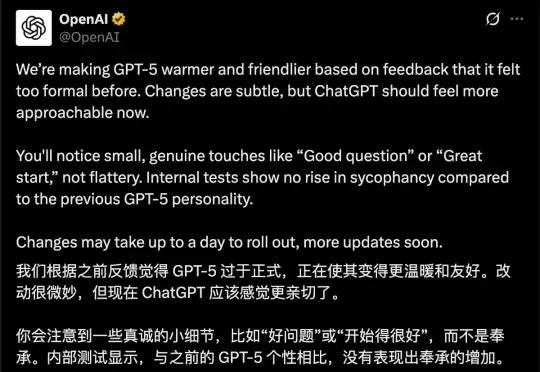
GPT-5上线引发全网吐槽。8月14日,ChatGPT负责人Nick Turley深度复盘了GPT-5发布「风波」,并详细总结了此次产品发布中的失误:比如过快下线GPT-4o、低估用户会对模型的情感依恋、没有让用户建立起「可预期性」等。Nick也分享了OpenAI的产品设计哲学,要坚持「真正对用户有帮助」的原则。
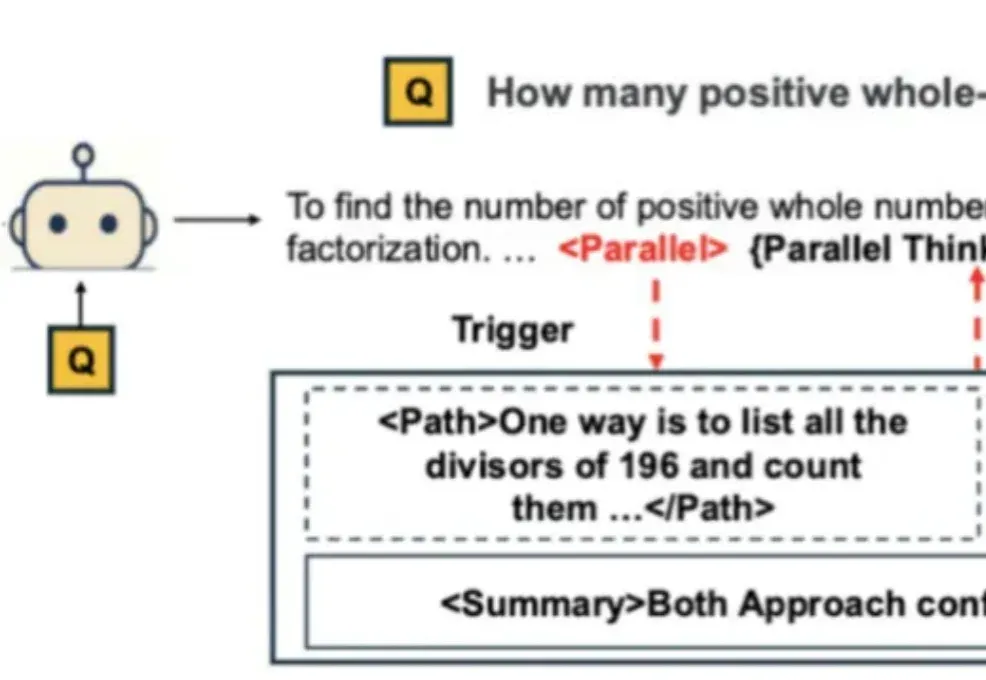
自从 Google Gemini 将数学奥赛的成功部分归功于「并行思维」后,如何让大模型掌握这种并行探索多种推理路径的能力,成为了学界关注的焦点。
DeepSeek荣登Nature封面,实至名归!今年1月,梁文锋带队R1新作,开创了AI推理新范式——纯粹RL就能激发LLM无限推理能力。Nature还特发一篇评论文章,对其大加赞赏。
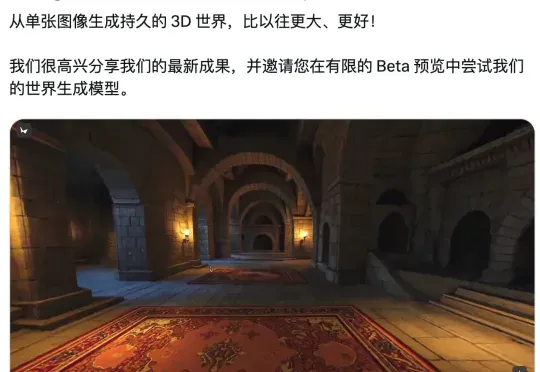
就在今天,斯坦福大学教授李飞飞的创业公司 World Labs 发布了新成果 —— 限量开放的测试预览版空间智能模型 Marble。「只需一张图片,就能生成持久存在的 3D 世界,比以往更宏大、更震撼!」
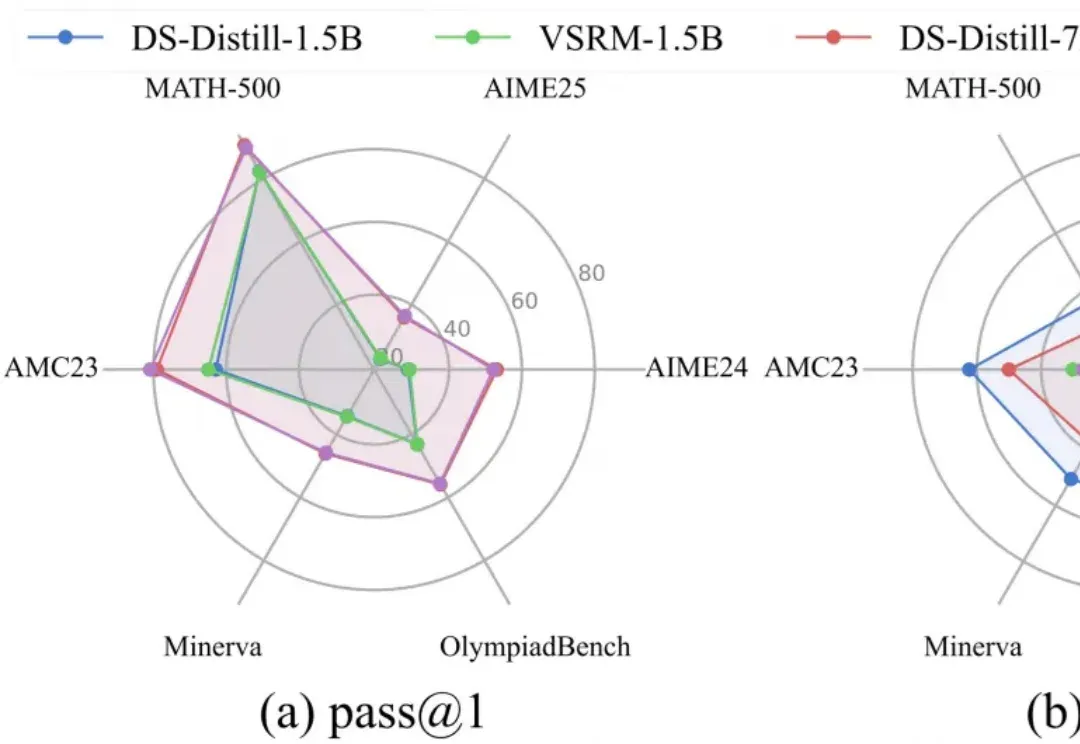
LRM通过简单却有效的RLVR范式,培养了强大的CoT推理能力,但伴随而来的冗长的输出内容,不仅显著增加推理开销,还会影响服务的吞吐量,这种消磨用户耐心的现象被称为“过度思考”问题。
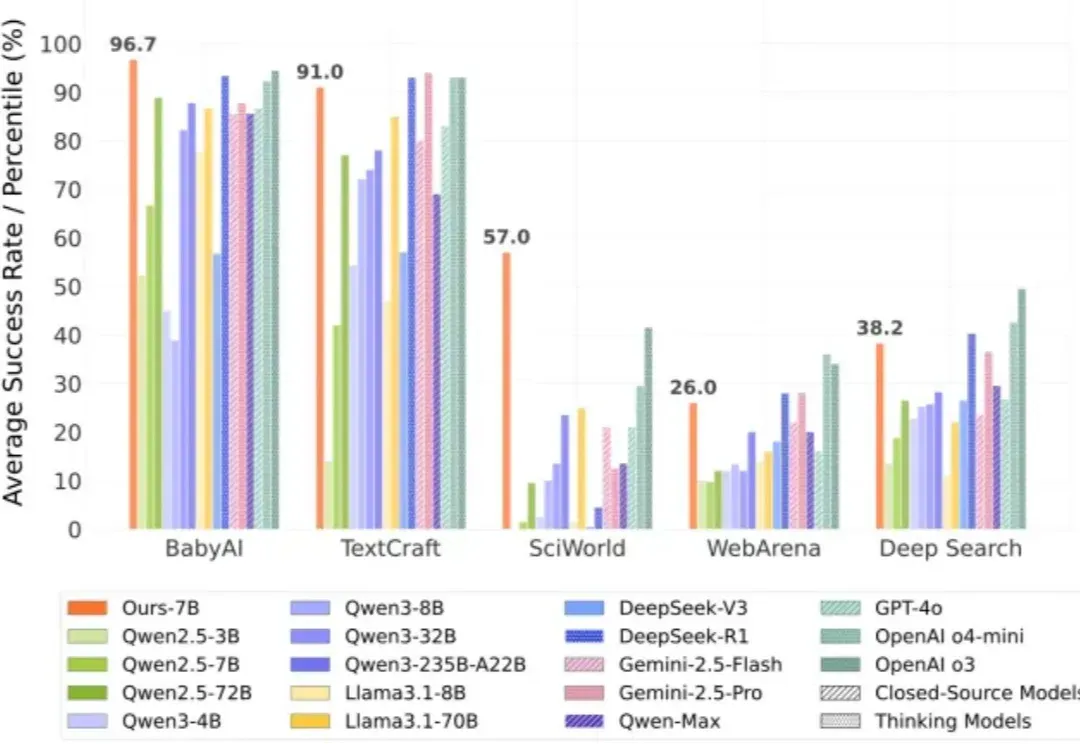
强化学习之父、2024 年 ACM 图灵奖得主 Richard Sutton 曾指出,人工智能正在迈入「经验时代」—— 在这个时代,真正的智能不再仅仅依赖大量标注数据的监督学习,而是来源于在真实环境中主动探索、不断积累经验的能力。
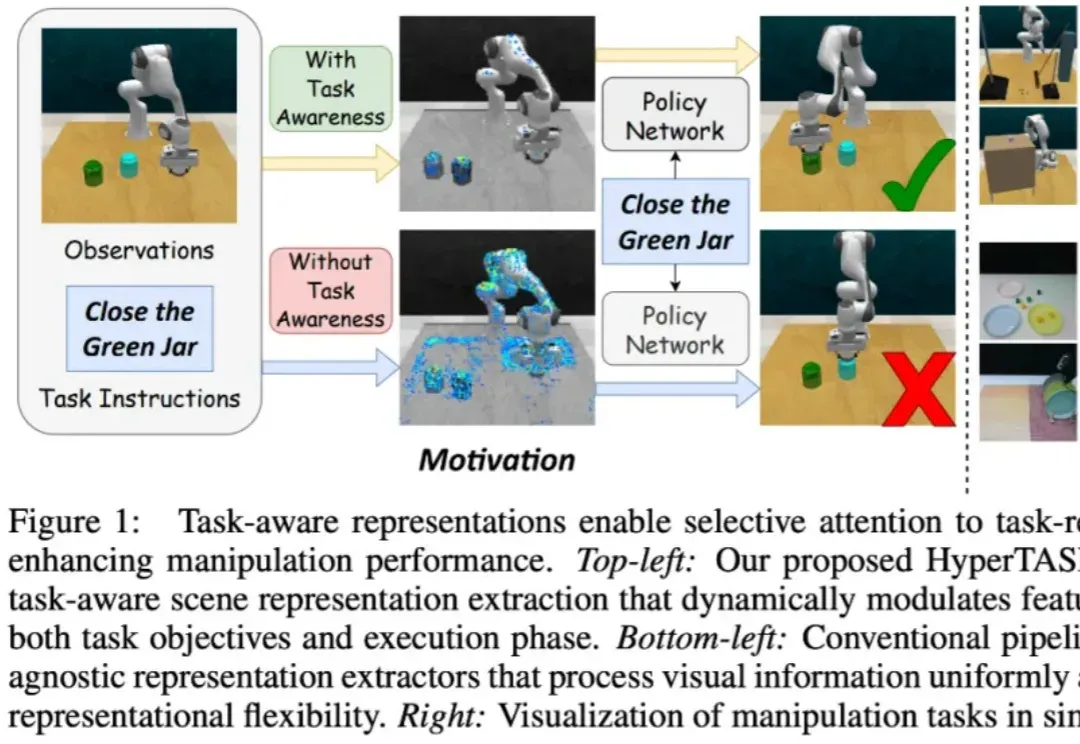
在具身智能中,策略学习通常需要依赖场景表征(scene representation)。然而,大多数现有多任务操作方法中的表征提取过程都是任务无关的(task-agnostic):
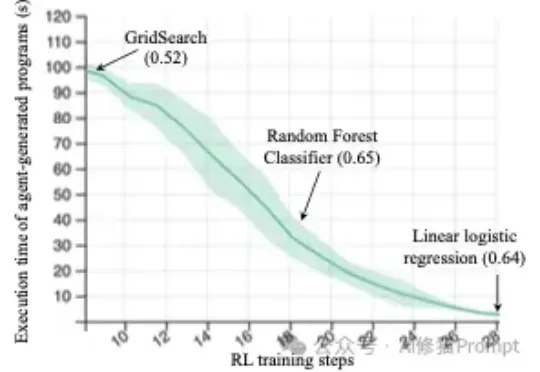
来自斯坦福的研究者们最近发布的一篇论文(https://arxiv.org/abs/2509.01684)直指RL强化学习在机器学习工程(Machine Learning Engineering)领域的两个关键问题,并克服了它们,最终仅通过Qwen2.5-3B便在MLE任务上超越了仅依赖提示(prompting)的、规模更大的静态语言模型Claude3.5。
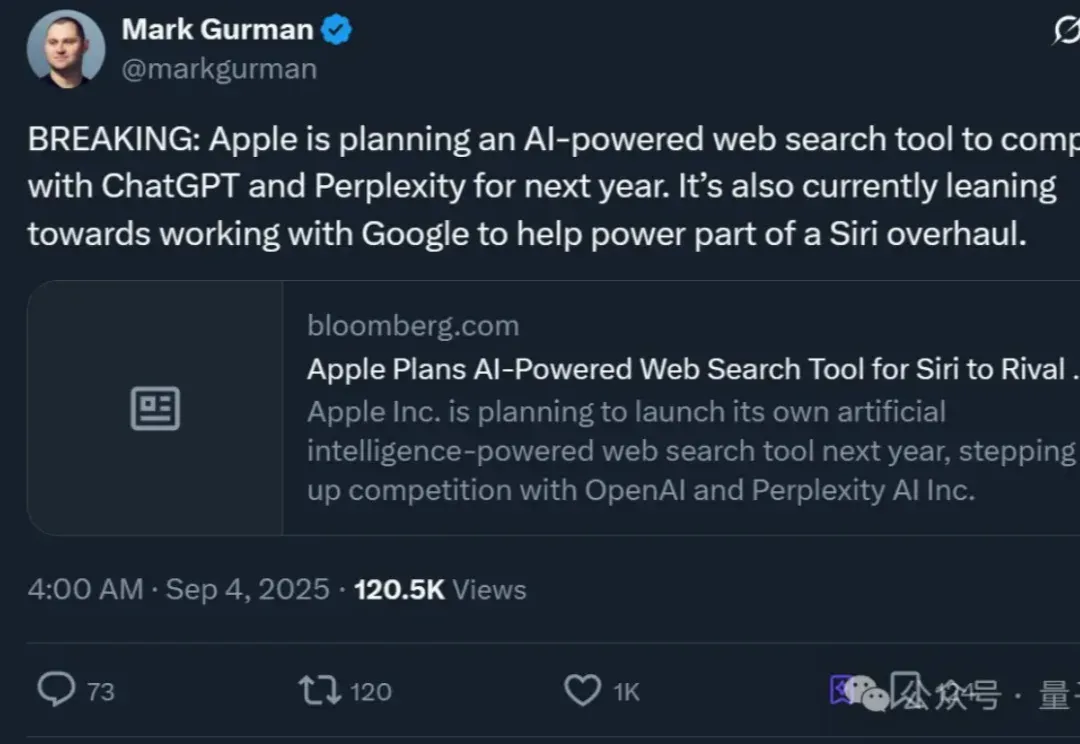
苹果自研AI搜索引擎,刚刚曝光!据长期追踪苹果资讯的彭博社记者古尔曼爆料,这家公司预计又有两个新动作: 一是在明年春季推出一款代号为“世界知识问答”(World Knowledge Answers)的AI搜索引擎,与ChatGPT和Perplexity展开直接竞争;二是当下倾向于与谷歌合作,利用谷歌模型为Siri的部分功能提供技术支持。