突破单链思考上限,清华团队提出原生「并行思考」scale范式 (opens in a new tab)
近年来,大语言模型(LLMs)在复杂推理任务上的能力突飞猛进,这在很大程度上得益于深度思考的策略,即通过增加测试时(test-time)的计算量,让模型生成更长的思维链(Chain-of-Thought)。
Total 375 articles
近年来,大语言模型(LLMs)在复杂推理任务上的能力突飞猛进,这在很大程度上得益于深度思考的策略,即通过增加测试时(test-time)的计算量,让模型生成更长的思维链(Chain-of-Thought)。
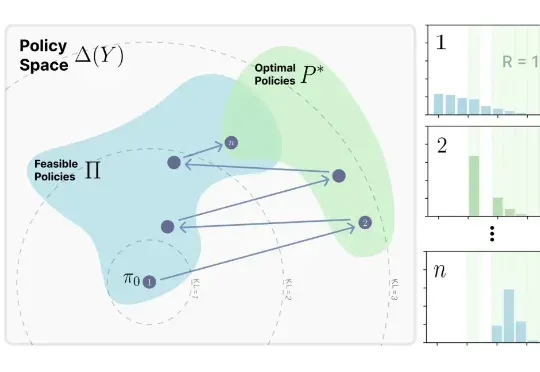
来自MIT Improbable AI Lab的研究者们最近发表了一篇题为《RL's Razor: Why Online Reinforcement Learning Forgets Less》的论文,系统性地回答了这个问题,他们不仅通过大量实验证实了这一现象,更进一步提出了一个简洁而深刻的解释,并将其命名为 “RL's Razor”(RL的剃刀)。
DeepSeek荣登Nature封面,实至名归!今年1月,梁文锋带队R1新作,开创了AI推理新范式——纯粹RL就能激发LLM无限推理能力。Nature还特发一篇评论文章,对其大加赞赏。
等了一百多天,悬念终于揭晓。 9 月 13 日上午,蚂蚁集团开源团队(「开源技术增长」)携《 2025 大模型开源开发生态全景图 》2.0 版,亮相上海外滩大会。
人类的大脑,会在梦里筛选记忆。如今,AI也开始学会在「睡眠」中整理、保存,甚至遗忘。Bilt部署数百万智能体,让科幻小说里的设问——「仿生人会梦见电子羊吗?」——逐步成真。那么,当AI也能选择忘记时,它会变得更像人,还是更陌生?
诺奖得主哈萨比斯直击AI痛点:当前LLM远非博士级智能,仅在特定领域闪光,却缺乏全面性和一致性。真正的AGI,还需1-2项关键突破,等待有5-10年。
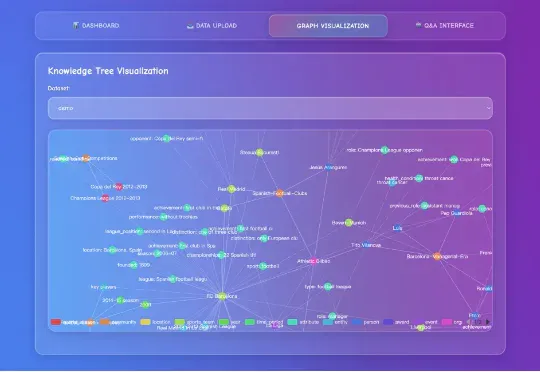
图检索增强生成(GraphRAG)已成为大模型解决复杂领域知识问答的重要解决方案之一。然而,当前学界和开源界的方案都面临着三大关键痛点: 开销巨大:通过 LLM 构建图谱及社区,Token 消耗大,耗
智能体(Agent)时代,工具已不再只是传统 API 或函数接口的简单封装,而是决定智能体能否高效完成任务的关键。 为了让智能体真正释放潜力,我们需要重新思考工具开发的方式。传统软件开发依赖确定性逻辑,而智能体是非确定性的,它们在相同输入下可能产生不同输出,这意味着为智能体设计工具需要新的范式。
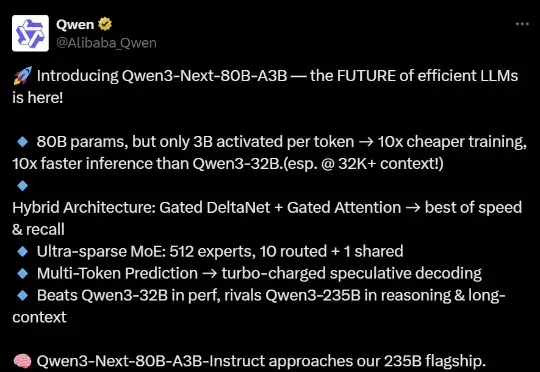
训练、推理性价比创新高。 大语言模型(LLM),正在进入 Next Level。 周五凌晨,阿里通义团队正式发布、开源了下一代基础模型架构 Qwen3-Next。总参数 80B 的模型仅激活 3B ,性能就可媲美千问 3 旗舰版 235B 模型,也超越了 Gemini-2.5-Flash-Thinking,实现了模型计算效率的重大突破。
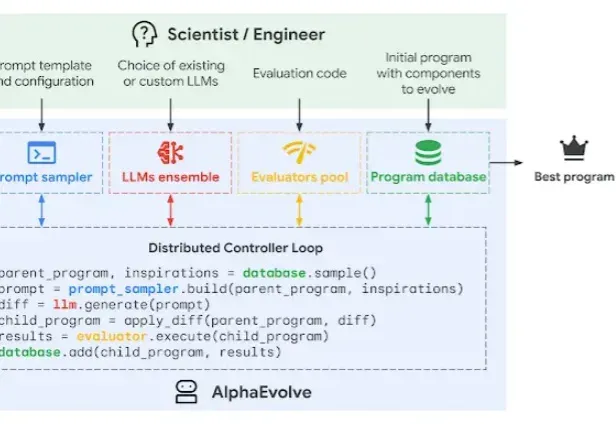
AI 开发复杂软件的时代即将到来? 近年来,以 Google 的 AlphaEvolve 为代表的研究已经证明,AI 智能体可以通过迭代来优化算法,甚至在某些小型、独立的编程任务上超越人类。然而,这些工作大多局限于几百行代码的「算法内核」或单个文件。 但现实世界的软件,比如一个顶级的 SAT 求解器,是一个庞大而复杂的系统工程,包含数百个文件、精密的编译系统和无数相互关联的模块。手动打造一个冠军级求解器不仅需要极高的领域知识,而且投入产出比越来越低。 为此,NVIDIA Research 的研究人员提出了 SATLUTION,首个将 LLM 代码进化能力从「算法内核」扩展到「完整代码库」规模的