PenguinHarness AI FDE:给每个 Agent 定制一套工作台,实现稳定自我进化! (opens in a new tab)
DeepSeek Harness 给每个用户定制了一套工作台,PenguinHarness 给每个 Agent 定制了一套工作台。
Total 530 articles
DeepSeek Harness 给每个用户定制了一套工作台,PenguinHarness 给每个 Agent 定制了一套工作台。
因OpenAI、Anthropic闭源模型价格高昂,AT&T、Tinder等美国大企业正将越来越多AI工作负载迁移至开放权重模型以控制成本,DeepSeek、智谱等中国开放模型成为本轮企业降本红利的最大受益者。
27B正在成为本地AI的新选择。 一个能塞进24GB家用显卡的开源模型,凭什么被开发者称为新模型的斩杀线? 答案藏在一张榜单里:在Artificial Analysis最新的Intelligence Index上拿到了52分,和GPT-5.6 Luna、DeepSeek-V4-Flash打成平手。换句话说,往后再发小模型,够不到这条线,就很难再让人提起兴趣。 它就是刚刚开源的Qwen3.8-27B。 而比这个分数更让个人开发者上心的一点是:这一次,它是真的能被下载回家、跑在自己电脑上的。 Qwen3.8-27B在正式开放权重之前,海外开源社区已经等了好一阵。 量化版本什么时候出来,24GB显存
济州岛,KDD 2026,太热闹了。 Jeff Dean等一众大佬接连现身,会场里随便转个弯,都可能碰到深耕数据挖掘领域的知名研究者。 就在这一片火热交流里,一道困扰行业许久的推荐系统统一建模的问题,也终于等来了它的答案。 三个月前,腾讯营销以KDD Cup 2026官方赛道的身份,向全球算法玩家扔出了一道题: 推荐系统,能不能迎来属于自己的Scaling Law时刻? 赛题聚焦「大规模推荐系统的统一序列建模与特征交互」。 要求参赛者用一套统一的Recommendation Block,把过去各行其是的序列建模与特征交互合二为一,去验证推荐系统能不能复刻大模型,拥有可不断扩容的统一架构。 为了
就在刚刚,智谱发布了其最新一代旗舰模型GLM-5.3,并宣布模型将在两周内开源。这是一个拥有7430亿个参数的模型,和此前的GLM模型一样主打编程。在多项主流基准测试中,GLM-5.3位居所有已开源或即将开源模型中的第一;其在编程与智能体任务上的能力,已逼近Claude Fable 5、GPT-5.6 Sol等海外顶尖模型。
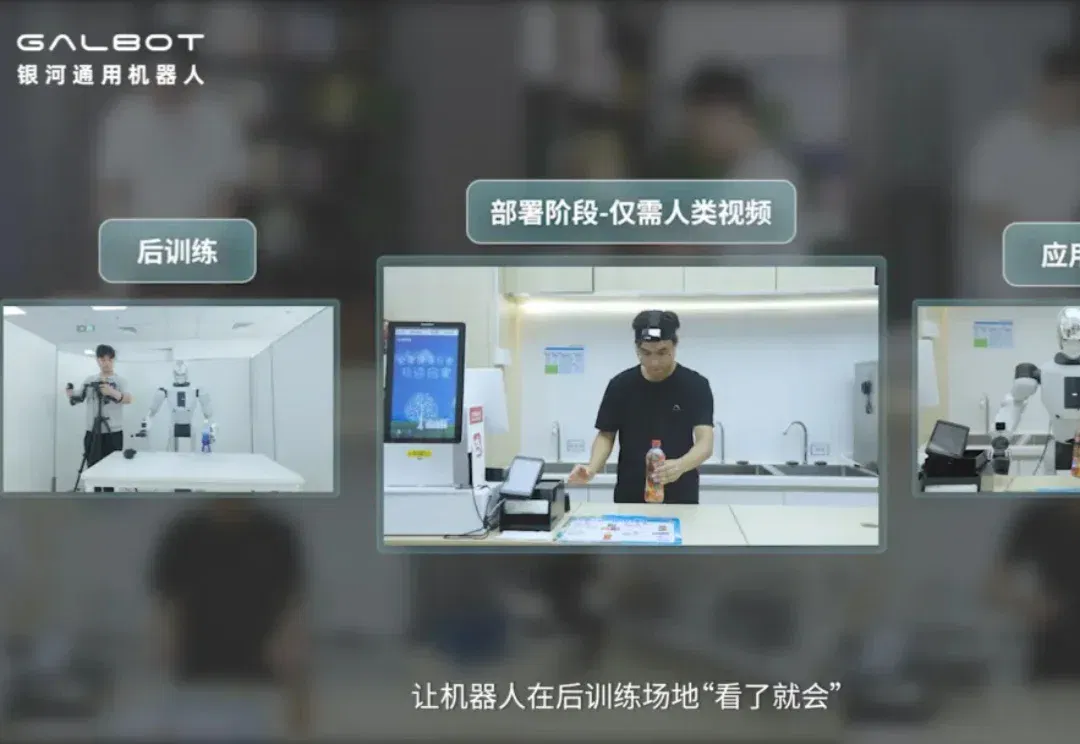
终于,现学现用的风也是吹到了具身智能。 要说这两年,大模型最重要的变化之一,就是越来越不依赖预训练一锤定音,部分能力开始留到推理时刻再兑现。 OpenAI o1如此,DeepSeek-R1也是如此。模型推理能力提升,靠的是在应用过程中的持续自我提升。 但机器人不一样,它面对的是比文本更复杂的物理世界,任意一次误判都有可能损坏抓取对象。想让机器人像大模型一样在部署时进化,行业内一直没有人做到。 直到今天,这条路线第一次被银河通用走通了。 刚刚,银河通用正式发布全球首个面向具身智能大模型的测试时后训练框架WAM‑TTT(World-Action Model Test-Time Training
什么是DeepSeek开启融资的直接导火索?
今天来聊聊中转站。 简单来说,模型中转站,就是把 OpenAI、Claude、Gemini、DeepSeek 等不同模型接到同一个入口后面,让开发者用一套接口、一个账号和统一账单调用多个模型,并在不同模型或供应商之间做选择、切换和备用。 当然,对于国内用户来说,用中转站更大的原因是想用海外模型,以及更便宜。 这个大家懂得都懂,国内的中转站我们就不多说,今天主要介绍 OpenRouter。 到 2026 年,OpenRouter已经融到 1.13 亿美元 B 轮,估值已经接近 13 亿美元。 也就是说,它已经是一家独角兽公司。 我们就来分析下,一个“不造模型”的模型中转站,为什么能值这么多钱?
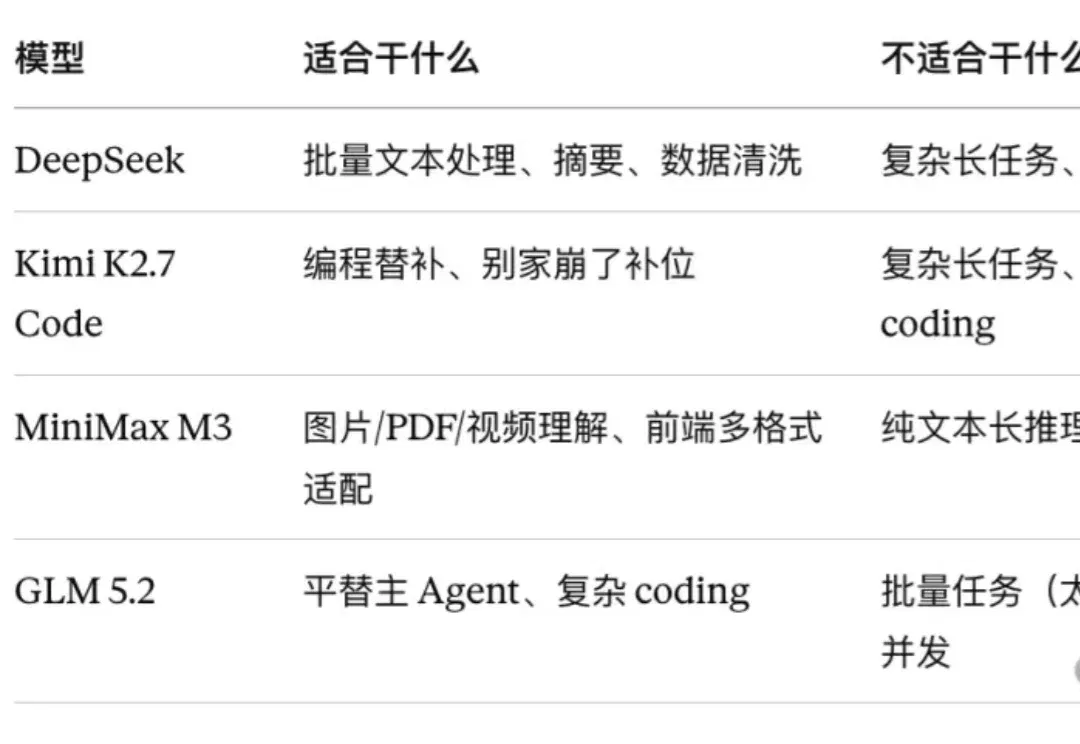
最近,Kimi 2.7 Code 和 GLM 5.2 接连发布,一周双发,国产模型又崛起了。
这是葬AI起号以来工作量最大的一篇文章。为了严肃评测国产模型的能力,我自研了一个Benchmark,完整测试了智谱、Qwen、Kimi、Minimax、Deepseek这些最新国产模型,还引入了境外势力Claude作对照组。