ICLR 2026|新版「图灵测试」:当VLA走进生物实验室 (opens in a new tab)
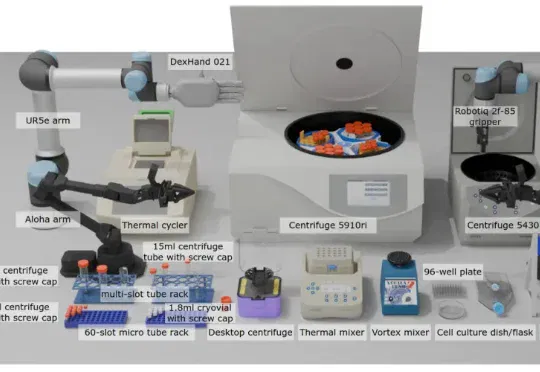
现有 VLA 模型的研究和基准测试多局限于家庭场景(如整理餐桌、折叠衣物),缺乏对专业科学场景(尤其是生物实验室)的适配。生物实验室具有实验流程结构化、操作精度要求高、多模态交互复杂(透明容器、数字界面)等特点,是评估 VLA 模型精准操作、视觉推理和指令遵循能力的理想场景之一。
Total 438 articles
现有 VLA 模型的研究和基准测试多局限于家庭场景(如整理餐桌、折叠衣物),缺乏对专业科学场景(尤其是生物实验室)的适配。生物实验室具有实验流程结构化、操作精度要求高、多模态交互复杂(透明容器、数字界面)等特点,是评估 VLA 模型精准操作、视觉推理和指令遵循能力的理想场景之一。
千问 3.5 总参数量仅 3970 亿,激活参数更是只有 170 亿,不到上一代万亿参数模型 Qwen3-Max 的四分之一,性能大幅提升、还顺带实现了原生多模态能力的代际跃迁。
没有让我们等待多久,阿里刚刚正式发布并开源了 Qwen3.5 系列模型,页面显示有两款模型,分别为最新大语言模型的 Qwen3.5-Plus,以及定位为开源系列旗舰的 Qwen3.5-397B-A17B。两者均支持文本处理与多模态任务。
结果今天就等到豆包全家族了。Seedance 2.0都把贾樟柯干Fomo了,现在又上了个最全面的多模态Agent模型,还有人管管字节吗?Seed团队跳动得停不下来了💃烧的全是火山引擎上的Tokens,同时火山引擎上已经有豆包2.0系列的API了。
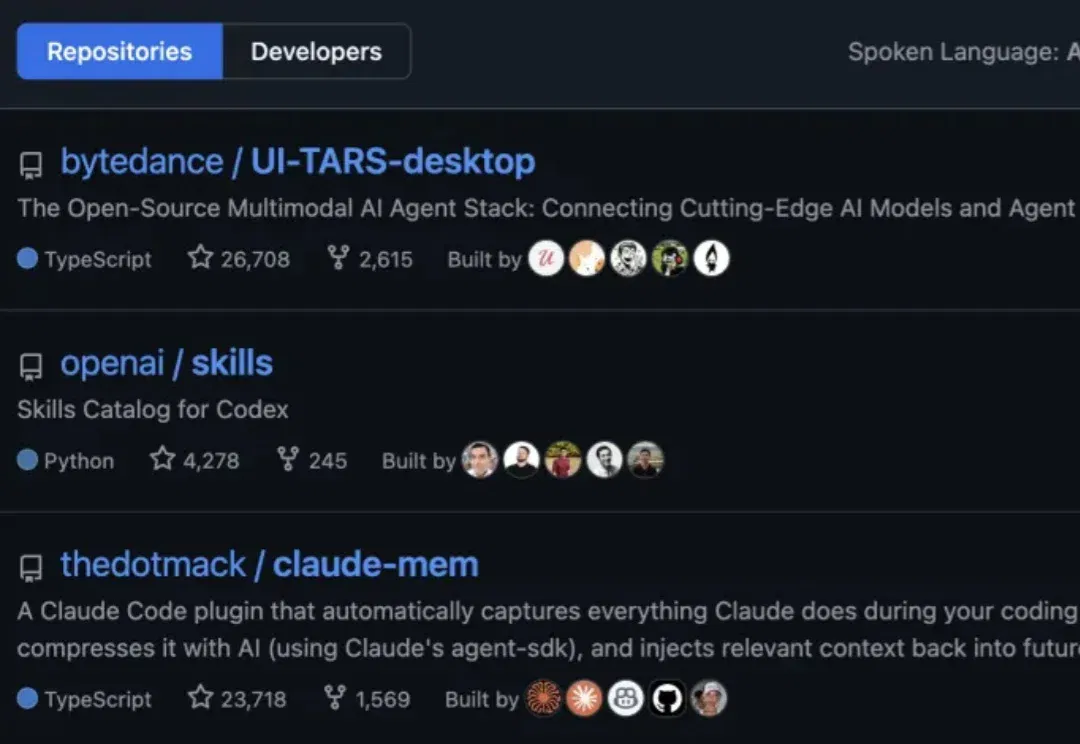
GitHub最新热榜榜首,来自字节。 这波自研硬核技术不是别的—— 正是豆包手机的核心支撑,GUI Agent模型UI-TARS。 力压OpenAI官方Skills,开源登顶榜首,突破26k Star! UI-TARS的核心是个多模态AI智能体,你只要通过自然语言指令—— 也就是说句人话,就能让它自己点鼠标、敲键盘、拖动滚动、翻页浏览,在浏览器和各种软件里帮你完成一整套复杂操作。 主要包含了Agent TARS和UI-TARS-desktop两个项目。 Agent TARS支持一键式开箱即用的CLI,可以在有界面的Web UI环境执行,也能在无界面的服务器环境运行; UI-TARS-deskt
梦瑶 发自 凹非寺 量子位 | 公众号 QbitAI 不是,谁也没跟我说今年的AI春节大战搞得这么猛猛猛啊!?! 年还没到呢,可灵就超绝不经意甩出一个「过大年计划」:推出可灵3.0多模态全家桶。 让每
今天,北京多模态生成技术创企生数科技宣布完成超过6亿元人民币A+轮融资。生数科技还披露,2025年该公司实现用户和收入超10倍增长,用户和业务覆盖全球200多个国家和地区。
「暗涌Waves」独家获悉,一家成立刚不过4个月的AI-Native用户研究平台Trooly.AI已完成近千万美元的种子轮融资,投资方包括蓝驰创投、高瓴创投和王慧文。与市面上无数“超级个体”、“虚拟陪伴”、“碳基硅基共生世界”的宏大叙事不同,Trooly.AI想要用AI实现真实的商业闭环。其核心产品面向有用户调研需求的B端客户,通过多模态Voice Agent技术
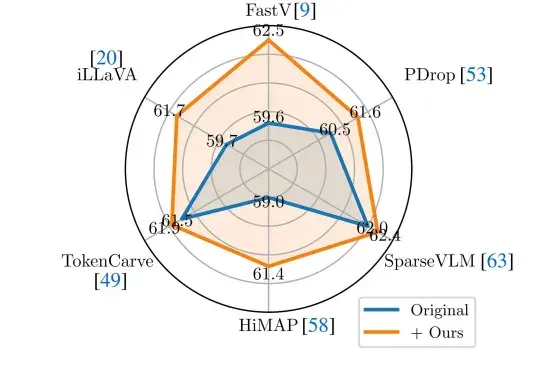
近年来,Vision-Language Models(视觉—语言模型)在多模态理解任务中取得了显著进展,并逐渐成为通用人工智能的重要技术路线。
继OpenAI大神姚顺雨之后,腾讯AI再添猛将!95后清华「天骄」庞天宇,正式入职腾讯,出任混元首席研究科学家,负责多模态强化学习。腾讯的大模型「梦之队」版图,正在极速扩张。