句子级溯源+生成式归因,C²-Cite重塑大模型可信度 (opens in a new tab)
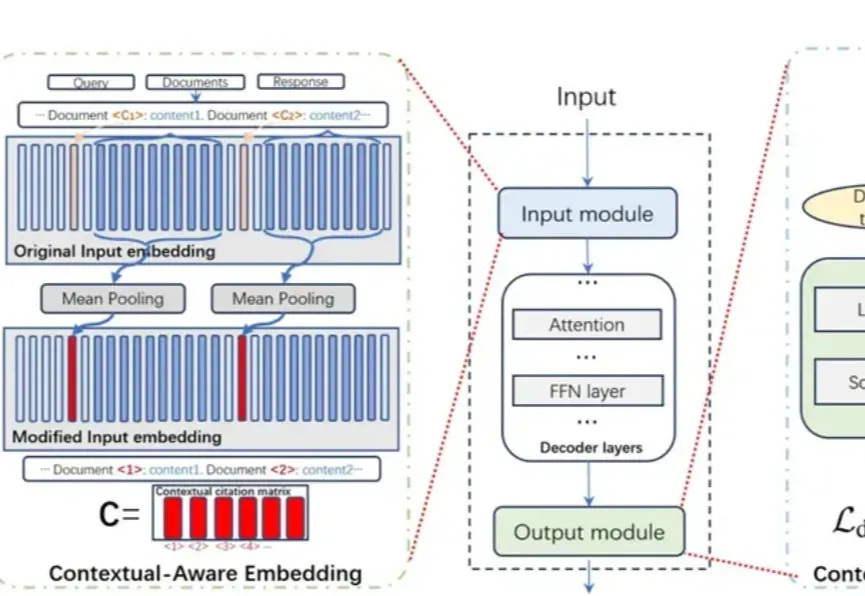
在人工智能快速发展的今天,大语言模型已经深入到我们工作和生活的方方面面。然而,如何让AI生成的内容更加可信、可追溯, 一直是学术界和工业界关注的焦点问题。想象一下,当你向ChatGPT提问时,它不仅给出答案,还能像学术论文一样标注每句话的信息来源——这就是"溯源大语言模型"要解决的核心问题。
Total 404 articles
在人工智能快速发展的今天,大语言模型已经深入到我们工作和生活的方方面面。然而,如何让AI生成的内容更加可信、可追溯, 一直是学术界和工业界关注的焦点问题。想象一下,当你向ChatGPT提问时,它不仅给出答案,还能像学术论文一样标注每句话的信息来源——这就是"溯源大语言模型"要解决的核心问题。
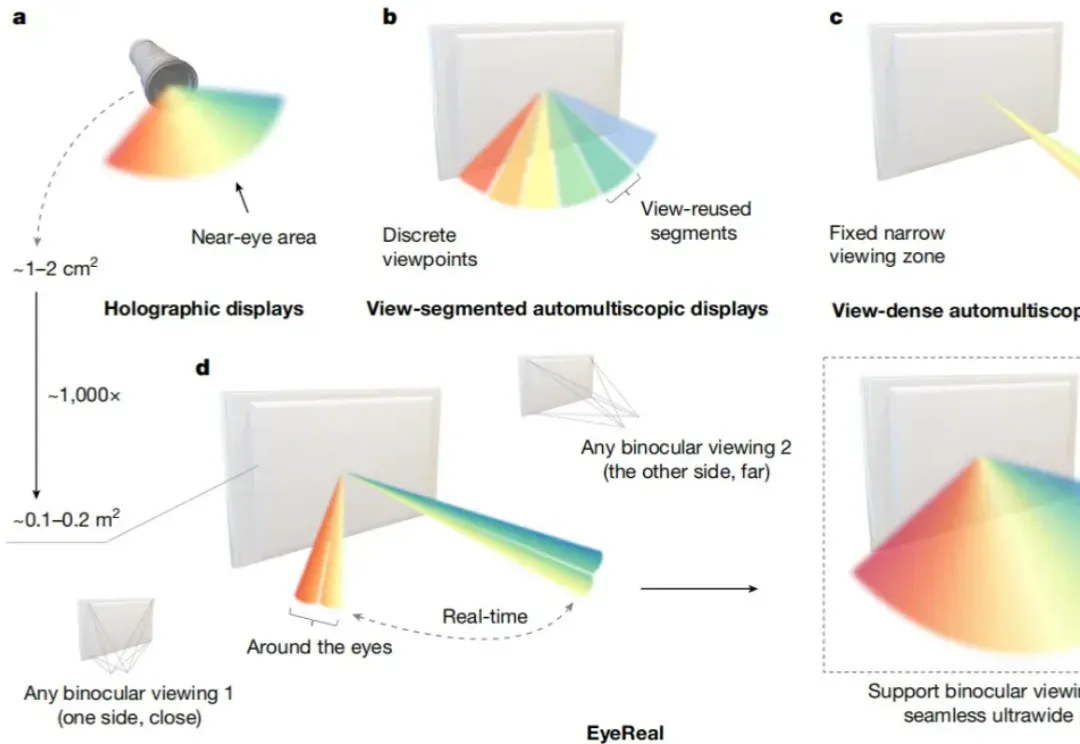
我们能否像《头号玩家》那样伸手就能触摸到虚拟世界?像《阿凡达》那样植物和动物仿佛就在眼前飞舞?这不再只是科幻。11 月 26 日,在一篇最新 Nature 论文中,来自复旦大学团队和上海人工智能实验室的研究人员打造出一款名为 EyeReal 的裸眼 3D 显示器。
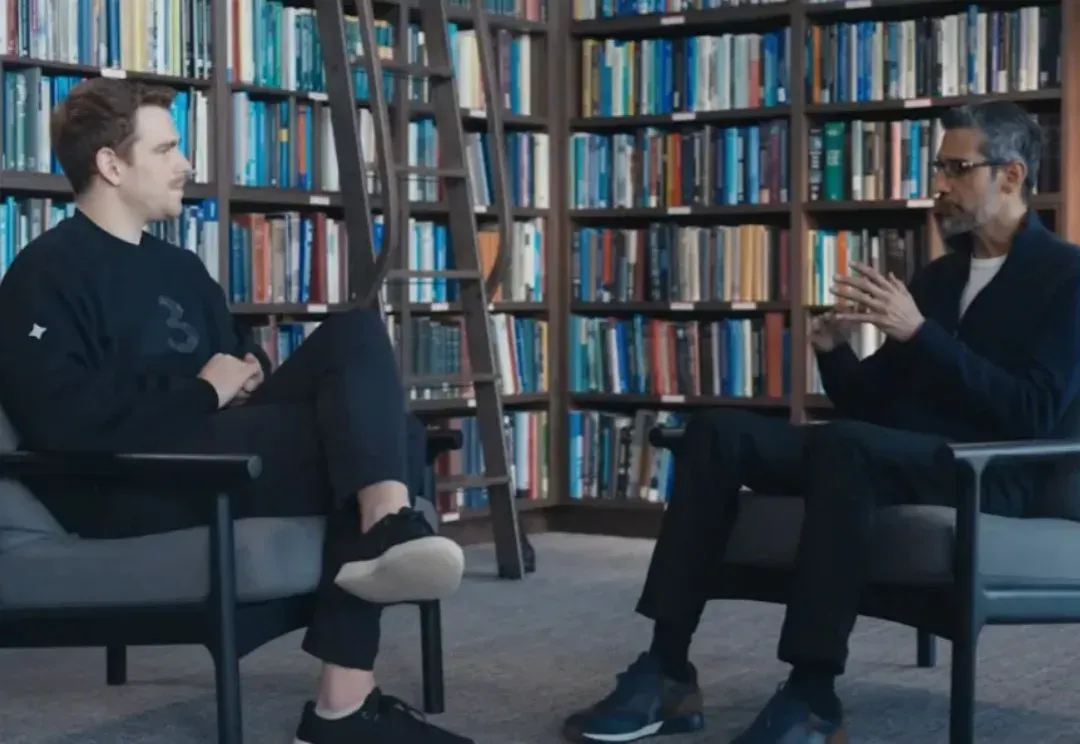
对于谷歌(Google)而言,刚刚过去的一周可以看作其人工智能战略转型的关键节点。随着 Gemini 3 的正式发布,以及名为 Nano Banana Pro 的新模型在社交媒体与开发者社区中迅速走红,这家科技公司正在重新找回自己在 AI 领域的节奏与底气。
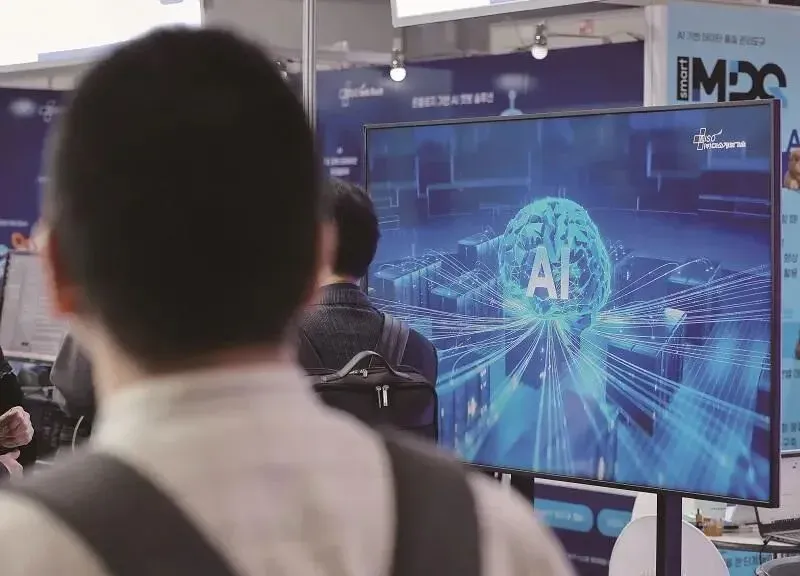
刚刚过去的深秋,韩国高校涌动着一股意想不到的技术暗流——“生成式人工智能(AI)作弊”事件席卷韩国大学圈,三所顶尖高校无一幸免。在延世大学、首尔大学、高丽大学的考试中,学生在课堂及线上考试中动用ChatGPT或群聊进行作弊。
人工智能在过去的十年中,以惊人的速度革新了信息处理和内容生成的方式。然而,无论是大语言模型(LLM)本体,还是基于检索增强生成(RAG)的系统,在实际应用中都暴露出了一个深层的局限性:缺乏跨越时间的、可演化的、个性化的“记忆”。它们擅长瞬时推理,却难以实现持续积累经验、反思历史、乃至真正像人一样成长的目标。
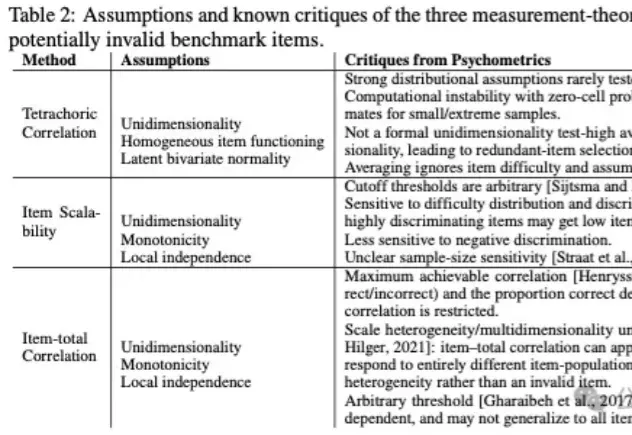
基准测试(Benchmarks)在人工智能的发展进程中扮演着至关重要的角色,构成了评价生成式模型(Generative Models)性能的事实标准。对于从事模型训练与评估的AI研究者而言,GSM8K、MMLU等数据集的数据质量直接决定了评估结论的可靠性。
“后来,人工智能(AI)变得无处不在。如今我们‘勉强’接受NeuroAI这个称呼,只为大众能理解其含义。”
当大模型参数量冲向万亿级,GPT-4o、Llama4 等模型不断刷新性能上限时,AI 行业也正面临前所未有的瓶颈。Transformer 架构效率低、算力消耗惊人、与物理世界脱节等问题日益凸显,通用人工智能(AGI)的实现路径亟待突破。
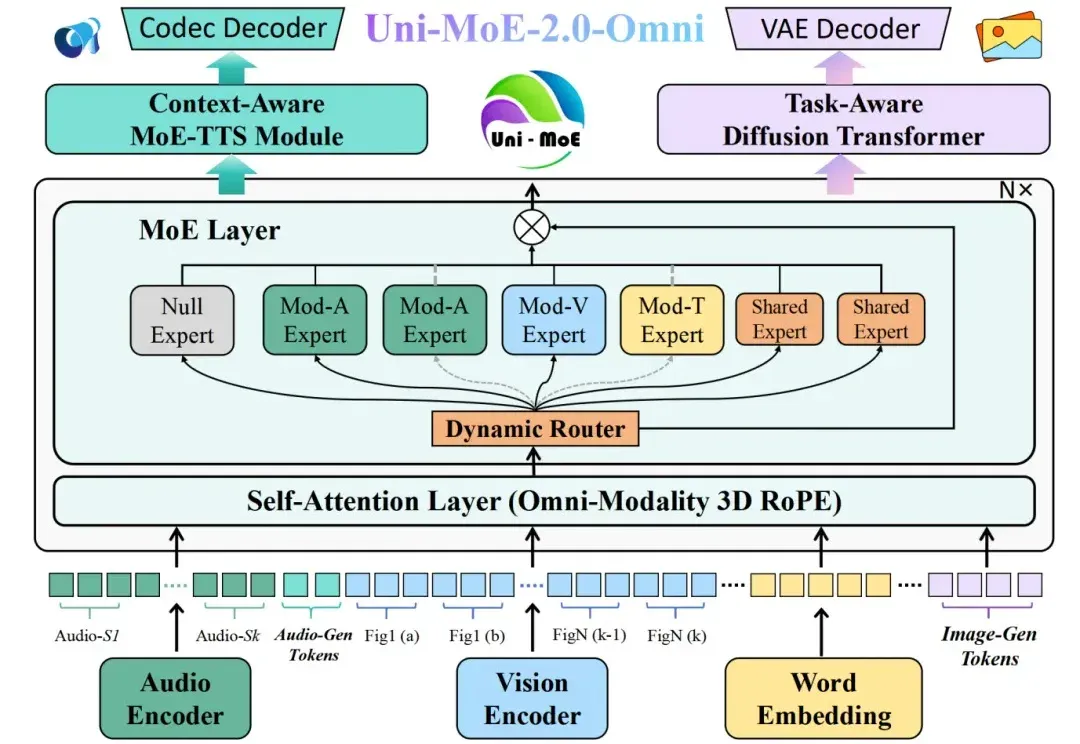
全模态大模型(Omnimodal Large Models, OLMs)能够理解、生成、处理并关联真实世界多种数据类型,从而实现更丰富的理解以及与复杂世界的深度交互。人工智能向全模态大模型的演进,标志着其从「专才」走向「通才」,从「工具」走向「伙伴」的关键点。
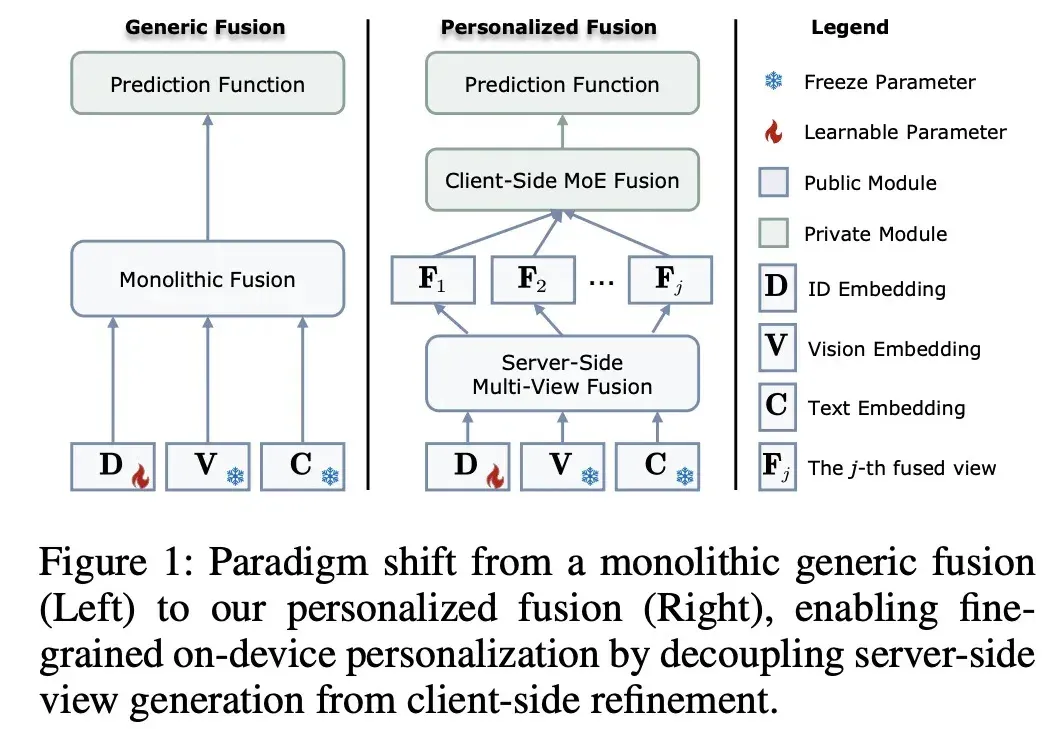
在推荐系统迈向多模态的今天,如何兼顾数据隐私与个性化图文理解?悉尼科技大学龙国栋教授团队联合香港理工大学杨强教授、张成奇教授团队,提出全新框架 FedVLR。该工作解决了联邦环境下多模态融合的异质性难题,已被人工智能顶级会议 AAAI 2026 接收为 Oral Presentation。