内存直降50%,token需求少56%!用视觉方式处理长文本 (opens in a new tab)
在NeurIPS 2025论文中,来自「南京理工大学、中南大学、南京林业大学」的研究团队提出了一个极具突破性的框架——VIST(Vision-centric Token Compression in LLM),为大语言模型的长文本高效推理提供了全新的「视觉解决方案」。值得注意的是,这一思路与近期引起广泛关注的DeepSeek-OCR的核心理念不谋而合。
Total 375 articles
在NeurIPS 2025论文中,来自「南京理工大学、中南大学、南京林业大学」的研究团队提出了一个极具突破性的框架——VIST(Vision-centric Token Compression in LLM),为大语言模型的长文本高效推理提供了全新的「视觉解决方案」。值得注意的是,这一思路与近期引起广泛关注的DeepSeek-OCR的核心理念不谋而合。
Voice Agent 赛道正在爆发,但它迫切需要一个能让对话真正「流动起来」的底层引擎,一个能撑起下一代交互体验的 TTS 模型。竞争的焦点,已经从 LLM 的「大脑」,延伸到了 TTS 的「嗓音」。谁掌握嗓音,谁就掌握着下一代 AI 商业化的钥匙。而 10 月 30 日 MiniMax 发布的 Speech 2.6 模型,似乎正是一个专为解决这些痛点而来的答案。
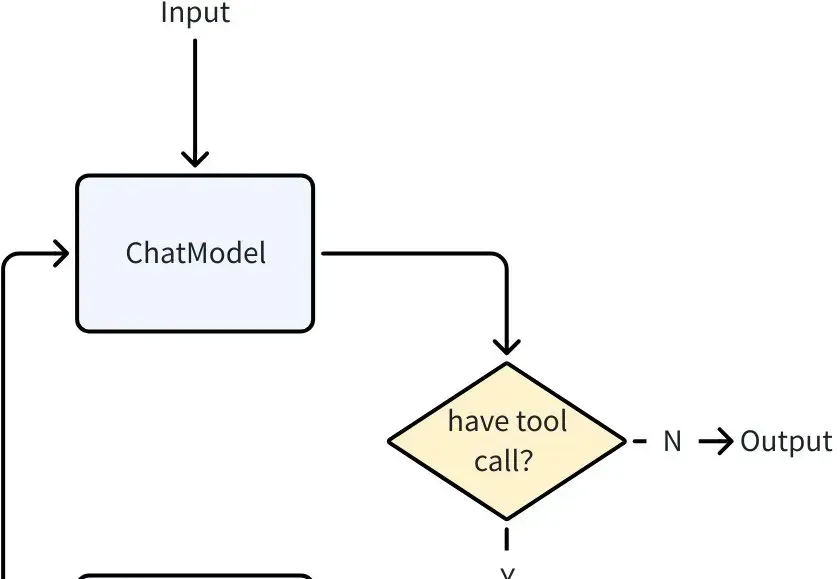
当大语言模型突破了 “理解与生成” 的瓶颈,Agent 迅速成为 AI 落地的主流形态。从智能客服到自动化办公,几乎所有场景都需要 Agent 来承接 LLM 能力、执行具体任务。
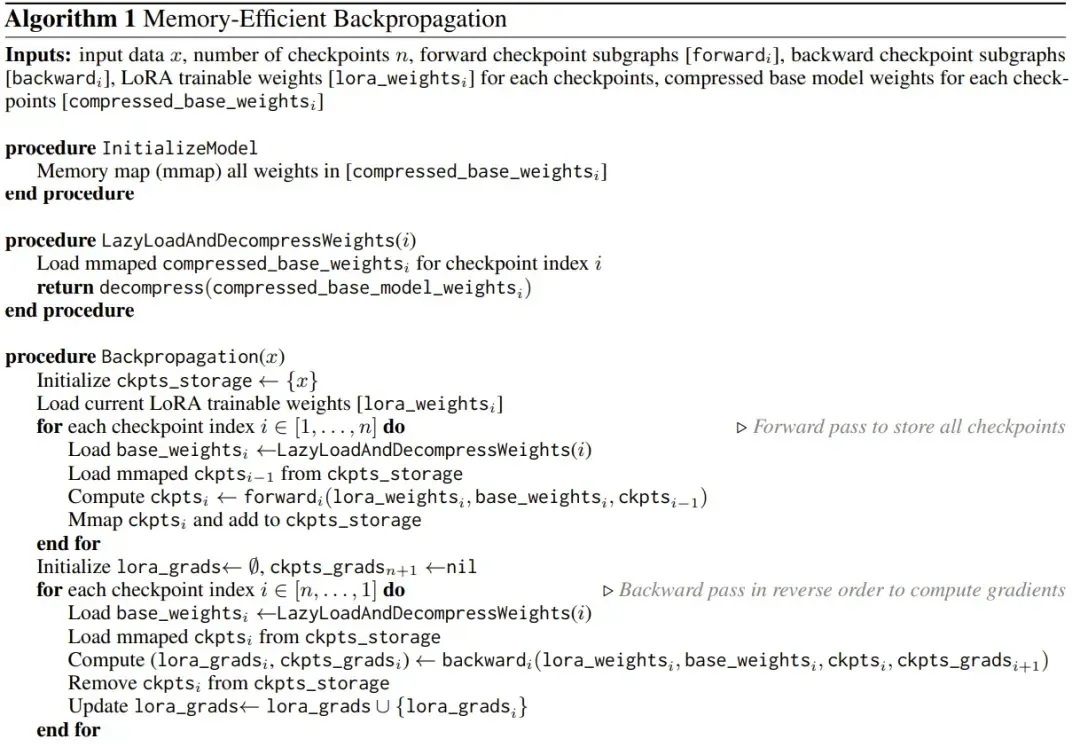
用 iPhone 本地跑大模型已经不是新鲜事了,但能不能在 iPhone 上微调模型呢?
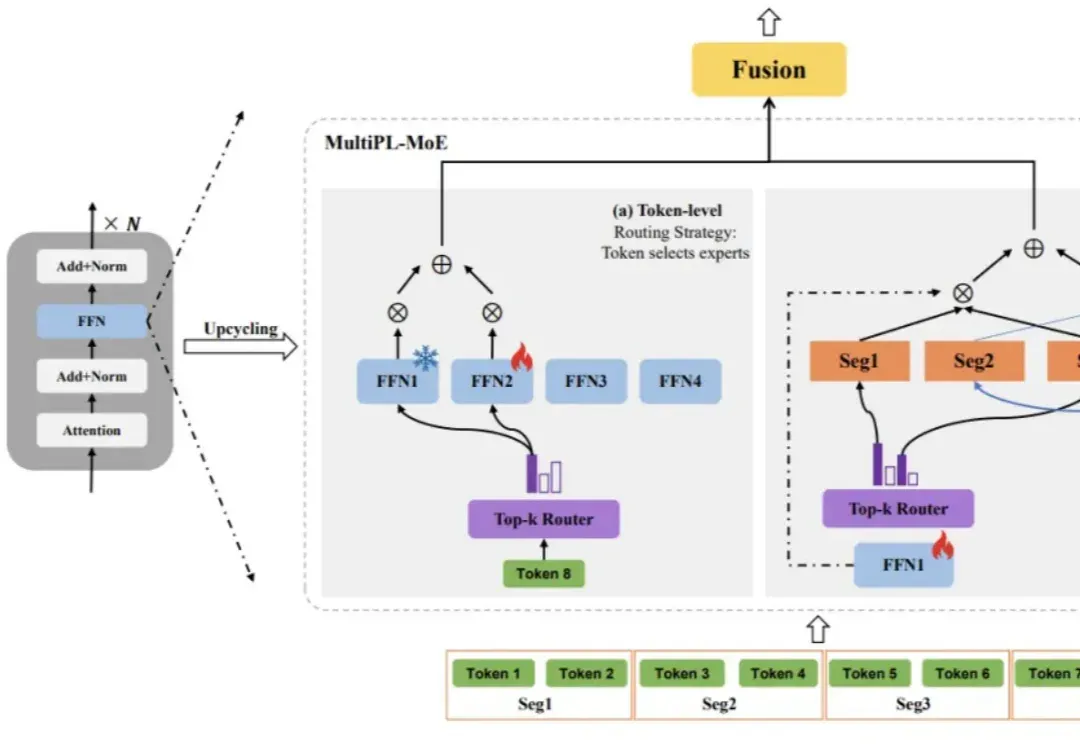
大语言模型(LLM)虽已展现出卓越的代码生成潜力,却依然面临着一道艰巨的挑战:如何在有限的计算资源约束下,同步提升对多种编程语言的理解与生成能力,同时不损害其在主流语言上的性能?
大语言模型(LLMs)推理能力近年来快速提升,但传统方法依赖大量昂贵的人工标注思维链。中国科学院计算所团队提出新框架PARO,通过让模型学习固定推理模式自动生成思维链,只需大模型标注1/10数据就能达到全量人工标注的性能。这种方法特别适合像金融、审计这样规则清晰的领域,为高效推理监督提供了全新思路。
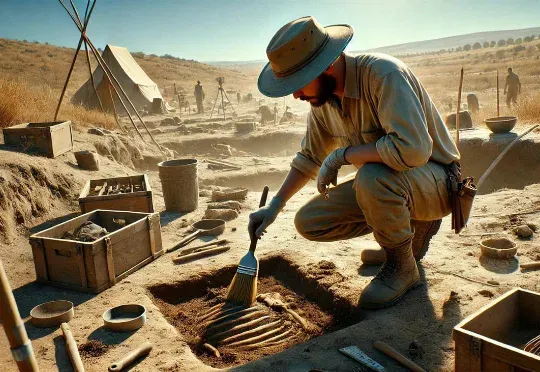
在文化遗产与人工智能的交叉处,有一类问题既美也难:如何让机器「看懂」古希腊的陶器——不仅能识别它的形状或图案,还能推断年代、产地、工坊甚至艺术归属?有研究人员给出了一条实用且富有启发性的答案:把大型多模态模型(MLLM)放在「诊断—补弱—精细化评估」的闭环中训练,并配套一个结构化的评测基准,从而让模型在高度专业化的文化遗产领域表现得更接近专家级能力。
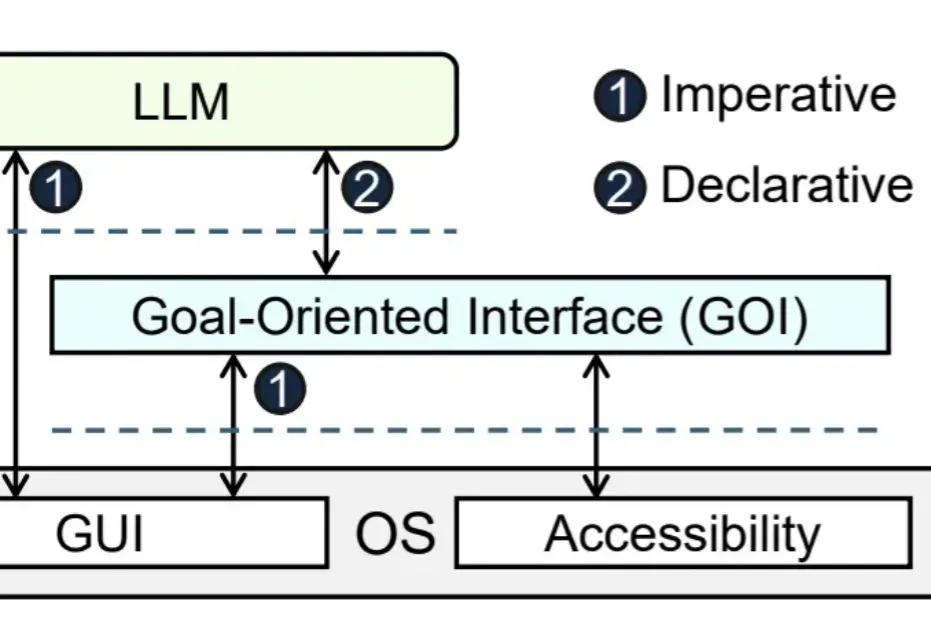
大模型Agent帮你自动操作电脑,理想很丰满,现实却骨感。
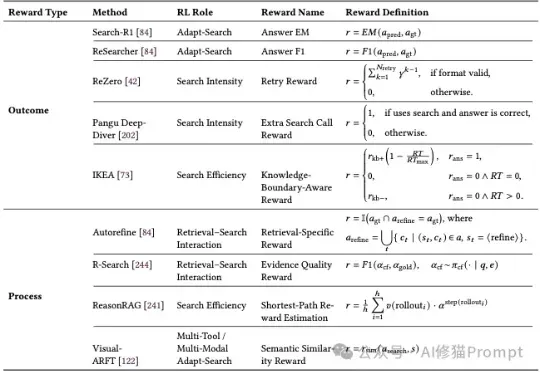
大型语言模型(LLM)本身很强大,但知识是静态的,有时会“胡说八道”。为了解决这个问题,我们可以让它去外部知识库(比如维基百科、搜索引擎)里“检索”信息,这就是所谓的“检索增强生成”(RAG)。
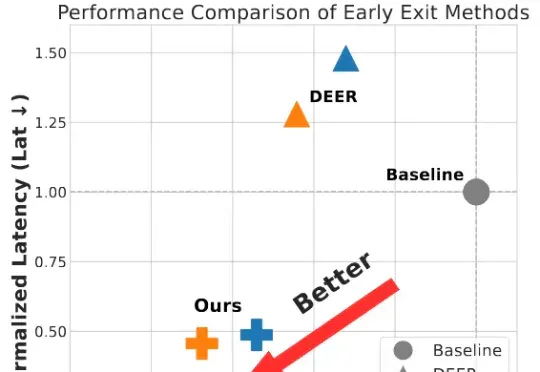
为破解大模型长思维链的效率难题,并且为了更好的端到端加速落地,我们将思考早停与投机采样无缝融合,提出了 SpecExit 方法,利用轻量级草稿模型预测 “退出信号”,在避免额外探测开销的同时将思维链长度缩短 66%,vLLM 上推理端到端加速 2.5 倍。