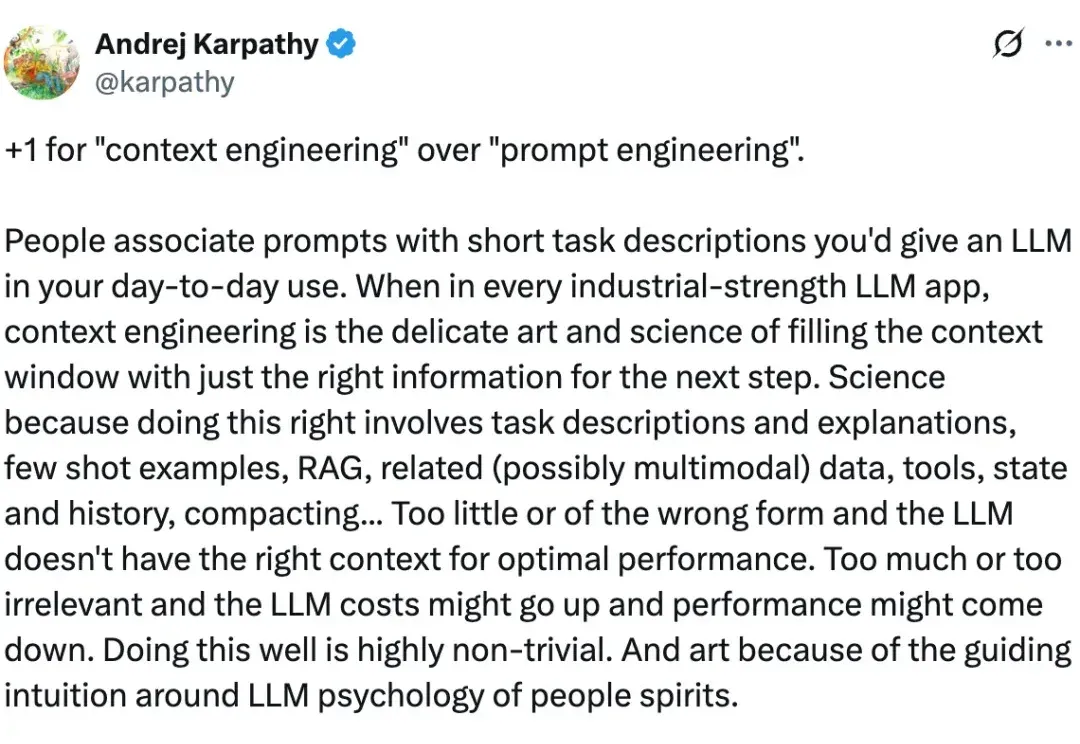
上下文工程:为什么你的 AI Agent 总是“断片”? (opens in a new tab)
AI Agent 在处理复杂任务时经常“掉链子”。你刚告诉它的信息,它很快就忘了。给它的工具越多,它反而越混乱。这不是个例。
Total 348 articles
AI Agent 在处理复杂任务时经常“掉链子”。你刚告诉它的信息,它很快就忘了。给它的工具越多,它反而越混乱。这不是个例。
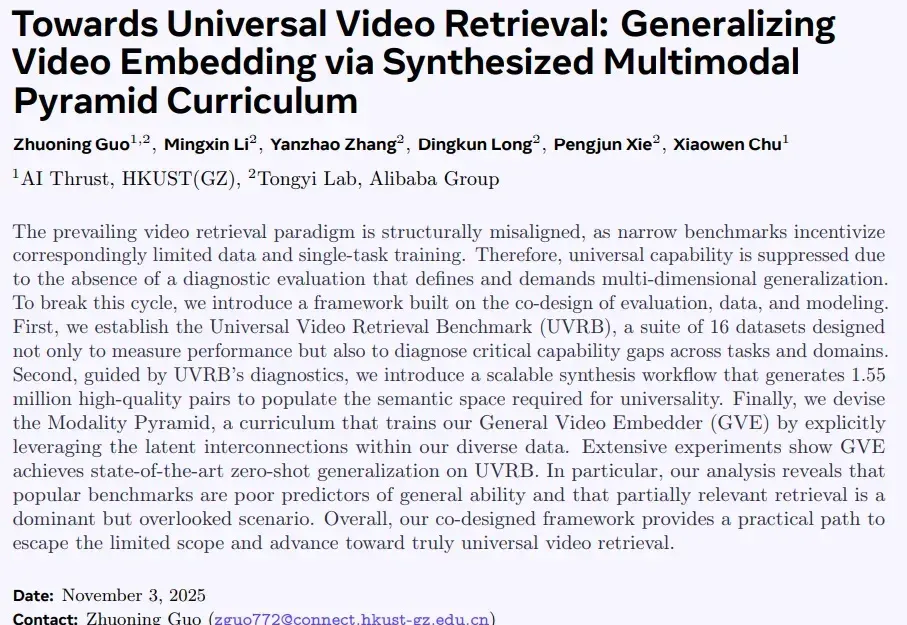
当前视频检索研究正陷入一个闭环困境:以MSRVTT为代表的窄域基准,长期主导模型在粗粒度文本查询上的优化,导致训练数据有偏、模型能力受限,难以应对真实世界中细粒度、长上下文、多模态组合等复杂检索需求。
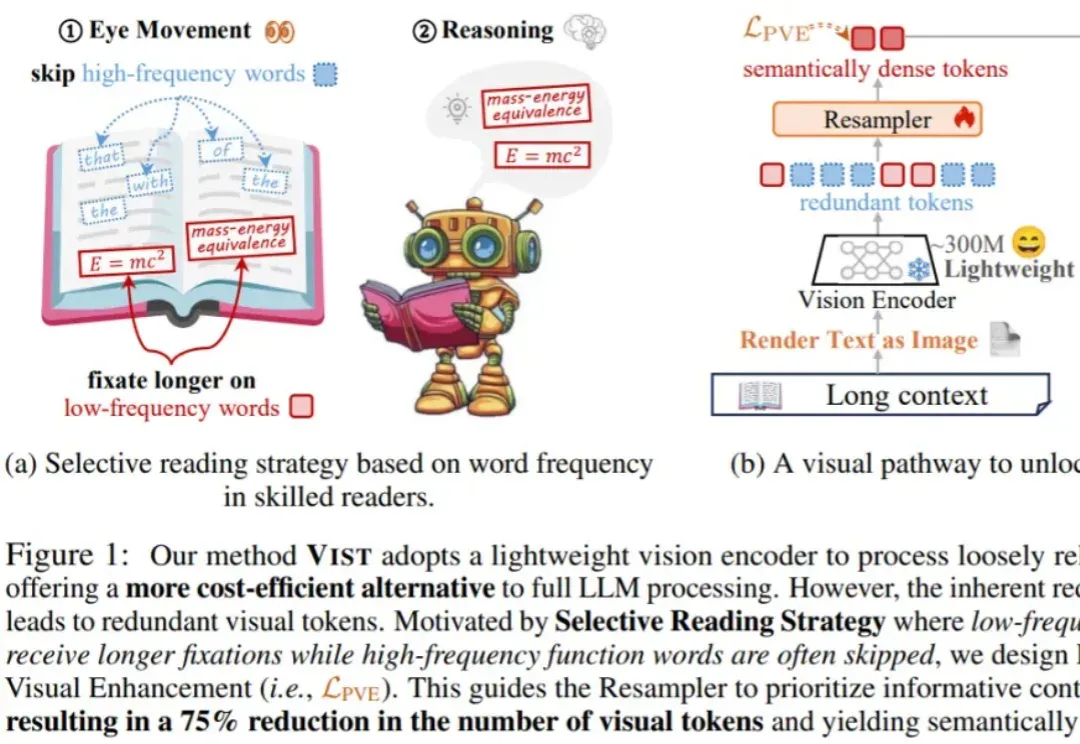
在处理短文本时,大语言模型(LLM)已经表现出惊人的理解和生成能力。但现实世界中的许多任务 —— 如长文档理解、复杂问答、检索增强生成(RAG)等 —— 都需要模型处理成千上万甚至几十万长度的上下文。
大模型「灾难性遗忘」问题或将迎来突破。近日,NeurIPS 2025收录了谷歌研究院的一篇论文,其中提出一种全新的「嵌套学习(Nested Learning)」架构。实验中基于该框架的「Hope」模型在语言建模与长上下文记忆任务中超越Transformer模型,这意味着大模型正迈向具备自我改进能力的新阶段。
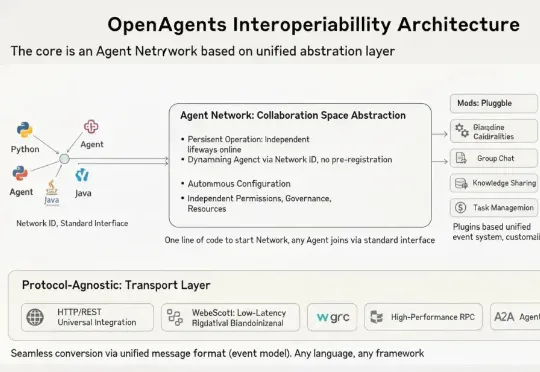
静态编排 VS 动态编排,谁是多agent系统最优解?通常来说,面对简单问题,采用react模式的单一agent就能搞定。可遇到复杂问题,单一agent就会立刻出现包括但不限于以下问题:串行执行效率低:无法同时完成并行的子步骤(如 “同时爬取 A、B 两个网站的数据”)。
月之暗面最新发布的开源Kimi Linear架构,用一种全新的注意力机制,在相同训练条件下首次超越了全注意力模型。在长上下文任务中,它不仅减少了75%的KV缓存需求,还实现了高达6倍的推理加速。
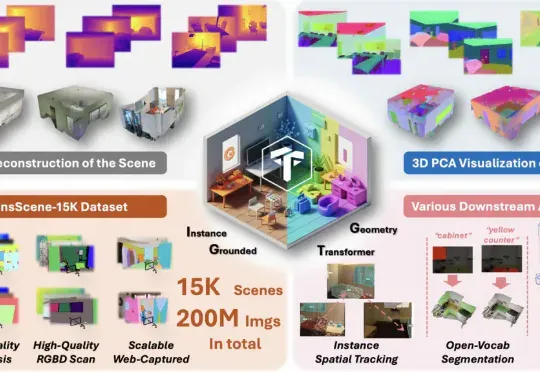
现在,NTU联合StepFun提出了IGGT (Instance-Grounded Geometry Transformer) ,一个创新的端到端大型统一Transformer,首次将空间重建与实例级上下文理解融为一体。
生数科技前产品副总裁廖谦创业了。在此之前,他还先后担任过字节剪映与火山引擎前AIGC产品负责人。8月底从老东家离职后,公司成立仅半个月,就已经拿下了硅谷美元基金HT Investment与BV百度风投的数百万美元投资。
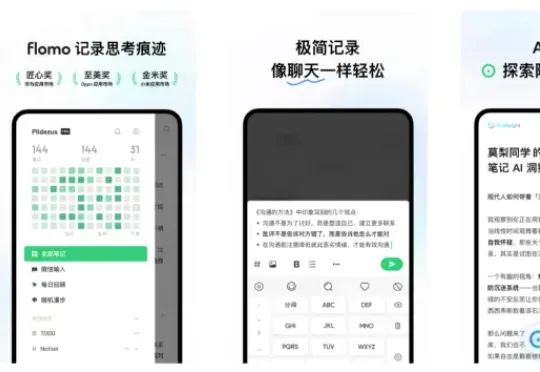
近两年,AI笔记成为AI应用落地的重点方向之一。随着大模型能力不断升级,AI笔记不再只是帮用户“写下东西”,而是试图理解、整理、提炼、甚至帮用户“思考”所记录下的内容。市场上AI笔记产品繁多,既有印象笔记、Notion AI这样加入AI能力的传统笔记产品,也有闪念贝壳、喵记多这样的AI原生笔记产品,甚至还有飞书文档这样将AI笔记功能嵌入办公套件的综合性产品。
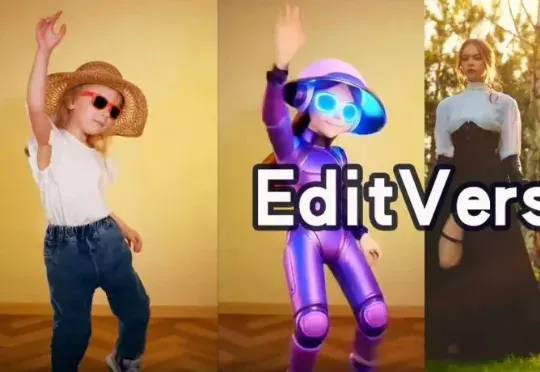
全新AI工具EditVerse将图片和视频编辑整合到一个框架中,让你像P图一样轻松P视频。通过统一的通用视觉语言和上下文学习能力,EditVerse解决了传统视频编辑复杂、数据稀缺的问题,还能实现罕见的「涌现能力」。在效果上,它甚至超越了商业工具Runway,预示着一个创作新纪元的到来。