“美国公司制造的最好开源模型”,基模来自DeepSeek (opens in a new tab)
总部位于旧金山的初创公司 Deep Cogito 发布了其最新一代旗舰模型 Cogito v2.1 671B。公司 CEO Drishan Arora 在社交平台 X 上豪情万丈地宣布:“今天,我们发布了由美国公司制造的最好的开源大语言模型。”
Total 530 articles
总部位于旧金山的初创公司 Deep Cogito 发布了其最新一代旗舰模型 Cogito v2.1 671B。公司 CEO Drishan Arora 在社交平台 X 上豪情万丈地宣布:“今天,我们发布了由美国公司制造的最好的开源大语言模型。”
刚刚,DeepMind前研究员创立、成立一年多的AI初创Reflection AI,竟斩获高达20亿美元融资。估值瞬间飙升至80亿美元!从谷歌前CEO施密特到英伟达,再到红杉、花旗,顶级玩家争相入局,一场围绕开源AI主权的科技冷战,正在燃起资本最狂热的火焰。
CUDA又双叒叕被创了… 这回动手的,还是英伟达亲手喂大的AI。 一家成立仅一年的小公司,用AI编程Agent,只花10小时,就搭出了一套「类CUDA软件」。 停停停。 你是说这套英伟达花了近20年搭起来的软件帝国,就这么被复刻了?? 不止如此。DeepSeek也在尝试少写一点底层CUDA。 他们已经开源了一套名为TileKernels的GPU算子库,用TileLang来编写,省去了大量手写底层CUDA代码的工作。 不过类似的「CUDA危机」,咱也不是第一次听了。 每隔一段时间,CUDA都要被拎出来鞭打一番,动辄替代了、击穿了、护城河又被颠覆了… 真的是这样么? 10小时「复刻」CUDA 提起
@elsewhere 上个月,「elsewhere」报道了 DeepSeek 的融资故事。其中最多人讨论的,莫过于那个传说中的4小时投资人会议。 此去一个月间,梁文锋的各种语录在江湖流传,我们也多方收集到了一些其中内容。
“这些人在往哪跑?为什么跑” “大模型浪潮狂飙三年半,国内AI人才也经历了三波大迁移。”资深科技猎头赵捷告诉雷峰网。 前两年,大家抢的是预训练人才,先是百度文心团队被疯抢,然后是AI六小虎人才遭遇瓜分,紧接着又是阿里、DeepSeek、字节、腾讯之间的人才大混战。 而现在,大家又开始抢推理、Agent等后训练人才;最近一年不少预训练人才,如Qwen Code负责人惠彬原、混元大语言模型预训练负责人姚星丞、混元多模态理解预训练负责人彭厚文,字节Seed核心专家顾全全等陆续离职,要么创业,要么流向更纯粹的AI研究团队。 是什么促成了这一轮轮AI人才大迁徙?这背后又藏着哪些AI行业更深层的逻辑转变?
春节还没到,「过年的气氛」已经渗入科技圈每个人的毛孔。单说 AI 大模型这一块,刚刚发布的有 kimi 2.5 和 Step 3.5 Flash,即将发布的据说还有 DeepSeek V4,GPT-5.3、Claude Sonnet 5、Qwen 3.5,GLM-5,说不定一觉醒来,现有的技术就要被颠覆。
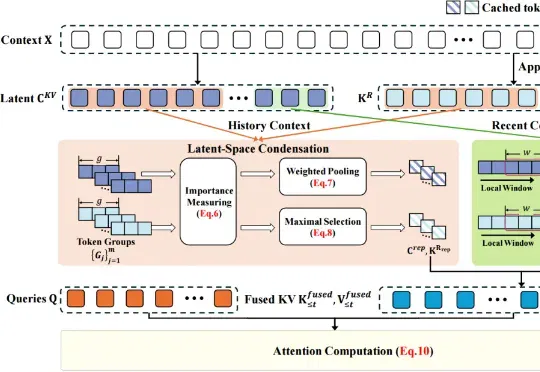
近日,琶洲实验室、华南理工大学、蔻町(AIGCode)等单位科研团队联合提出潜在空间压缩注意力(Latent-Condensed Attention,LCA),研究成果入选 ACL 2026。
众所周知,大模型训练成本极高。 但大家又知道,降低训练精度能够显著降低训练成本。DeepSeek-V3 用 FP8 训练把成本打到了 560 万美元,已经让全行业侧目。 在 FP8 成功后,行业仍然在不断探索低精度的边界:从 FP8 降到 FP4,训练成本还能再降多少? 理论上,FP4 的计算吞吐可以是 FP8 的两倍。NVIDIA Blackwell 和 AMD MI350 系列都已经在硬件层面原生支持了 FP4 运算,前者在 B200 上标称 FP4 算力可达 4500 TOPS(稀疏)。硬件已经准备好了,但软件和算法那一侧,一直卡在一个问题上: 用 FP4 从头训练大模型,训练过程非常不
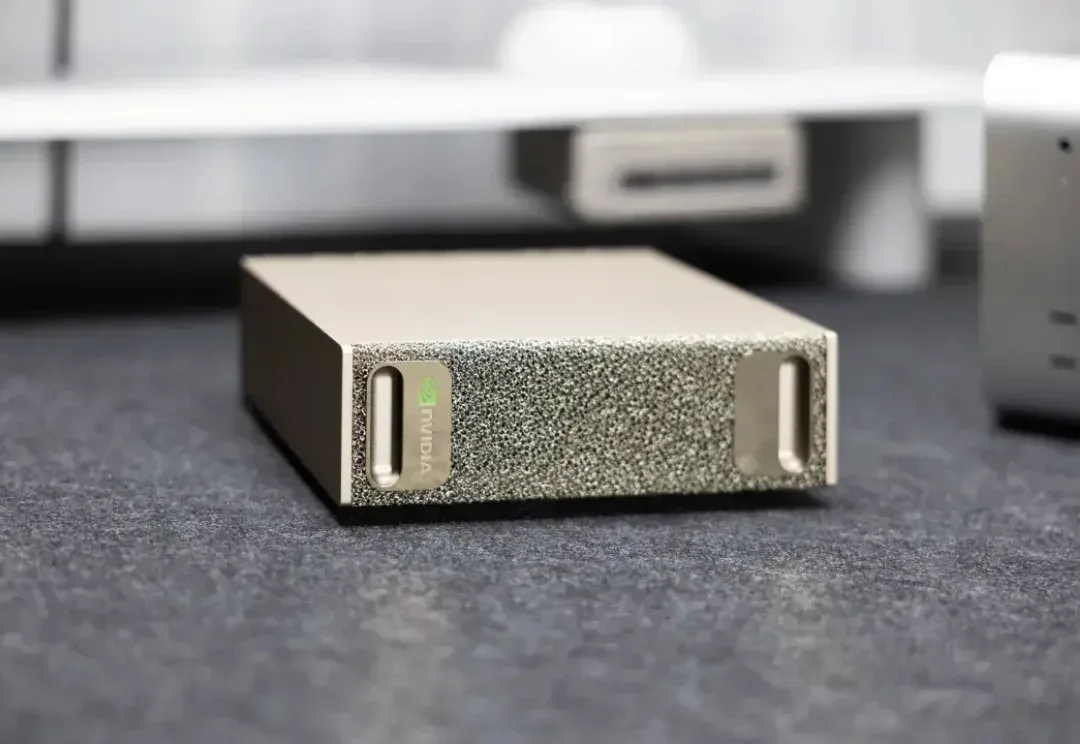
最近,APPSO 终于拿到了这台来自黄仁勋倾情推荐的个人超算,英伟达 DGX Spark;到手的第一感觉,就是「小而美」。这电脑也太小了,没有 Mac Studio 那般笨重,可能就和 Mac Mini 差不多大;然后是银色的亮和用来散热的金属丝网又让它有点不一样,是专属的硬核美感。
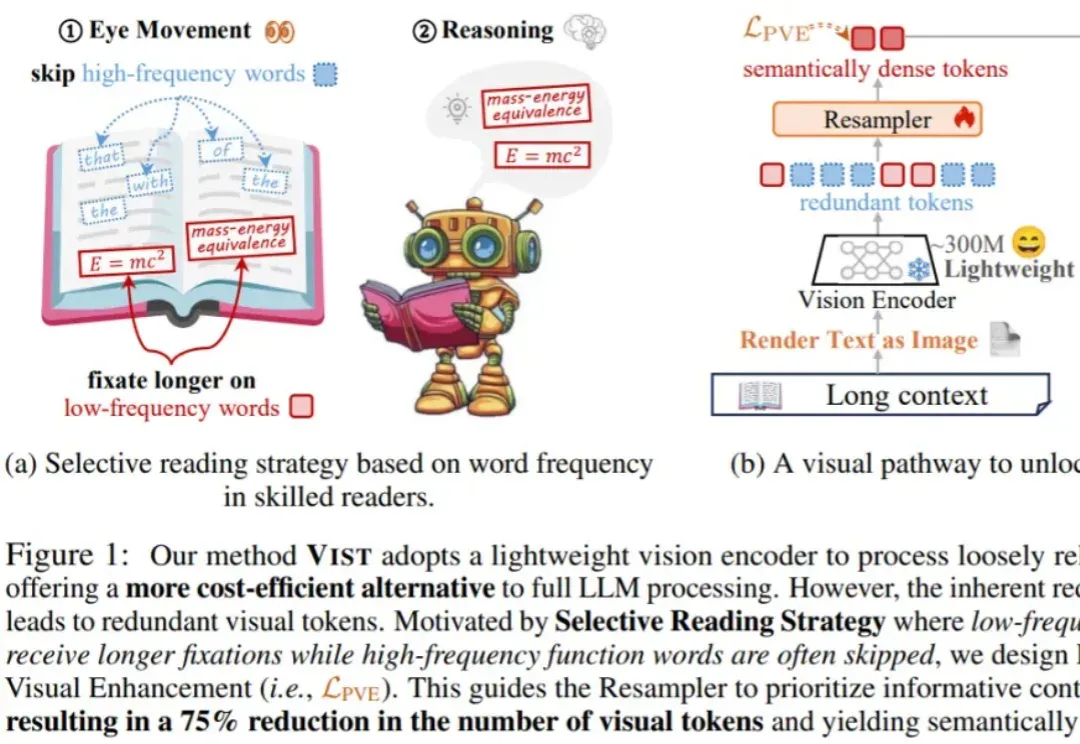
在处理短文本时,大语言模型(LLM)已经表现出惊人的理解和生成能力。但现实世界中的许多任务 —— 如长文档理解、复杂问答、检索增强生成(RAG)等 —— 都需要模型处理成千上万甚至几十万长度的上下文。