图灵奖得主LeCun最后警告Meta!我搞了40年AI,大模型是死路 (opens in a new tab)
图灵奖得主LeCun与Meta分道扬镳!LLM邪路一条,「世界模型才是」未来。
Total 375 articles
图灵奖得主LeCun与Meta分道扬镳!LLM邪路一条,「世界模型才是」未来。
谷歌在第三天发布了《上下文工程:会话与记忆》(Context Engineering: Sessions & Memory) 白皮书。文中开篇指出,LLM模型本身是无状态的 (stateless)。如果要构建有状态的(stateful)和个性化的 AI,关键在于上下文工程。
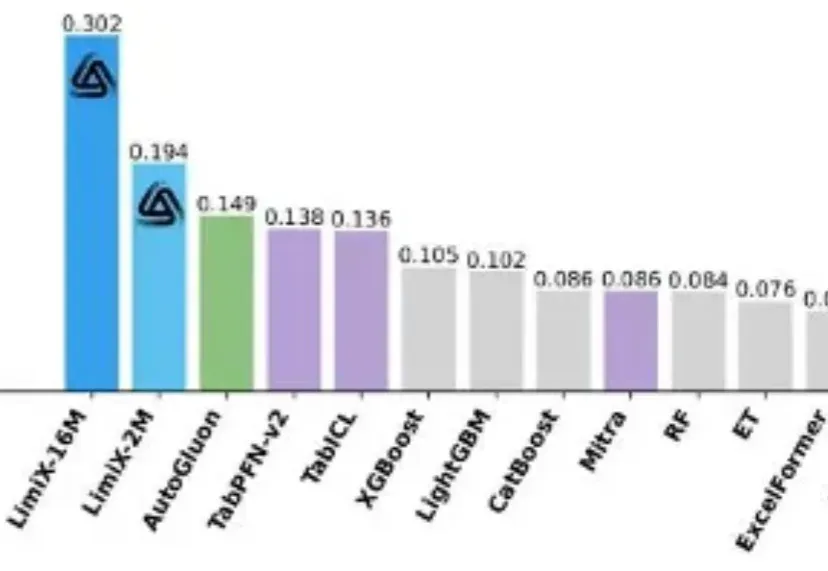
提到 AI 的突破,人们首先想到的往往是大语言模型(LLM):写代码、生成文本、甚至推理多模态内容,几乎重塑了通用智能的边界。但在一个看似 “简单” 的领域 —— 结构化表格数据上,这些强大的模型却频频失手。
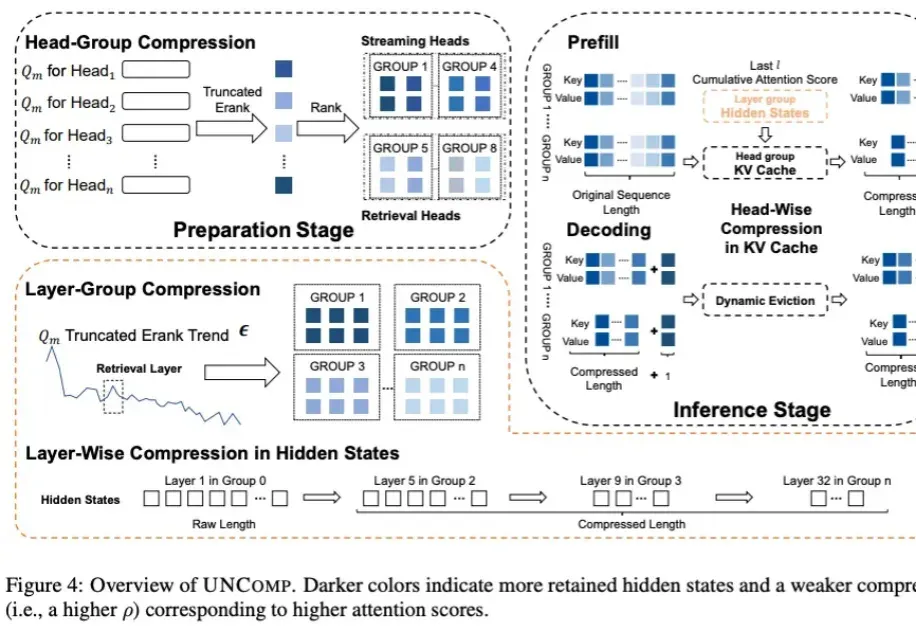
我们都知道 LLM 中存在结构化稀疏性,但其底层机制一直缺乏统一的理论解释。为什么模型越深,稀疏性越明显?为什么会出现所谓的「检索头」和「检索层」?
复杂的简历,AI也能读懂了。 阿里巴巴集团研究团队,开发出了一套基于布局感知的简历解析框架。 该框架在简历解析任务上的准确率逼近Claude-4等业界顶尖大模型,处理整份简历仅需1-2秒。 而且这项创新直击自动化简历解析的三大痛点——版面格式多样、大模型成本高昂及响应速度慢,为智能招聘树立了新的效率与精度标杆。 该技术框架的论文《Layout-Aware Parsing Meets Efficient LLMs: A Unified, Scalable Framework for Resume Information Extraction and Evaluation》已发布。 长久以来,自动
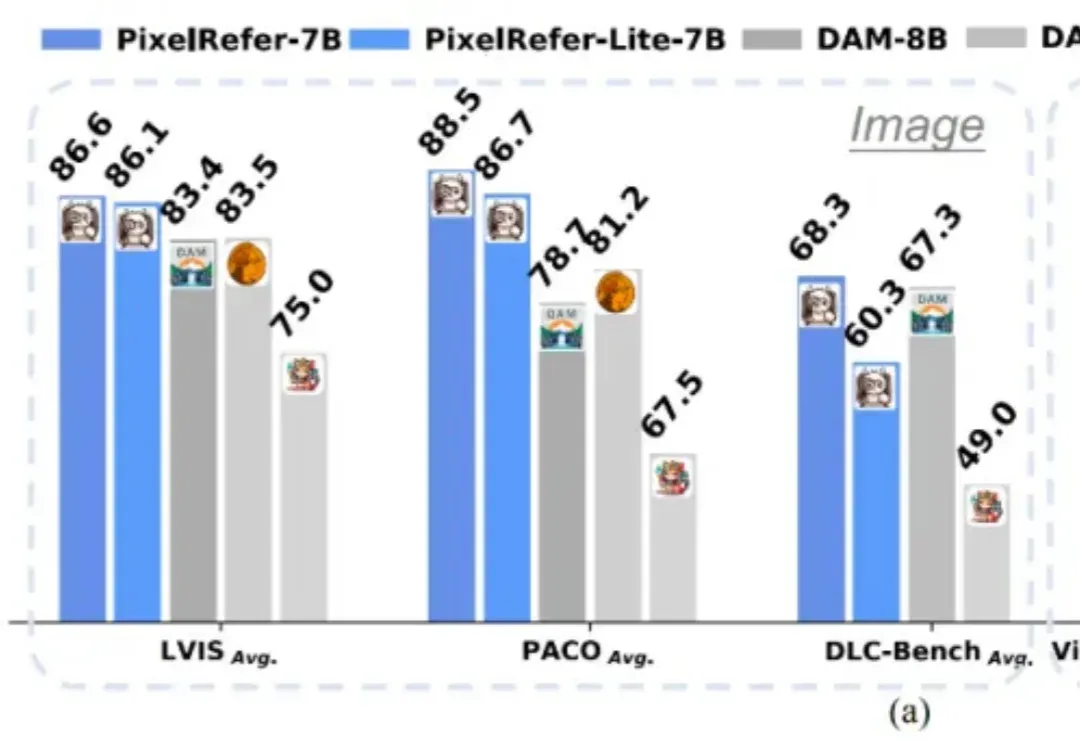
多模态大模型(MLLMs)虽然在图像理解、视频分析上表现出色,但多停留在整体场景级理解。
近期,HuggingFace 发布的超过 200 页的超长技术博客,系统性地分享训练先进 LLM 的端到端经验。
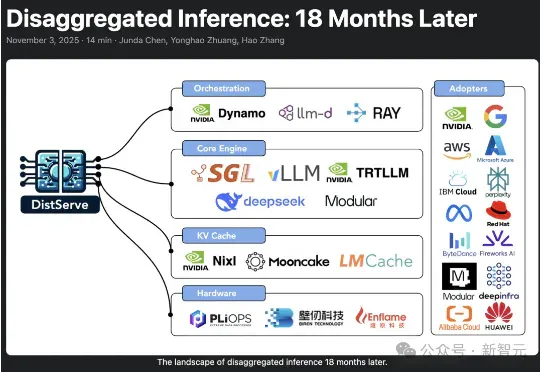
2024年,加州大学圣地亚哥分校「Hao AI Lab」提出了DistServe的解耦推理理念,短短一年多时间,迅速从实验室概念成长为行业标准,被NVIDIA、vLLM等主流大模型推理框架采用,预示着AI正迈向「模块化智能」的新时代。
近日,谷歌推出了一种全新的用于持续学习的机器学习范式 —— 嵌套学习,模型不再采用静态的训练周期,而是以不同的更新速度在嵌套层中进行学习,即将模型视为一系列嵌套问题的堆叠,使其能够不断学习新技能,同时又不会遗忘旧技能。
这说明o1不仅能够使用语言,还能够思考语言,具备元语言能力(metalinguistic capacity )。由于语言模型只是在预测句子中的下一个单词,人对语言的深层理解在质上有所不同。因此,一些语言学家表示,大模型实际上并没有在处理语言。