刚刚,腾讯最新世界模型开源!一句话造出3D世界,兼容游戏引擎 (opens in a new tab)
今日,腾讯正式发布并开源混元3D世界模型2.0(HY-World 2.0)。作为一款多模态的世界模型,HY-World 2.0支持文字、图片和视频等形式输入,可自动生成、重建并模拟完整的3D世界。
Total 438 articles
今日,腾讯正式发布并开源混元3D世界模型2.0(HY-World 2.0)。作为一款多模态的世界模型,HY-World 2.0支持文字、图片和视频等形式输入,可自动生成、重建并模拟完整的3D世界。
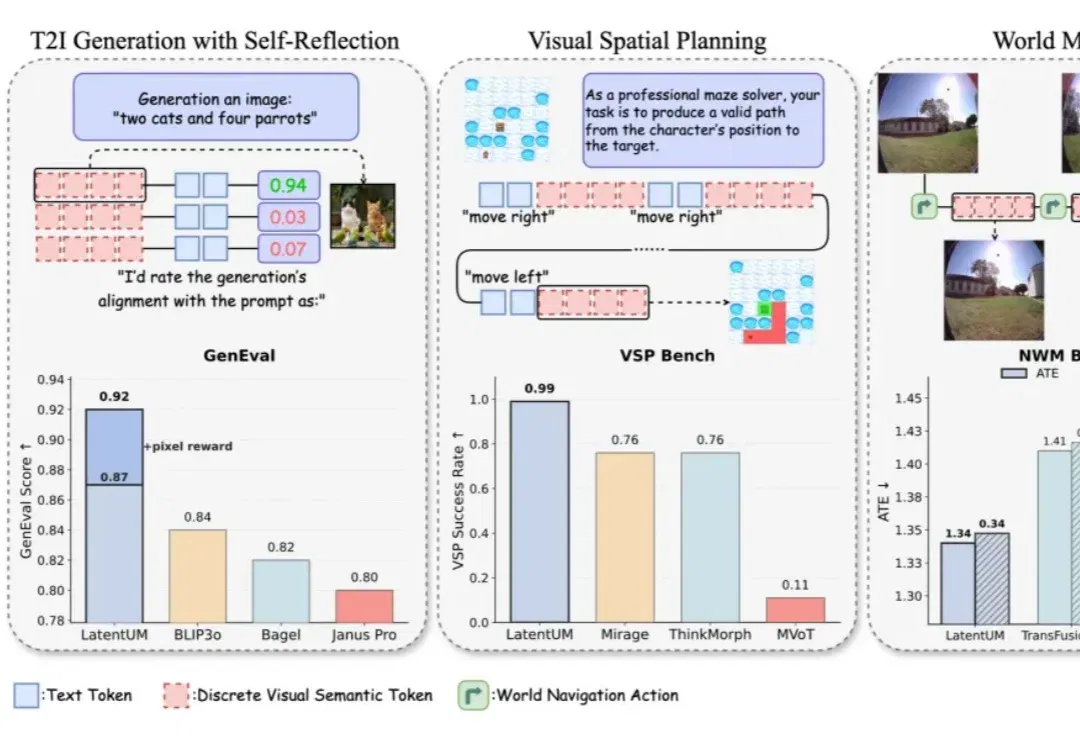
过去一段时间,生成理解统一模型(Unified Model)经常被理解成一种「既能看懂图、又能生成图」的多模态通用系统。
MSL交出首张答卷。 Meta的“牛油果”模型,终于熟了! 智东西4月9日报道,今天,在成立9个月后,Meta超级智能实验室(MSL)发布了其首款模型Muse Spark(内部代号牛油果)。这是一个原生的多模态推理模型,支持工具使用、视觉思维链和多智能体编排。 在大模型测评平台Artificial Analysis上,Muse Spark的智能指数直接从Llama 4 Maverick的18分,跳到了52分,介于Claude Sonnet 4.6和Claude Opus 4.6之间,算是进入第一梯队了。 我们第一时间对模型做了体验,上传了一张豆包App的截图,要求Muse Spark复刻。可以
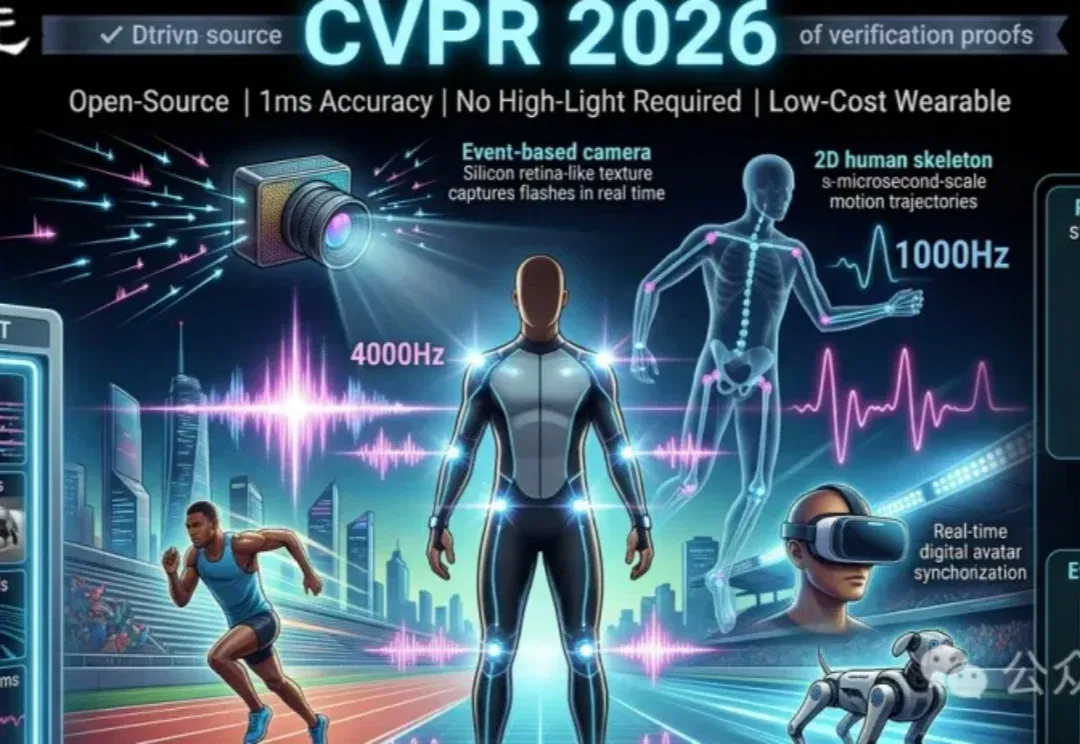
全球首个1毫秒级人体动作捕捉系统FlashCap,通过闪烁LED与事件相机结合,实现1000Hz超高帧率捕捉。无需昂贵设备或强光环境,低成本穿戴服即可精准捕捉极速动作。团队同步开源715万帧的FlashMotion数据集与多模态模型ResPose,显著提升运动分析精度,推动体育、VR与机器人领域迈向高动态智能新阶段。
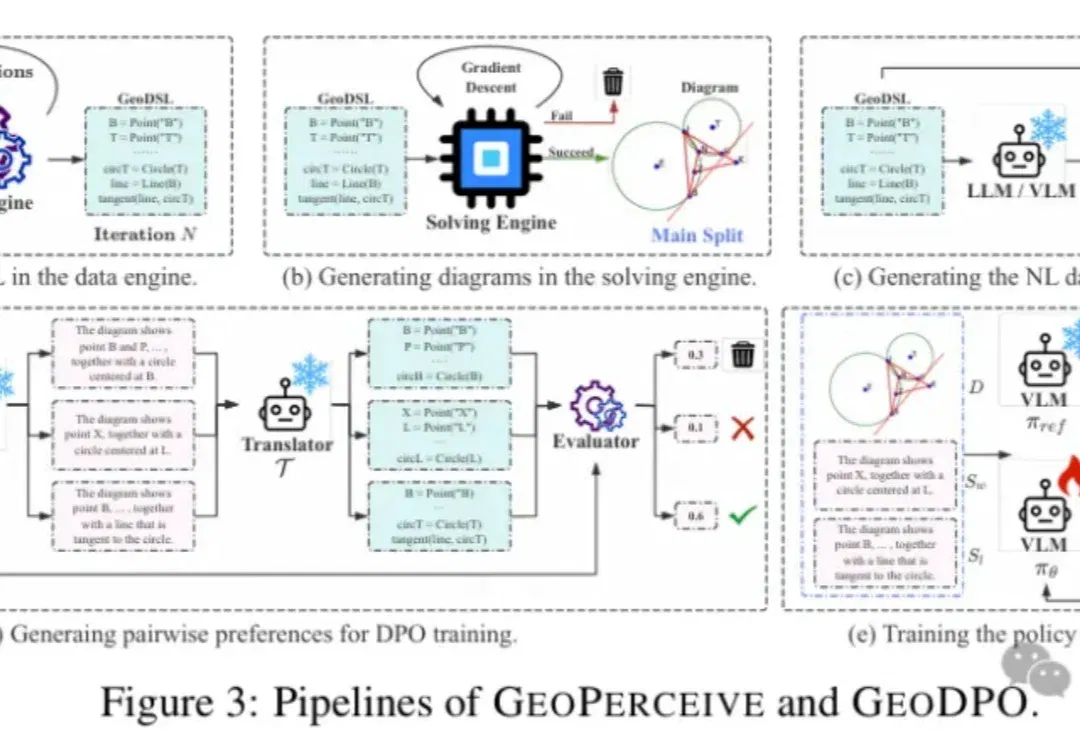
几何问题,真的只是“推理难”吗? 近年来,视觉语言模型(VLMs)在图文问答、表格理解、数学应用题等多模态任务上取得了显著进展。 但当问题变成几何图形时,它们的表现却往往明显下降。 为什么? 近日,来自光明实验室与清华大学的研究团队深入剖析了多个主流模型的错误案例,观察到一个值得关注的现象: 当前VLM在几何问题上的失败,很大程度上暴露出其几何感知错误(perceptual errors)的短板,而这一核心因素在现有研究中往往未被单独系统分析。 换句话说,在不少情况下,模型并不是不会推理,而是在更早阶段——对图形结构的识别已经出现偏差。 常见问题包括: 错误识别几何基本元素(点、线、圆)漏检关
一家企业花了七周时间部署 AI:第 1 周精准回答行业分析问题,团队欢呼;第 3 周反复回答相同的错误结论,因为它“忘了”上周的修正;第 5 周在董事会汇报中引用了已被否定的数据,造成决策偏差;第 7 周项目暂停,“AI 不可信”成为共识。问题不在于 AI 不够聪明,而在于它每次醒来都是一张白纸。
36氪获悉,以AI为核心的数字内容公司珀乐互动科技(下称“珀乐互动”)已完成天使轮融资,金额为数千万元人民币。本轮投资由星连资本领投、春华创投跟投,资金将重点用于技术研发、团队扩充与IP商业化开发,全面加速公司多模态泛娱乐生态的战略布局。
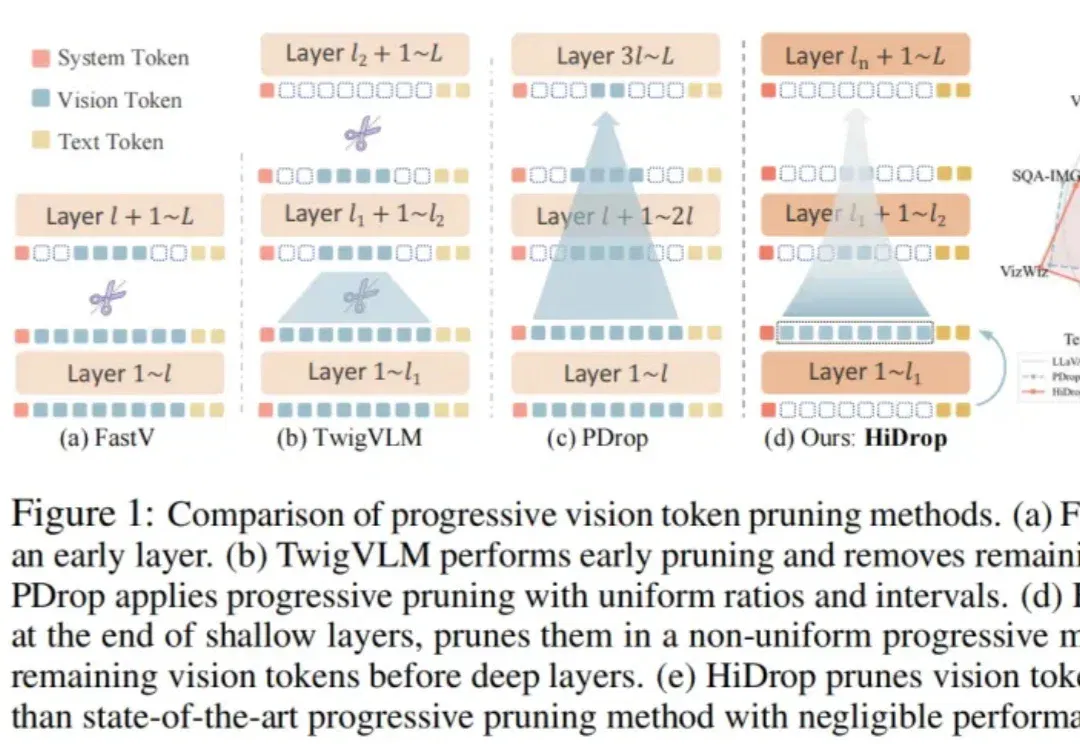
随着多模态大语言模型(MLLM)支持更长上下文,高分辨率图像和长视频会产生远多于文本的视觉 Token,在自注意力二次复杂度下迅速成为效率瓶颈。
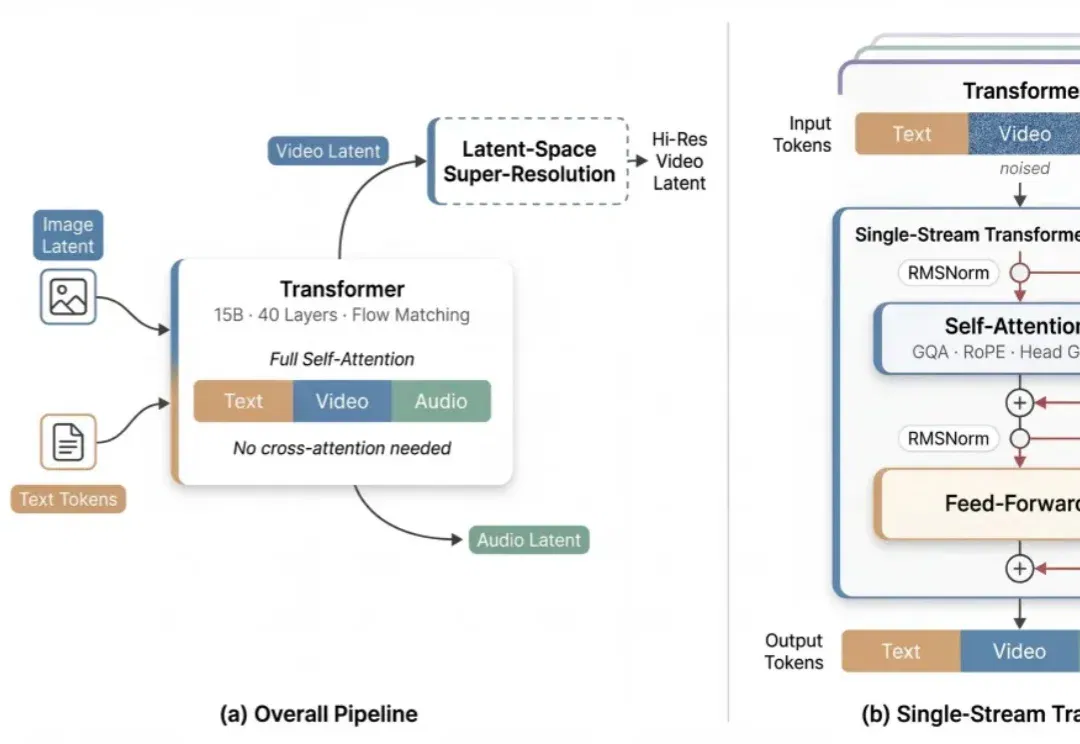
开源多模态生成领域,迎来架构级的底层突破。
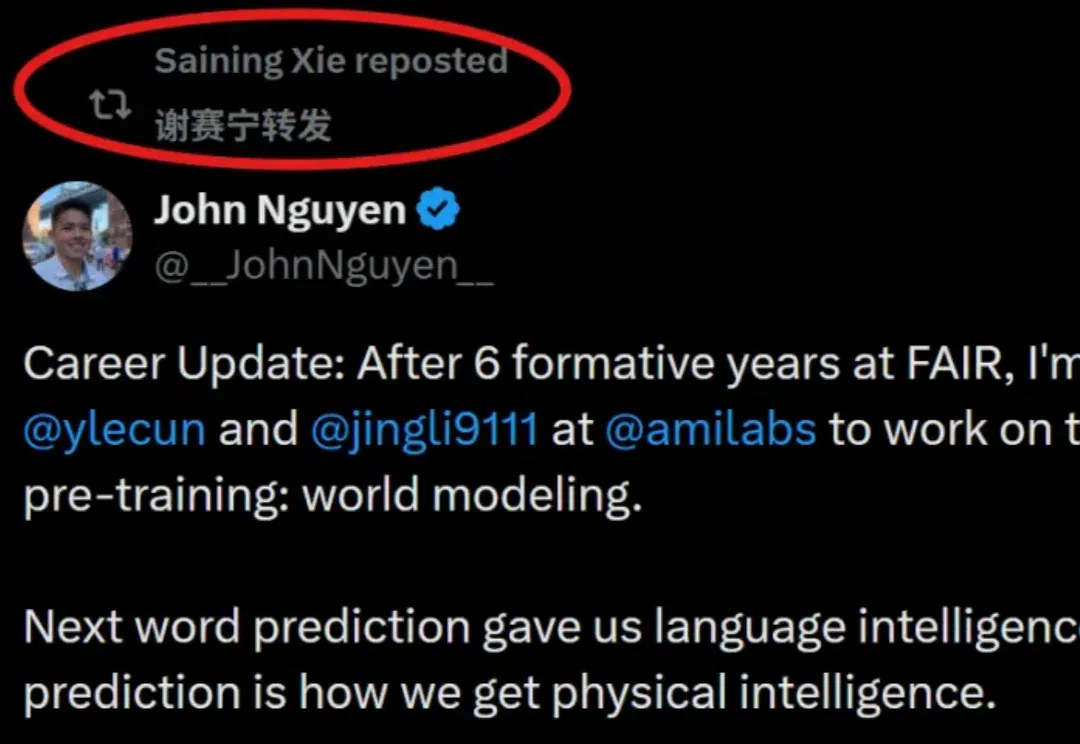
事情果然和大家预想的一样! 出走创业的LeCun,反手就把Meta(FAIR)6年老将挖走了。 被挖的小哥叫John Nguyen(以下简称John哥),属于那种名校一毕业就加入Meta的人。 6年时间,John哥几乎完整经历了FAIR这一轮技术演进的所有关键节点: 从最早的联邦学习(Federated Learning),到后来的大模型训练,再到多模态,John哥逐渐成长为FAIR团队的中坚力量。 本以为马上就能跨入“世界模型”大门了,结果没想到Meta突然甩出一堆“骚操作”(懂的都懂)。 最终结局是,曾创立FAIR的LeCun润了、FAIR整个部门也被逐渐边缘化……总之就是一团糟。 所以,