免费!DeepSeek-V4-Pro薅羊毛指南 (opens in a new tab)
DeepSeek这半年生态铺得很快。现在好几个渠道可以免费或极低成本用上DeepSeek模型,从V4 Flash到V4 Pro都有。整理一下最实用的三条路。
Total 108 articles
DeepSeek这半年生态铺得很快。现在好几个渠道可以免费或极低成本用上DeepSeek模型,从V4 Flash到V4 Pro都有。整理一下最实用的三条路。
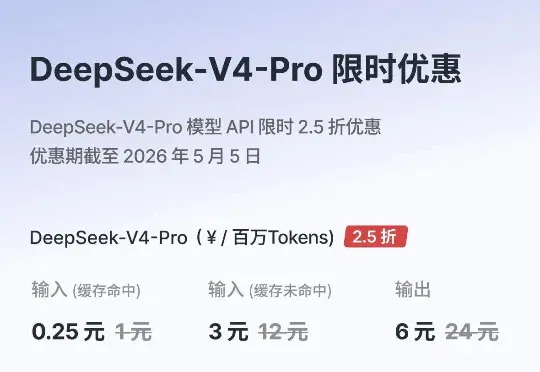
最新消息是,DeepSeek V4 Pro 2.5折的大力度优惠来啦!官方API文档显示,DeepSeek-V4-Pro模型API限时2.5折优惠,优惠期截至2026年5月5日。 具体是这样: 1️⃣百万tokens输入(缓存命中)折后0.25元(原价1元); 2️⃣百万tokens输入(缓存未命中)折后3元(原价12元); 3️⃣百万tokens输出折后6元(原价24元)。
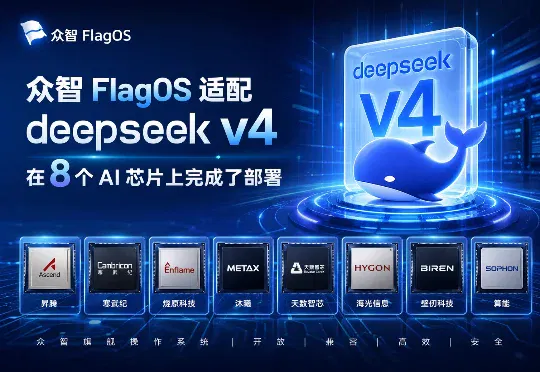
由智源研究院牵头研发的众智 FlagOS 第一时间对两个“巨无霸”模型进行全量适配,已经完成 DeepSeek-V4-Flash 在8款以上 AI 芯片上的全量适配与推理部署,包括海光、沐曦、华为昇腾、摩尔线程(FP8)、昆仑芯、平头哥真武、天数、英伟达(FP8)等芯片。FlagOS 同时正在推进 DeepSeek-V4-Pro 模型在多个芯片的迁移适配,晚些时间开源出来,敬请期待。
今天,我们全新系列模型 DeepSeek-V4 的预览版本正式上线并同步开源。DeepSeek-V4 拥有百万字超长上下文,在 Agent 能力、世界知识和推理性能上均实现国内与开源领域的领先。模型按大小分为两个版本:
我们独家获悉,外界千呼万唤的DeepSeek-V4将于4月正式上线。作为梁文锋打磨已久的多模态大模型,DeepSeek-V4除了在Coding能力上跃升之外,还将在LTM(long term memory长期记忆)上取得突破。
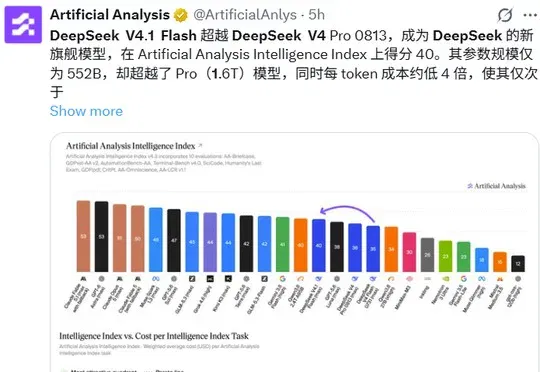
DeepSeek V4.1 Flash技术报告揭秘其通过CED架构对半削减prefill计算、CSA2同时吃满条目/序列/层三个压缩维度、FP4量化main KV缓存及SWA Bounded Replay部署优化等手段,将全局KV缓存压至V4-Flash的1/4、持久化KV压至约1/8,以552B参数实现超越1.6T参数V4 Pro的性能。
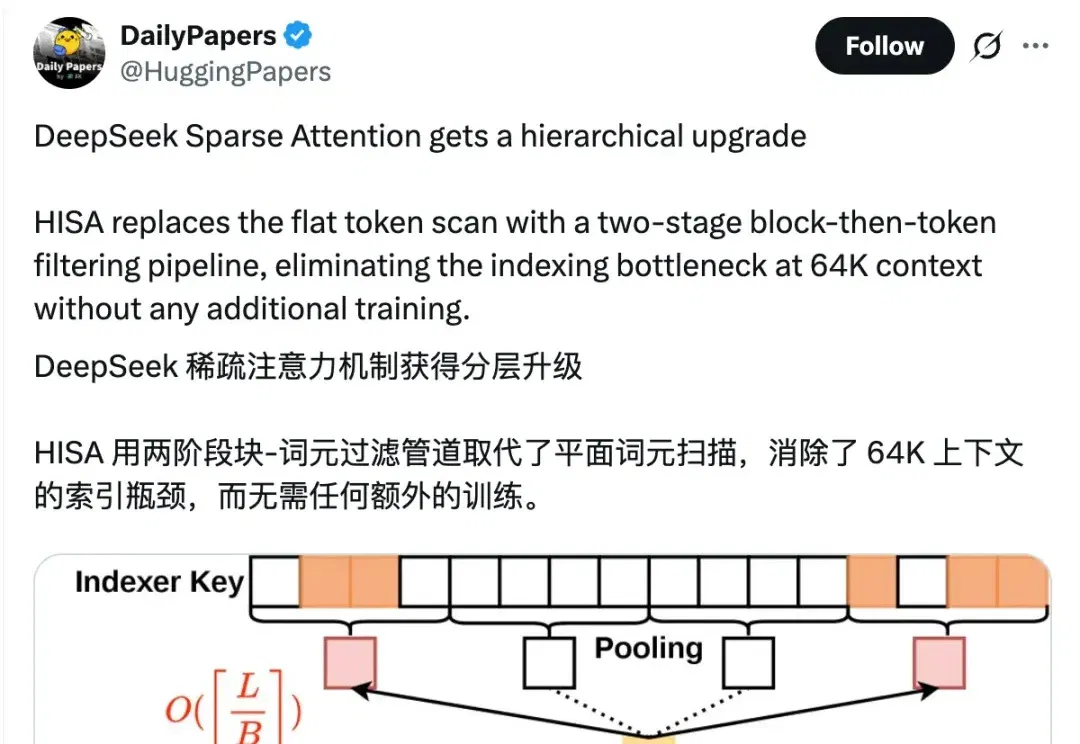
就在大家都急头白脸地等待DeepSeek-V4的时候,冷不丁一篇新论文引起了网友们的注意—— 提出新稀疏注意力机制HISA(分层索引稀疏注意力),突破64K上下文的索引瓶颈,相比DeepSeek正在用的DSA(DeepSeek Sparse Attention)提速2-4倍。
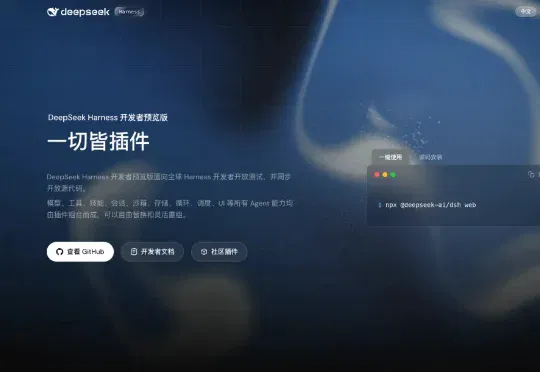
在昨天正式发布DeepSeek V4 Pro正式版之后。 预告了很久的,DeepSeek家自己的Agent产品终于也发出来了。 名字叫,DeepSeek Harness。 理念也很清晰,一切皆插件。 可能是有史以来最快的速度,截止到我写完文,它在Github上到了3万7的Star。
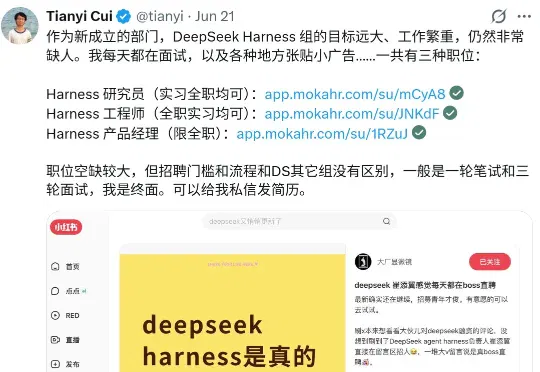
今天凌晨,DeepSeek V4 Pro 正式版发布,引发热潮。现在,半天过去,DeepSeek Harness (开发者预览版)也来了!当然,这并不意外,毕竟该项目之前已经铺垫了很久了,比如 DeepSeek Harness 团队的崔添翼就一直在社交网络上发预热贴以及为该团队招募人才。
其实 Codex 和 Claude Code 都支持切换模型,咱们直接用 DeepSeek-V4-Flash 来驱动它们就行,量大管饱、不用魔法、也不怕封号。而且现在 DeepSeek 官方已经做了原生适配,接入流程比以前简单多了。