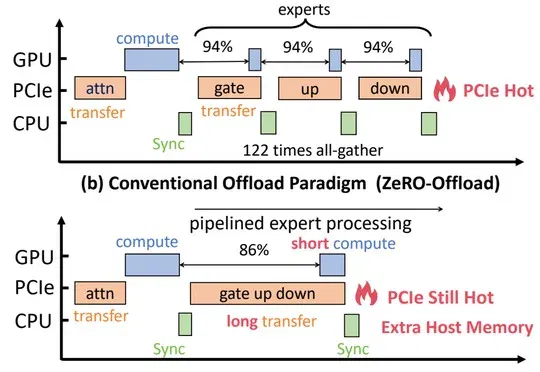
别再让计算等着搬权重了!KTransformers让CPU直接参与MoE微调计算 (opens in a new tab)
清华大学MADSys实验室与趋境科技主导提出开源KTransformers-FineTune(KT-FT),让CPU直接参与MoE专家计算并优化布局与线程调度,使LoRA微调吞吐达到传统卸载范式的2.5~21.2倍。
Total 126 articles
清华大学MADSys实验室与趋境科技主导提出开源KTransformers-FineTune(KT-FT),让CPU直接参与MoE专家计算并优化布局与线程调度,使LoRA微调吞吐达到传统卸载范式的2.5~21.2倍。
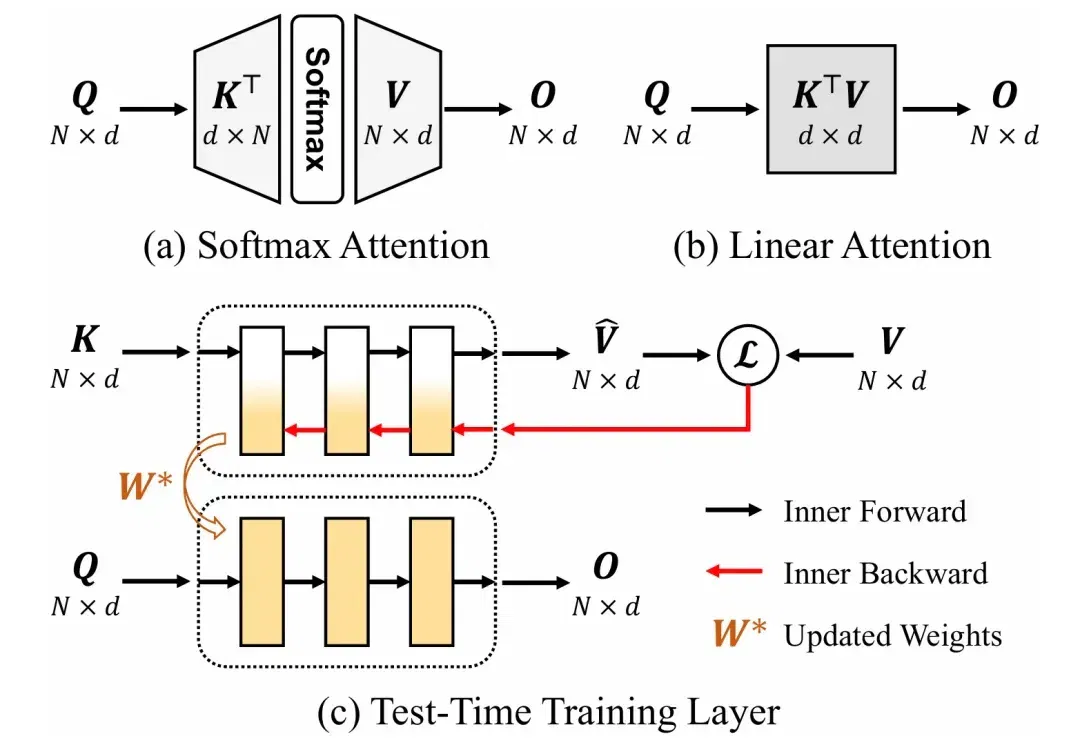
序列建模是大语言模型、计算机视觉等领域的基础共性问题。当前通用的 Transformer 模型计算复杂度随序列长度平方增长,在长序列任务中面临显著的计算挑战。因此,研究者们一直在探索具有线性计算复杂度的高效序列建模方法。
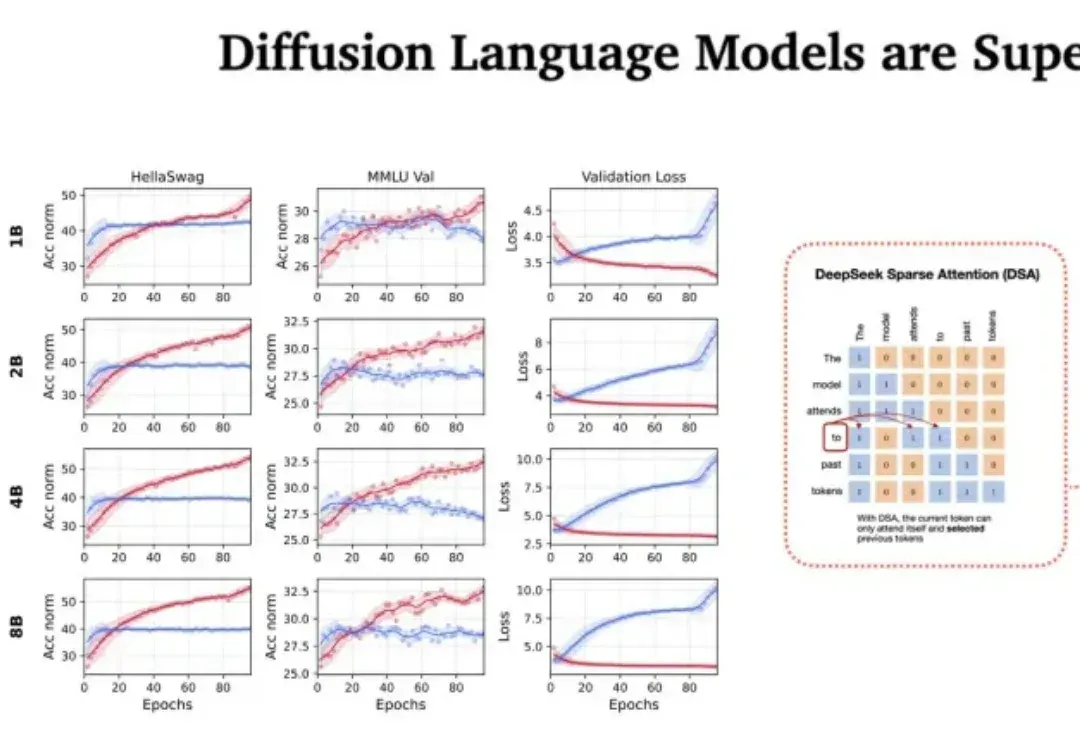
站在 2026 年的开端回望,LLM 的架构之争似乎进入了一个新的微妙阶段。过去几年,Transformer 架构以绝对的统治力横扫了人工智能领域,但随着算力成本的博弈和对推理效率的极致追求,挑战者们从未停止过脚步。
深夜,梁文锋署名的DeepSeek新论文又来了。这一次,他们提出全新的Engram模块,解决了Transformer的记忆难题,让模型容量不再靠堆参数!
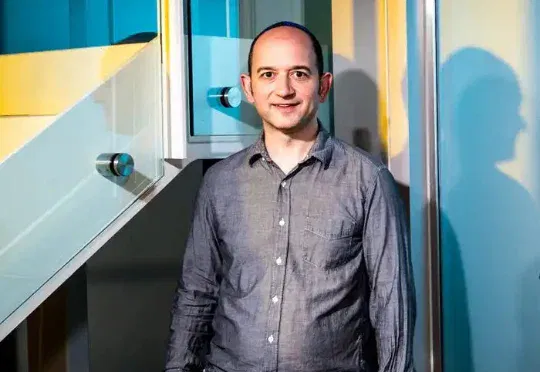
AI 圈又迎来一次标志性的人才流动。就在刚刚,Transformer 论文作者之一,知名 AI 研究员 Noam Shazeer 在 社交媒体发文宣布,他将正式加入 OpenAI。
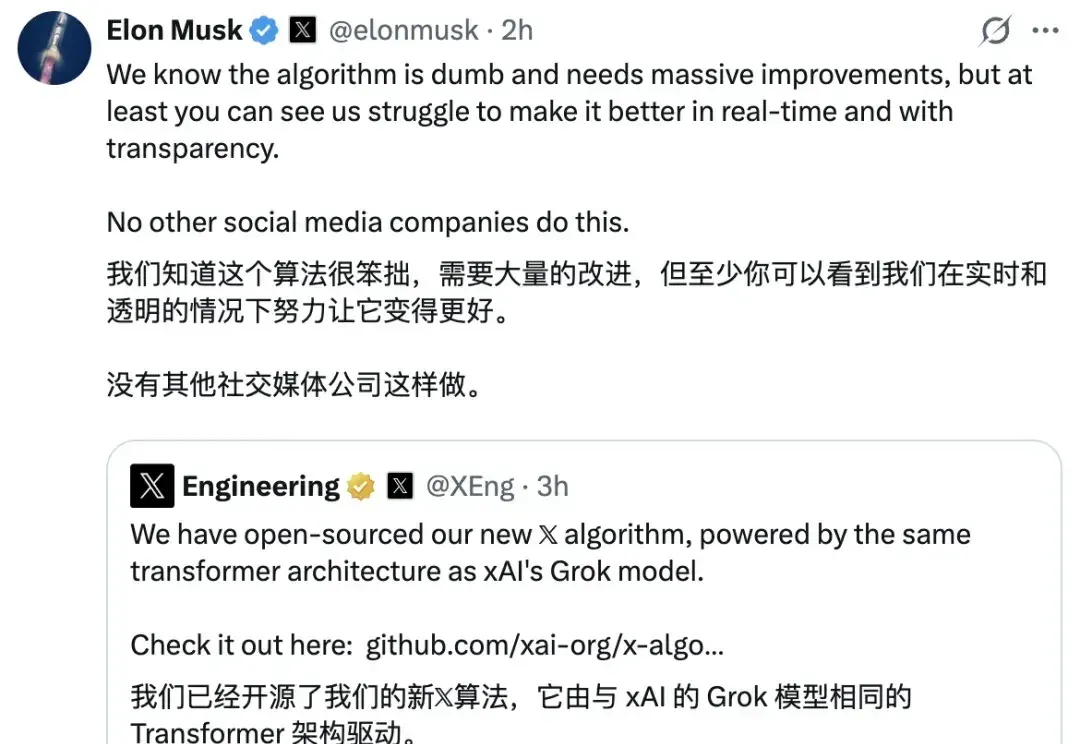
刚刚,𝕏 平台(原 Twitter 平台)公布了全新的开源消息:已将全新的推荐算法开源,该算法由与 xAI 的 Grok 模型相同的 Transformer 架构驱动。
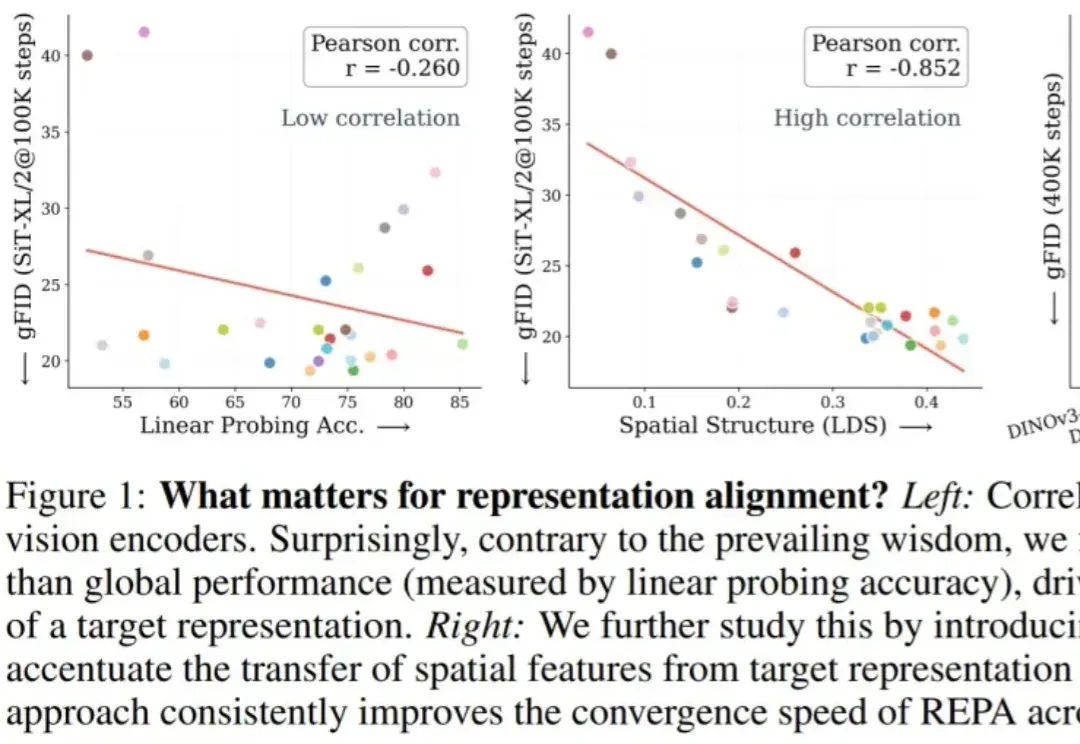
邹忌曾经有一个问题:吾与徐公孰美? 而对于 REPA,也有一个类似的问题:全局信息与空间结构,哪个对表征对齐更重要? 表征对齐(REPA)可通过将强大的预训练视觉编码器的表征蒸馏为中间扩散特征,来指导生成式训练。该方法于去年十月份问世,一直以来都备受关注,已成为加速扩散 Transformer(Diffusion Transformers)训练的一项有力技术。参阅报道《扩散模型训练方法一直错了!谢赛宁:Representation matters》。 但是,其还有一个很基本的问题悬而未决:对生成而言,目标表征的哪个方面更重要?是其「全局」语义信息(例如,以 ImageNet-1K 准确率衡量)
在AI热潮中,大模型最「渴求」的究竟是什么?是算力、是存储,还是复杂的网络互联?在Hot Chips 2025 上,Transformer发明者之一、谷歌Gemini联合负责人Noam Shazeer给出了答案。

Transformer作者Llion Jones带着自己的初创公司Sakana AI,又来搞事情了。(doge)最新推出的开源框架——ShinkaEvolve,可以让LLM在自己写代码优化自己的同时,还能同时兼顾效率,be like为进化计算装上一个“加速引擎”。
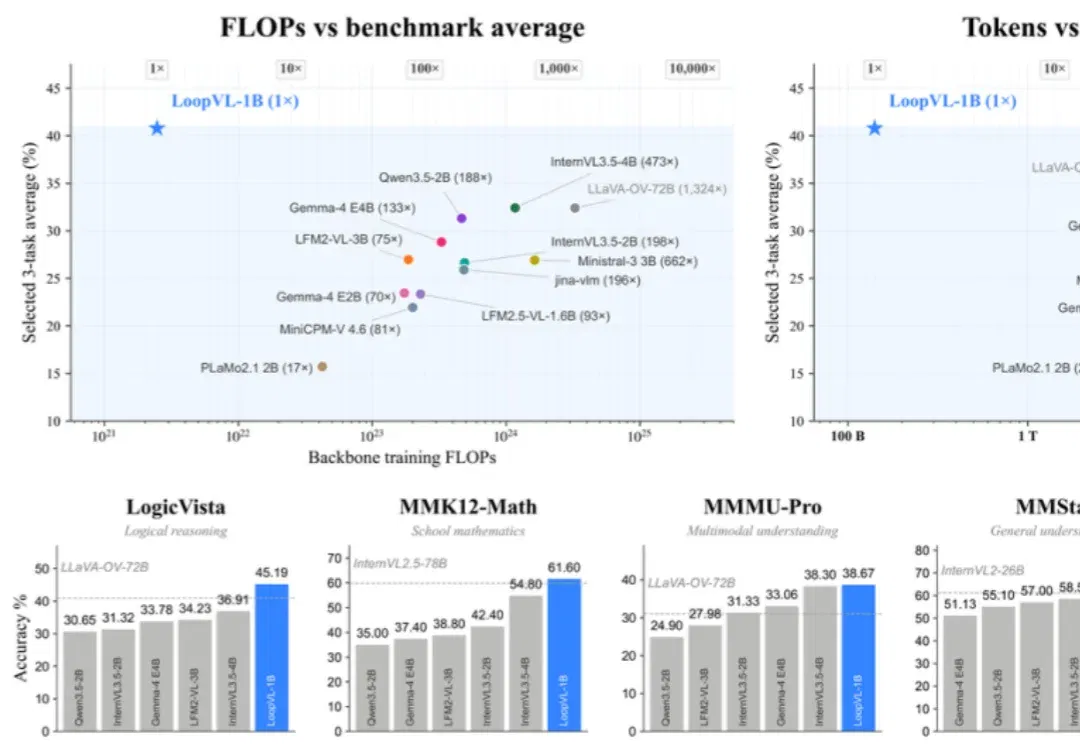
近年来,Loop Transformer 逐渐从简单的模块复用走向更复杂的分层循环计算,探索如何通过共享参数持续更新模型状态。一个自然的问题是:当模型开始看图,这套机制还成立吗?