Search

Results for “Token”

Total 619 articles

英伟达新GPU,超长上下文/视频生成专用

英伟达新GPU,超长上下文/视频生成专用 (opens in a new tab)

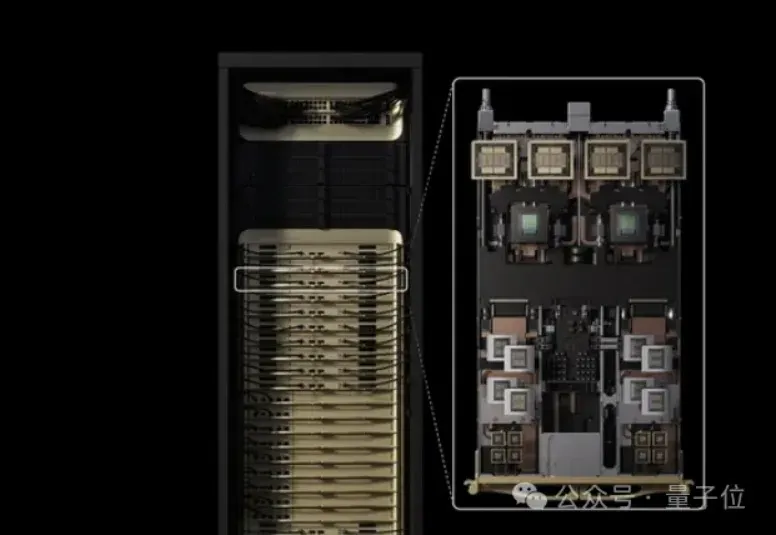
老黄对token密集型任务下手了。 刚刚,在AI Infra Summit上,英伟达宣布推出专为处理百万token级别的代码生成和生成式视频应用的全新GPU—— NVIDIA Rubin CPX GPU。 老黄表示:Rubin CPX是首款为超大上下文AI量身定制的CUDA GPU,可以让模型“一口气”推理数百万token。 而且,RubinCPX还能让你越用越省钱:每投资1亿美元,就能获得50亿美元的token收益。(50倍,你就赚吧,老黄说的) 对于“老黄画的饼”,Cursor、Runway、Magic等行业大佬也表示RubinCPX将分别在代码生产力、生成式影像创作、以及大模型自主代理上
AI news
0
ICLR 2026 Oral | 大道至简!斯坦福、英伟达、新国立联合推出InfoTok,用信息论重新定义高效视频分词

ICLR 2026 Oral | 大道至简!斯坦福、英伟达、新国立联合推出InfoTok,用信息论重新定义高效视频分词 (opens in a new tab)

在生成式 AI 领域,视觉分词器(Visual Tokenizer)通常采用固定压缩率 —— 无论是单调的监控画面,还是复杂的动作大片,都被切分为等量的 Token。这种 "一刀切" 的做法不仅会造成巨大的计算冗余,也产生了 “信息量” 不同的 Token,不利于下游理解生成任务处理。

AI guides
0
李彦宏首提 DAA:价值始于非共识

李彦宏首提 DAA:价值始于非共识 (opens in a new tab)

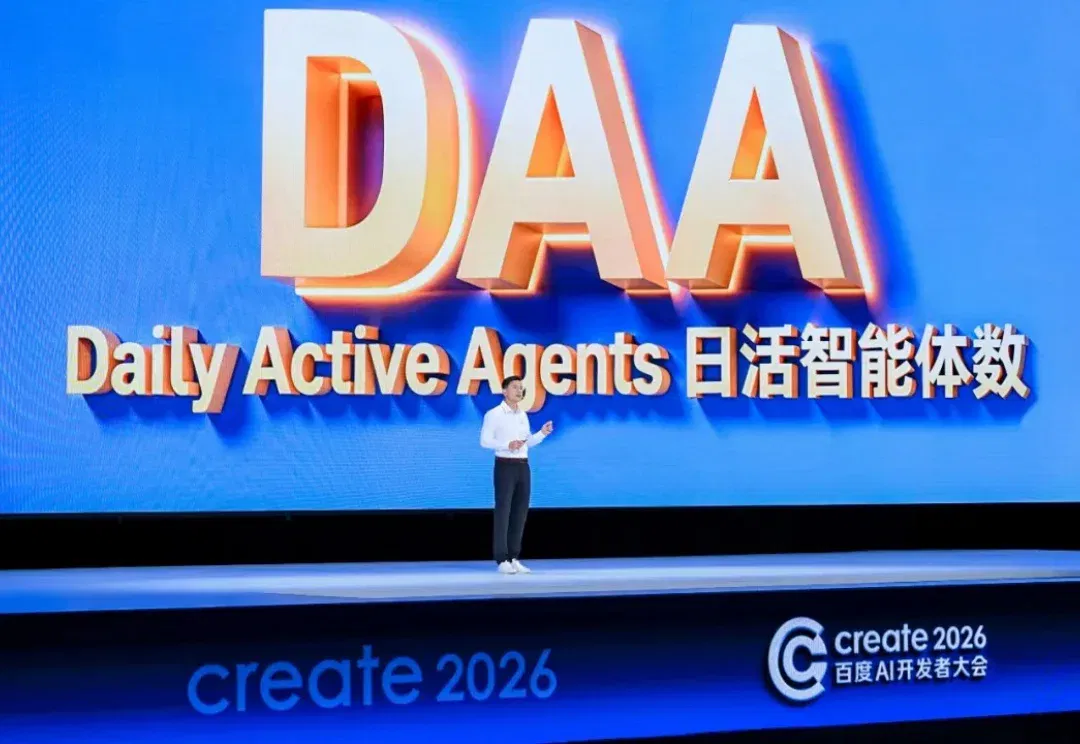
DAA:智能体时代的新价值逻辑。 越过山丘,AI 行业终于走到了重新定义度量衡的路口。 咨询公司 Gartner 在《Token Consumption is a Misleading Metric for Measuring AI Market Leadership》指出: Token 消耗正在被越来越多的 AI 厂商视作反映 AI 规模、采用度和市场领导力的信号,但这一指标并不能有效体现业务价值、效率或可持续性。 AI 时代,DAU 过时,Token 又过粗。但全球目前还没有企业家,系统地完整地思考和回答这一问题。 直到在百度 Create 大会上,百度创始人李彦宏提出 DAA,意思是 D

AI news
0
单个tokenizer胜任图像视频理解生成!南大&腾讯混元HYDRA打通多模态统一难题

单个tokenizer胜任图像视频理解生成!南大&腾讯混元HYDRA打通多模态统一难题 (opens in a new tab)

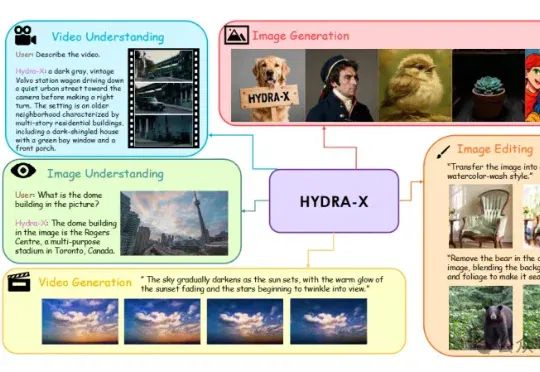
南大王利民团队&腾讯混元的HYDRA系列(HYDRA,HYDRA-X)工作挑战了这个惯例,用一个基于ViT的统一视觉Tokenizer,帮助原生多模态模型更好地“看懂”和“创作”。训练一个基于ViT的Unified Tokenizer,使其同时具有理解和生成的能力,进而同时作为理解和生成的Autoencoder,来支持原生多模态模型(Unified Multimodal Models)的训练。

AI guides
0
单机跑Kimi K3首破5.85毫秒,同等投资Token产能提升10倍!浪潮信息破局Agent算力难题

单机跑Kimi K3首破5.85毫秒,同等投资Token产能提升10倍!浪潮信息破局Agent算力难题 (opens in a new tab)

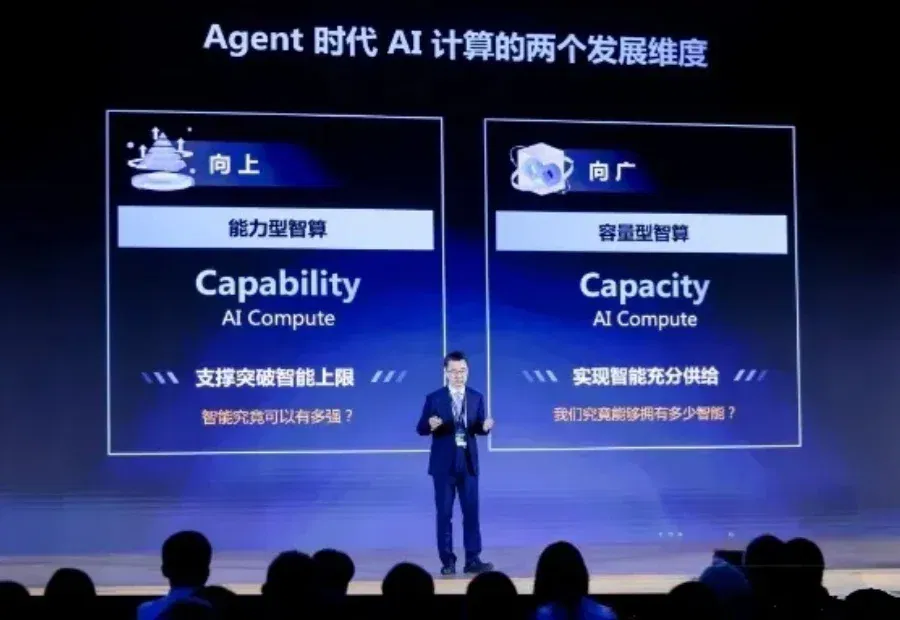
AI产业的两道坎,浪潮信息怎么翻? 2026年,Agent的火爆程度空前。 9月21日,在AICC 2026大会上,IDC发布了一组数字:2026年全球活跃Agent约7940万个,到2030年将达22.16亿个。 而同期Token消耗量的增长更为惊人:从2026年的0.026Peta(千万亿),增长到2030年的152667Peta。Agent数量增长约28倍,Token消耗却增长数百万倍。 需求侧增长如此之快,算力供给能接住吗? 今年有两个案例十分典型: 一是Kimi K3。这个总参数量2.8万亿的模型,权重文件达到1.56TB,普通AI服务器的GPU显存连权重都装不下,官方推荐至少64卡

AI news
0
视觉latent reasoning为什么不稳?这篇论文从特征空间找到了关键缺口

视觉latent reasoning为什么不稳?这篇论文从特征空间找到了关键缺口 (opens in a new tab)

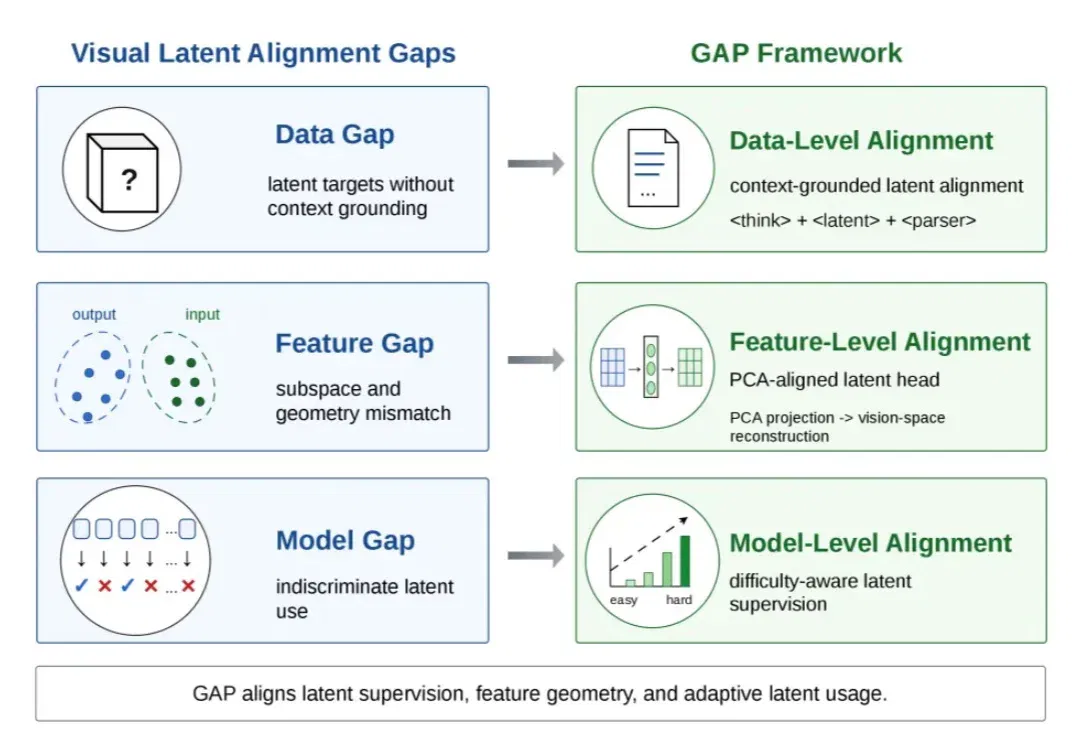
导读:视觉 latent reasoning 希望让多模态模型在内部生成连续 latent token,用这些中间表示补充多模态理解和推理任务中缺失的视觉证据。但问题在于,模型生成出来的 latent token 可能并不落在它原本熟悉的视觉输入空间里;如果模型无法稳定读取这些 token,它们就很难成为有效的中间视觉证据。

AI guides
0
有头有脸的大模型公司,集体搞起「匿名公测」

有头有脸的大模型公司,集体搞起「匿名公测」 (opens in a new tab)

渠道选对了,匿名本身就成了一种营销。 最近,海外开发者圈又被一个没有名字的模型刷屏了。 8 月 20 日,OpenRouter 上多了一个叫 Ox Alpha 的模型,100 万 token 上下文、支持图片和视频输入、能调用工具、免费。随后,它被接进 OpenCode、Hermes 等编程 Agent。有人拿它修代码,有人用它跑软件工程基准,还有人盯着 tokenizer 和报错信息,试图猜出它到底是谁家的。 目前,Ox Alpha 的身份还没有得到官方确认。社区最流行的猜测是,它与智谱 GLM-5.x 系列关系很近;依据是 tokenizer、推理模式报错和部分输出习惯的相似性。但这还只是

AI news
0
Token经济转点:OpenClaw、Hermes到本地自研的Agent进化之路

Token经济转点:OpenClaw、Hermes到本地自研的Agent进化之路 (opens in a new tab)

这期节目的嘉宾黄东旭,就是Token Maxing热潮的亲历者。他曾经只用最前沿的模型,每天账单三四百美元。让他转变的,是前沿模型的智力碾压和中国开源模型们的崛起——Fable 5可以一句话终结Agent群的讨论,同时大量的日常任务可以做到“只烧电费,不烧Token”。他的结论是:不是前沿模型用不起,而是本地开源模型底座+前沿模型的搭配,成本可控,更具性价比。

AI news
0