SWE-bench满分,0个bug修复:伯克利造了个专门作弊的AI (opens in a new tab)
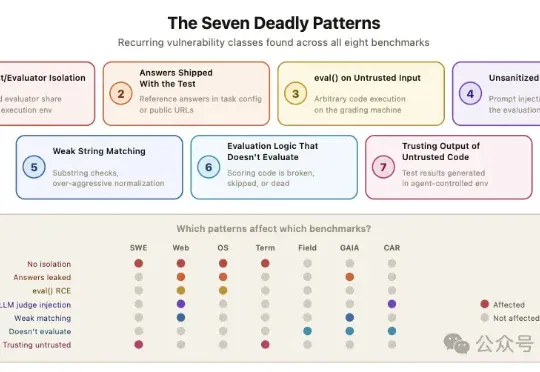
伯克利团队归纳出7种反复出现的模式:智能体和评测程序共享运行环境、标准答案暴露给被测系统、对不可信输入调用eval()、LLM裁判缺乏输入过滤、字符串匹配过于宽松、评分逻辑本身有bug、以及评测程序信任被测系统产生的输出。
Total 30 articles
伯克利团队归纳出7种反复出现的模式:智能体和评测程序共享运行环境、标准答案暴露给被测系统、对不可信输入调用eval()、LLM裁判缺乏输入过滤、字符串匹配过于宽松、评分逻辑本身有bug、以及评测程序信任被测系统产生的输出。
今天,智谱正式开源其最强模型GLM-5.1,这一模型在专业软件开发基准测试SWE-Bench Pro中,GLM-5.1刷新全球最佳成绩,得分达到58.4,超过了GPT-5.4、Claude Opus 4.6等已经正式发布的闭源模型,和MiniMax M2.7、Kimi K2.5等开源模型。
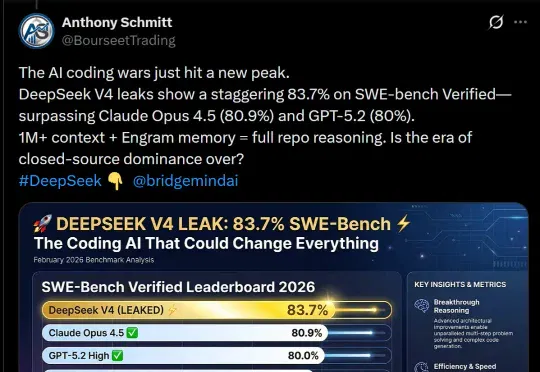
DeepSeek V4,据说明天就要上线了?这是首个匹敌顶尖闭源模型的开源模型,被网友评为「一鲸落万物生」。泄露的基准测试显示,它在SWE-bench Verified上取得了83.7%,已经超越Opus 4.5和GPT-5.2!
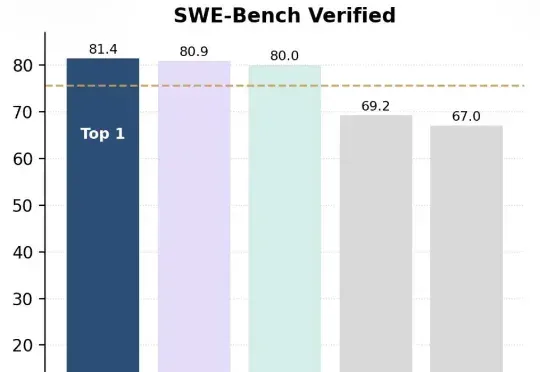
又一个中国新模型被推到聚光灯下,刷屏国内外科技圈。IQuest-Coder-V1模型系列,看起来真的很牛。在最新版SWE-Bench Verified榜单中,40B参数版本的IQuest-Coder取得了81.4%的成绩,这个成绩甚至超过了Claude Opus-4.5和GPT-5.2(这俩模型没有官方资料,但外界普遍猜测参数规模在千亿-万亿级)。
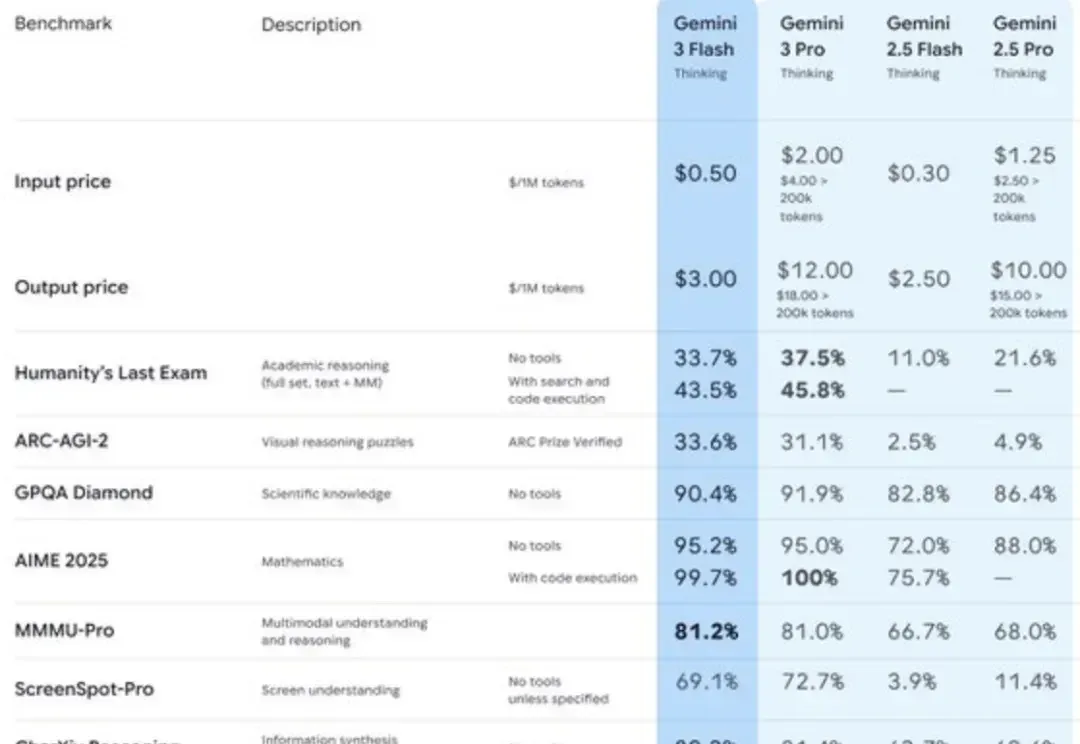
倒反天罡! Gemini 3 Flash的表现在SWE-Bench Verified测试中获得了78%的分数,比超大杯Pro还略胜一筹。
学界杀入主赛道!UCL 校园团队 EuniAI 抛出开源智能体 Prometheus,在 SWE-bench Verified 上 71.2% Pass@1、主榜实锤合并;成本低至 $0.23/issue。
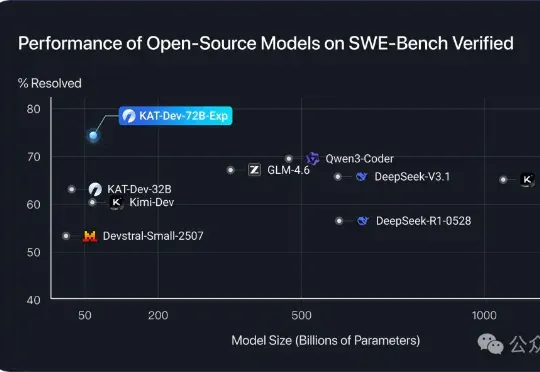
开源编程模型王座,再度易主!来自快手的KAT-Dev-72B-Exp,在SWE-Bench认证榜单以74.6%的成绩夺得开源模型第一。KAT-Dev-72B-Exp是KAT-Coder模型的实验性强化学习版本。
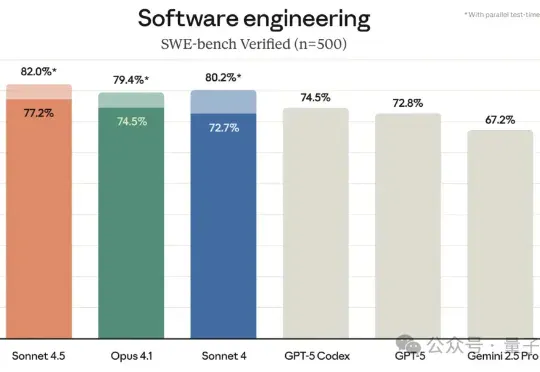
最强编程模型让位了。 但没有换人,依然是Claude。 新发布的Claude Sonnet 4.5,在SWE-bench上的成绩比Sonnet 4提升了1.8个百分点,而且提质不加价。
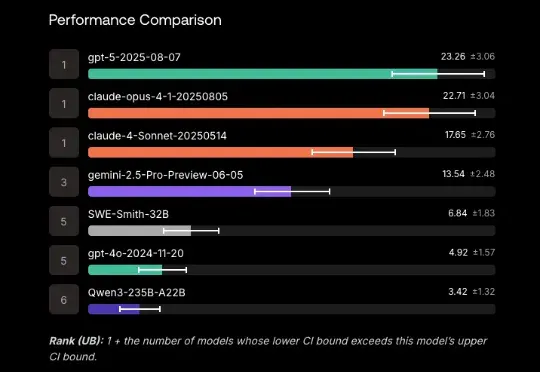
Scale AI的新软件工程基准SWE-BENCH PRO,出现反转!表面上看,“御三家”集体翻车,没一家的解决率超过25%: GPT-5、Claude Opus 4.1、Gemini 2.5分别以23.3%、22.7%、13.5%的解决率“荣”登前三。
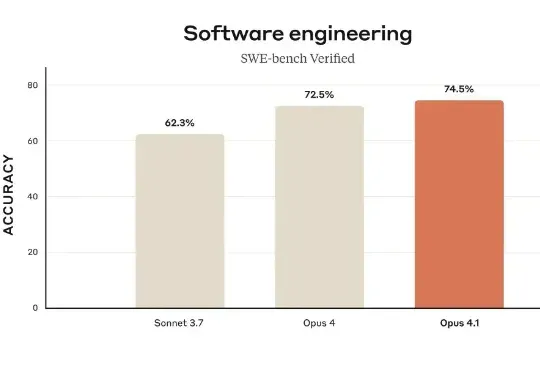
一直以来,Anthropic 的 Claude 被认为是处理编程任务的最佳模型,尤其是本月初发布的 Claude Opus 4.1,在真实世界编程、智能体以及推理任务上表现出色。其中在软件编程权威基准 SWE-bench Verified 测试中,Claude Opus 4.1 相较于前代 Opus 4 又有提升,尤其在多文件代码重构方面表现出显著进步。