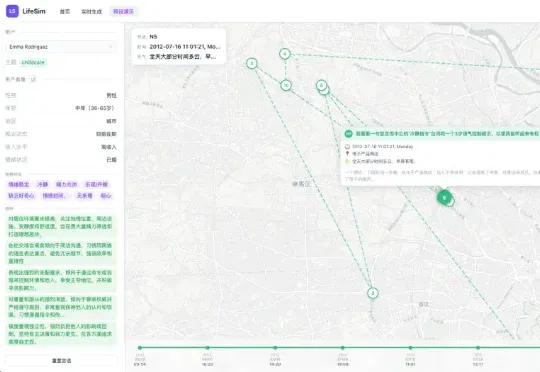
首个用户生活「长程模拟器」来了!LifeSim 重新定义大模型个性化评测 (opens in a new tab)
来自复旦大学、上海创智学院的研究人员提出 LifeSim,一个面向个性化助手评测的长程用户生活模拟框架。LifeSim 同时建模用户内部认知过程与外部物理环境,生成连贯的生活轨迹、事件序列与多轮交互行为;在此基础上,研究团队进一步构建了 LifeSim-Eval,用于系统评测模型在长期个性化交互中的能力边界。
Total 881 articles
来自复旦大学、上海创智学院的研究人员提出 LifeSim,一个面向个性化助手评测的长程用户生活模拟框架。LifeSim 同时建模用户内部认知过程与外部物理环境,生成连贯的生活轨迹、事件序列与多轮交互行为;在此基础上,研究团队进一步构建了 LifeSim-Eval,用于系统评测模型在长期个性化交互中的能力边界。
找准PMF,比创意更重要 欧洲今年AI赛道最大的融资出现了。 近日,伦敦人工智能公司Synthesia宣布完成2亿美元E轮融资,估值达40亿美元。 与多数追逐通用大模型的初创公司不同,Synthesia专注企业级AI视频生成,帮助全球组织将文本知识高效转化为多语言培训与沟通视频。 从早期被近百家风投拒绝,到如今成为欧洲AI应用层的标杆,Synthesia的路径印证了一个趋势:在AI狂热中,真正赢得市场的,不是最炫的技术,而是最深的场景扎根。 完美PMF跑出的独角兽 2026年初,欧洲AI赛道迎来一个标志性时刻:总部位于伦敦的AI视频公司Synthesia宣布完成2亿美元融资,投后估值高达40亿
Google DeepMind 已于本月初向员工宣布了 Silver 的离职消息。Silver 在离职前的几个月里一直处于休假状态,并未正式返回 DeepMind 工作岗位。Google DeepMind 的一位发言人在电子邮件声明中证实了 Silver 离职的信息,表示:「Dave 的贡献是无价的,我们非常感谢他对 Google DeepMind 工作所做出的贡献。」
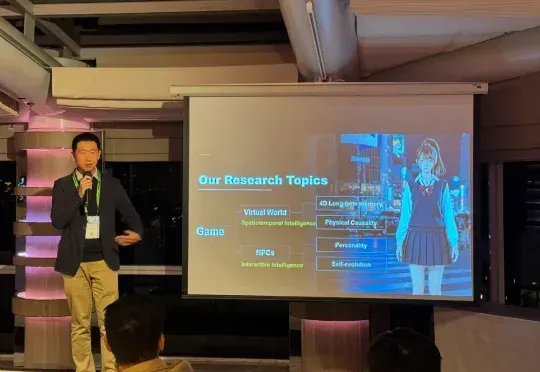
在 SIGGRAPH Asia 2025 期间,盛大 AI 东京研究院(Shanda AI Research Tokyo)以展台活动、BoF 学术讨论与顶尖教授闭门交流等形式完成首次公开亮相,标志着盛大在数字人的 “交互智能 (Interactive Intelligence)” 与世界模型的 “时空智能 (Spatiotemporal Intelligence)” 等两大方向的研究
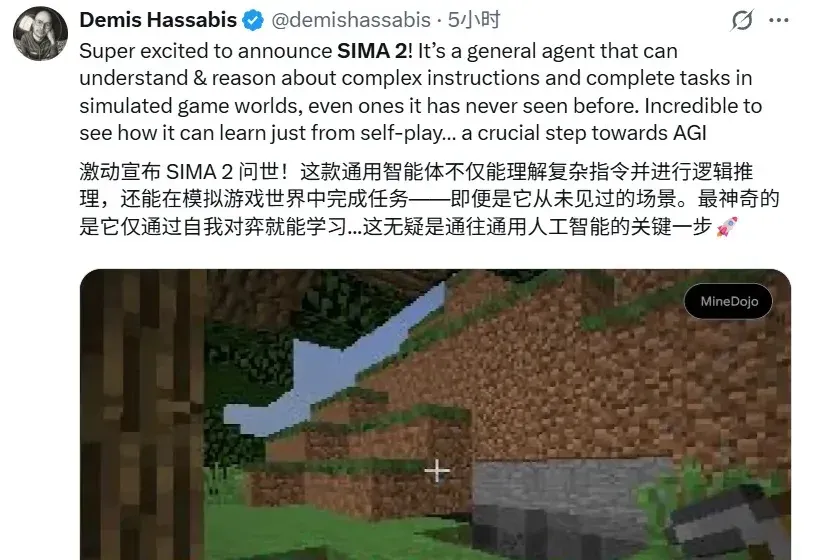
您的 AI 伙伴「游戏陪玩」版已上线。 今天,Google DeepMind 发布了 SIMA 2,一个在虚拟 3D 世界中能自主游戏、推理并持续学习的通用 AI 智能体。 DeepMind 创始人哈萨比斯将其定义为通往通用人工智能的关键一步。 去年,谷歌 DeepMind 推出了 SIMA (Scalable Instructable Multiworld Agent,可扩展、可指导的多世界智能体),这是一个能够跨越多种虚拟环境、遵循基本指令的通才 AI,标志着 AI 在 3D 世界中将语言转化为行动的初步探索。 SIMA 2 则代表了这一研究的重大飞跃,是创建通用和有益 AI 智能体研究的
十年前,我们是国际顶会的仰望者;十年后,SIGGRAPH Asia重返家门,中国已从技术跟跑者变为AI与图形融合新时代的定义者之一,这场盛会不仅是一次技术复盘,更是一次面向全球的实力宣言。
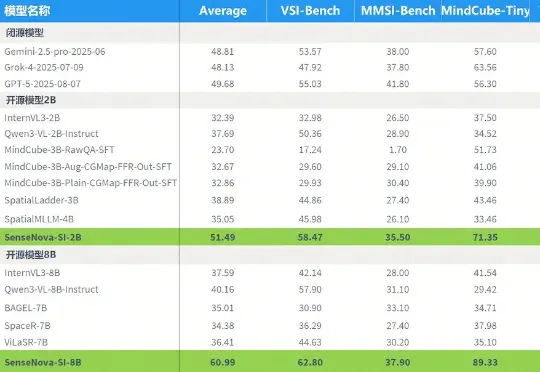
昨晚,商汤正式发布并开源SenseNova-SI系列空间智能大模型,涵盖2B与8B两个版本。该系列模型在多个空间智能基准测试中均表现突出,其中SenseNova-SI-8B模型在VSI-Bench、MMSI-Bench、MindCube-Tiny与ViewSpatial四个核心任务上获得60.99的平均成绩
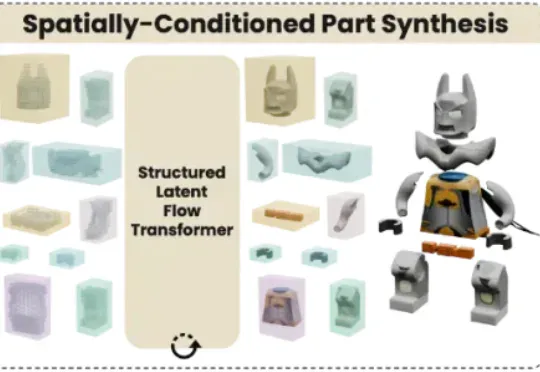
在3D内容创作领域,如何像玩乐高一样,自由生成、编辑和组合对象的各个部件,一直是一个核心挑战。香港大学、VAST、哈尔滨工业大学及浙江大学的研究者们联手,推出了一个名为 OmniPart 的全新框架,巧妙地解决了这一难题。该研究已被计算机图形学顶会 SIGGRAPH Asia 2025 接收。
在AI以指数级加速迈向ASI的2025年,新智元迎来十周年历史时刻,将于9月7日在北京中关村软件园举办盛大峰会。大会以「新天终启,万象智生」为主题,汇聚百度王海峰、英伟达赖俊杰、百川智能王小川、昆仑万维方汉、未来智能胡郁等多位重量级嘉宾,共同探讨芯片、大模型、Agent、具身智能及医疗智能等全球ASI最前沿突破,展望ASI重塑人类社会的恢弘篇章。
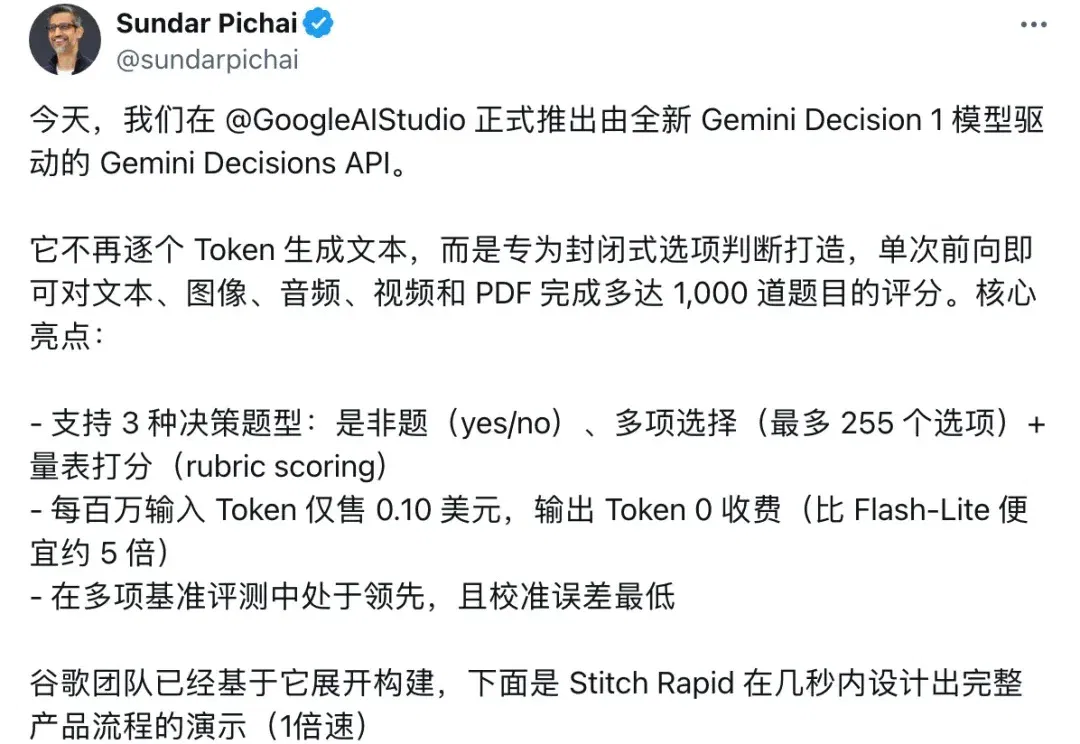
MachinePulse releases 0.8B–31B decision models that score options in one forward pass. The 31B model ties first at 73.9 in the November 12 Decision Index 0.4.1 snapshot. Latency and costs depend on test configuration; single decisions differ from full workflows.