刚刚,全球首个超高帧世界模型MoWorld诞生!英伟达含量0,狂飙50帧 (opens in a new tab)
专注于4D世界模型研发和产业化的魔芯科技联合浙江大学潘云鹤院士团队发布MoWorld——全球首个Flash World Model,也是首个全栈基于国产NPU构建的实时交互世界模型。
Total 362 articles
专注于4D世界模型研发和产业化的魔芯科技联合浙江大学潘云鹤院士团队发布MoWorld——全球首个Flash World Model,也是首个全栈基于国产NPU构建的实时交互世界模型。
走在风口浪尖,拥抱最新的技术。 “世界模型”并不是新概念。但在2026 年,具身智能的“泛化瓶颈”,直接把“世界模型”推向了风口。 大洋彼岸,李飞飞的 World Labs 估值突破 50 亿美元,杨立昆的 AMI Labs 获超 10 亿美元种子轮融资,迅速推高了“世界模型”赛道的热度。资本加速涌来。世界模型及相关赛道国内已有超 33 家企业完成融资,累计吸金超 260 亿人民币。 与此同时,巨头们也在提速。阿里的 Qwen-RobotWorld、腾讯的 HY-World、字节的 Seed3D 迅速更迭;华为虽不常公开提及"世界模型",却已将盘古大模型定位为具身与自动驾驶的"训练底座"。 大
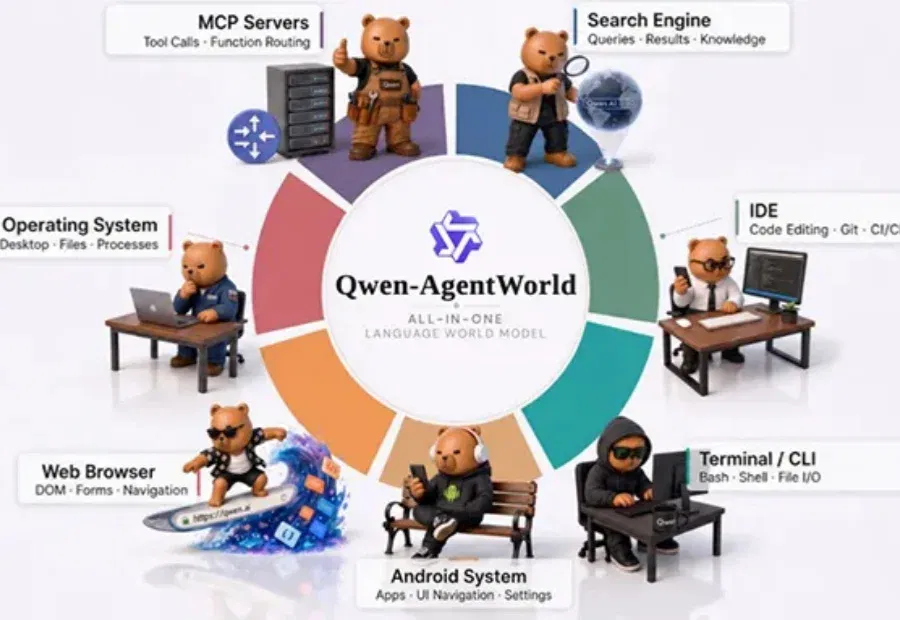
一个模型能模拟7种环境。 智东西6月24日消息,刚刚,阿里千问大模型上新,发布首个原生语言世界模型(LWM)Qwen-AgentWorld,该模型有35B-A3B与397B-A17B两种参数规模。 该模型专门为各类AI智能体研发与训练而生。在博客中,研究人员提到,该语言世界模型的核心目的不是降成本、替代智能体的真实交互环境,而是为了增强通用智能体的能力。其可以让智能体在做动作前,先在内部模拟环境反馈再决策。 Qwen-AgentWorld两大核心亮点为: 从预训练阶段就将环境建模作为训练目标,贯穿CPT→SFT→RL全流程。此前完整训练通用基础大模型,往往会在训练结束后,才开始教AI理解环境、
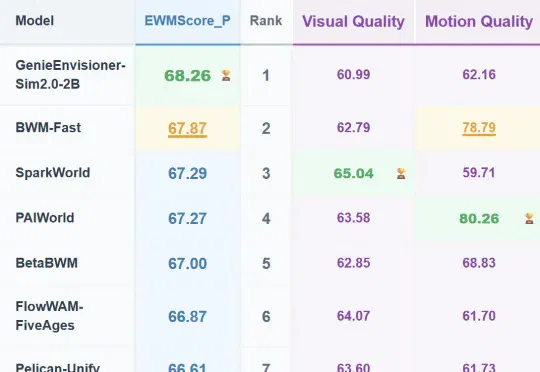
WorldArena 世界模型赛道从来都是竞争异常激烈,在经历了前几次比赛过程中的放榜之后,CVPR 2026 WorldArena 世界模型赛道锁定总成绩,智元自研的世界模型 Genie Envisioner-Sim 2.0(以下简称 GE 2.0)拿下了最终的冠军,成为了 “强者中的强者”。
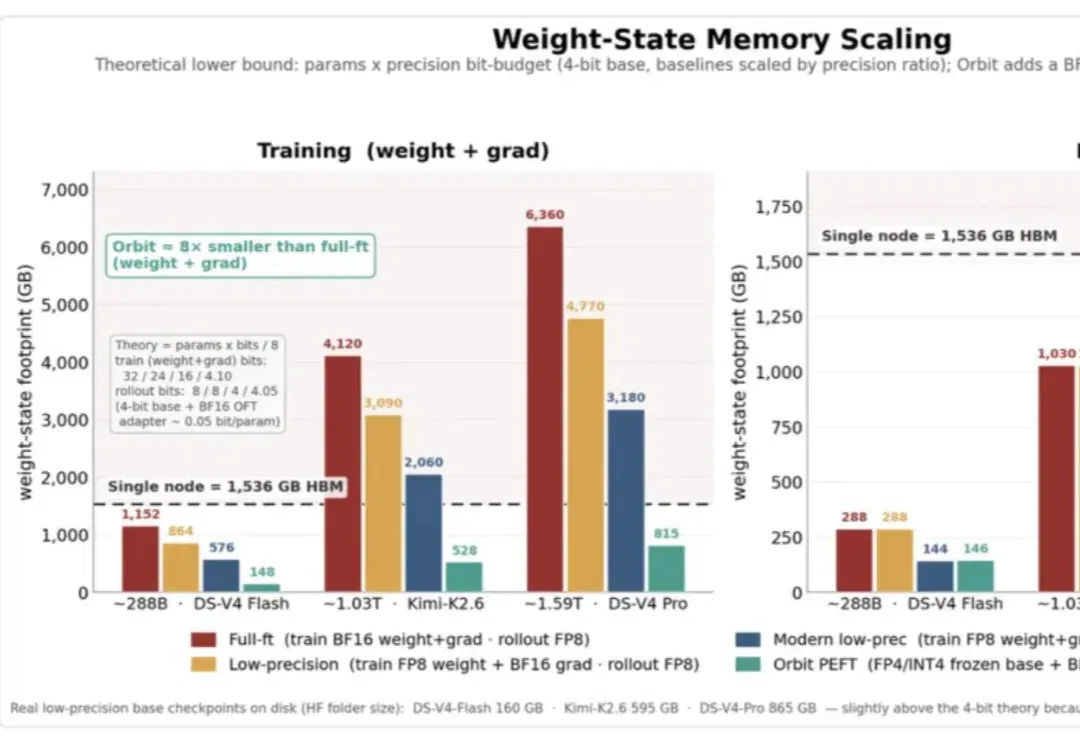
从数学、代码、复杂推理,到多轮工具调用,大模型的很多能力的提升都离不开 RL 后训练。但当模型规模进入 MoE 万亿参数级别之后,RL 不再只是一个算法问题,同时更加是一个系统问题。
小红书AI平台团队刚刚开源了Relax——一个为全模态数据、Agentic工作流和大规模异步训练协同设计的现代RL训练引擎!实测全异步Off-Policy模式相比共卡On-Policy吞吐提升76%,相比veRL的全异步实现提升20%!
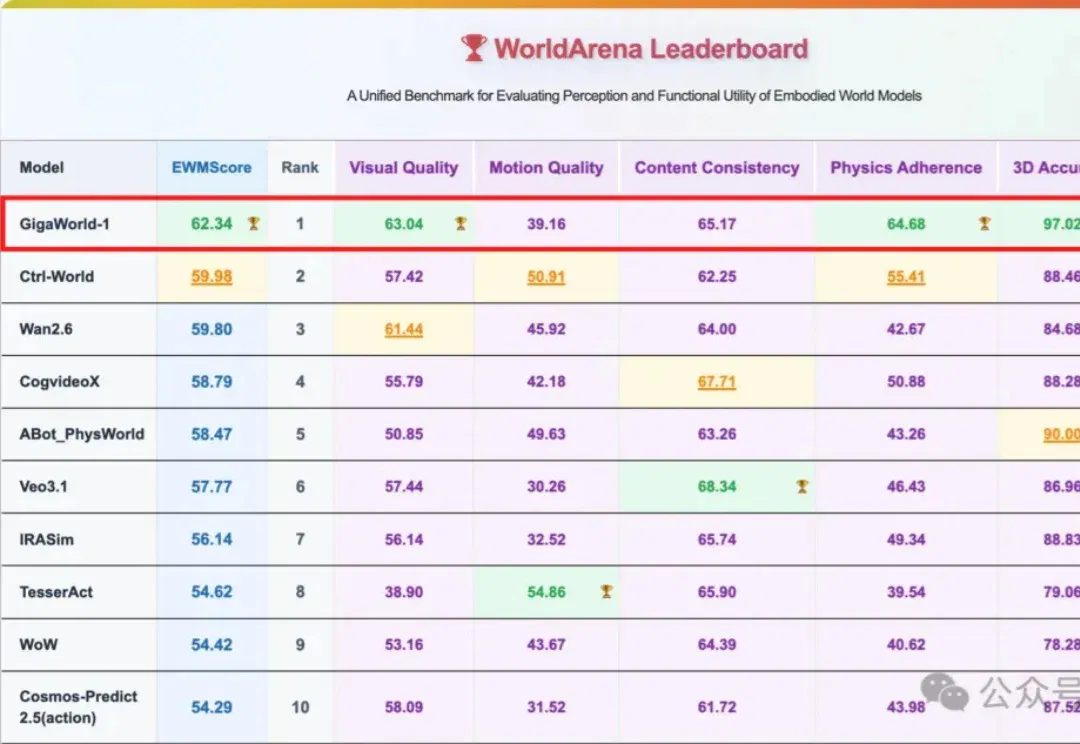
还得是咱国产世界模型牛! 极佳视界最新力作GigaWorld-1,直接击穿谷歌英伟达,WorldArena登顶全球第一。 而且还是唯一一个综合得分突破60分大关的具身世界模型。 什么概念呢?就以三大核心维度为例,几乎是断层式领先: Physics Adherence(物理遵循):相比第二名提升了整整16%。3D Accuracy(3D准确度):近乎逼近满分。Visual Quality(视觉质量):同样遥遥领先。 也就是说,GigaWorld-1是真正的全能型具身世界模型,不仅视觉真实,而且几何精准、物理准确。 这意味着,极佳视界这家由清华系领衔,汇聚了阿里、百度、地平线等一众顶尖大厂核心骨干
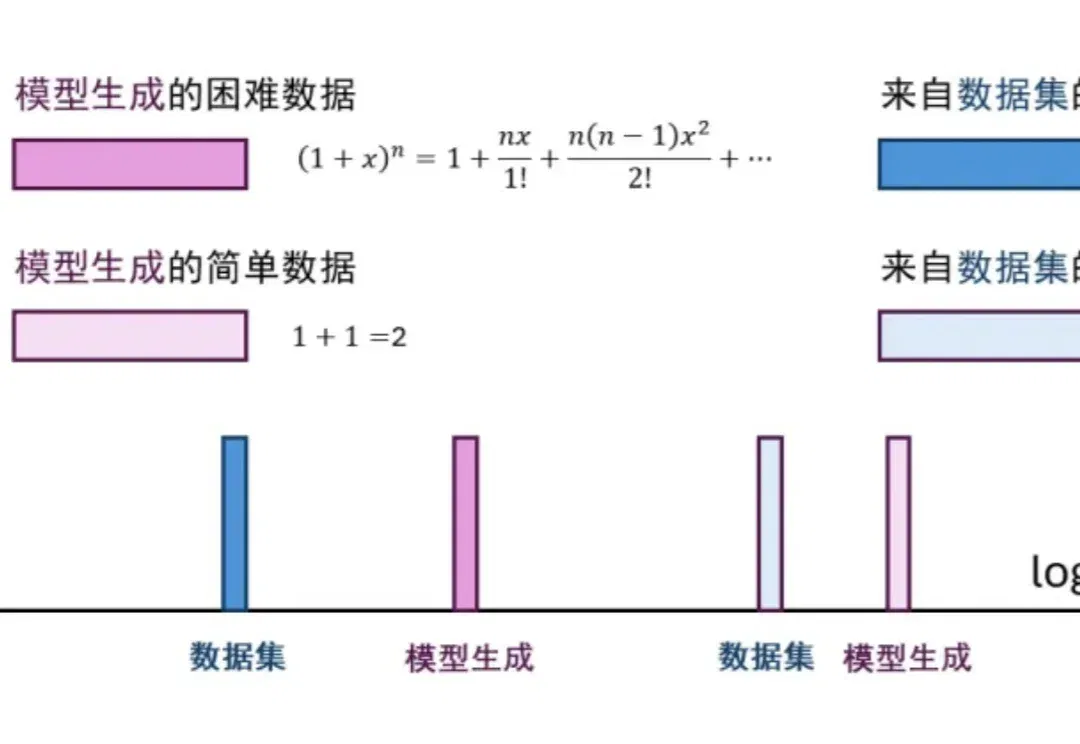
在大模型后训练阶段,监督微调(SFT)和强化学习(RL)是两根不可或缺的支柱。SFT 利用高质量的离线(Off-policy)数据快速注入知识,但受限于静态数据分布,泛化能力往往容易触及天花板并带来灾难性遗忘;RL 则允许模型在探索中不断自我迭代,产生与当前策略同分布(On-policy)的数据,上限极高,但往往伴随着训练极度不稳定、计算资源消耗巨大的痛点。
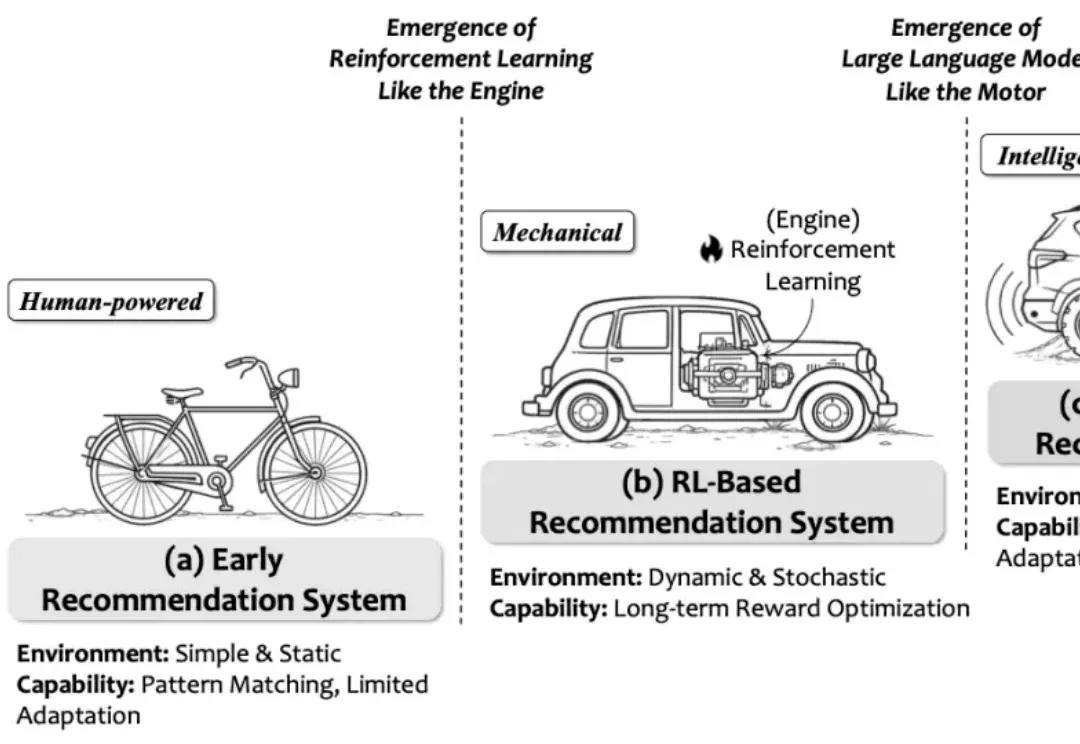
强化学习(RL)将推荐系统建模为序列决策过程,支持长期效益和非连续指标的优化,是推荐系统领域的主流建模范式之一。然而,传统 RL 推荐系统受困于状态建模难、动作空间大、奖励设计复杂、反馈稀疏延迟及模拟环境失真等瓶颈。
随着 MiniMax M2.5 的发布并在社区引发热烈反响,很高兴能借此机会,分享在模型训练背后关于 Agent RL 系统的一些思考。 在大规模、复杂的真实世界场景中跑 RL 时,始终面临一个核心难