
揭开多智能体决策的隐形不公,结果指标相同也未必可靠 | EMNLP'26 (opens in a new tab)
当多个大语言模型(LLM)组成「招聘委员会」,共同筛选简历、讨论候选人、打分并投票时,我们通常会用最终录用率来判断系统是否公平。
Total 41 articles
当多个大语言模型(LLM)组成「招聘委员会」,共同筛选简历、讨论候选人、打分并投票时,我们通常会用最终录用率来判断系统是否公平。

大模型在直播场景模拟用户行为,理解真实的社交动态和风险演化,是当前一个非常热门的研究话题。
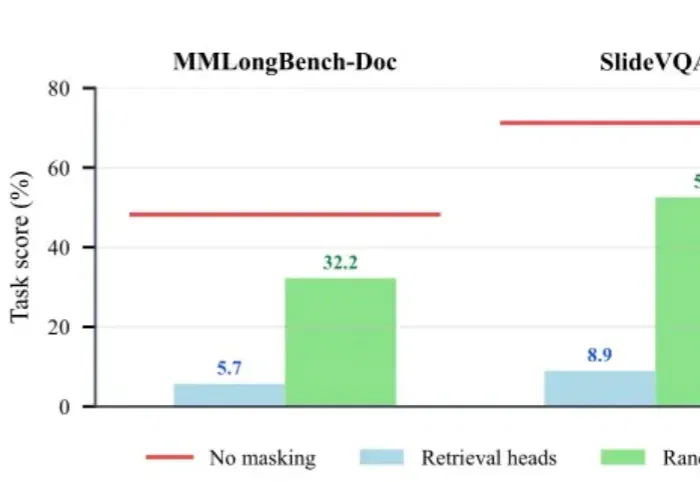
随着Office AI和文档智能体的发展,大模型开始直接处理财报、合同、研究报告等长篇图文材料。
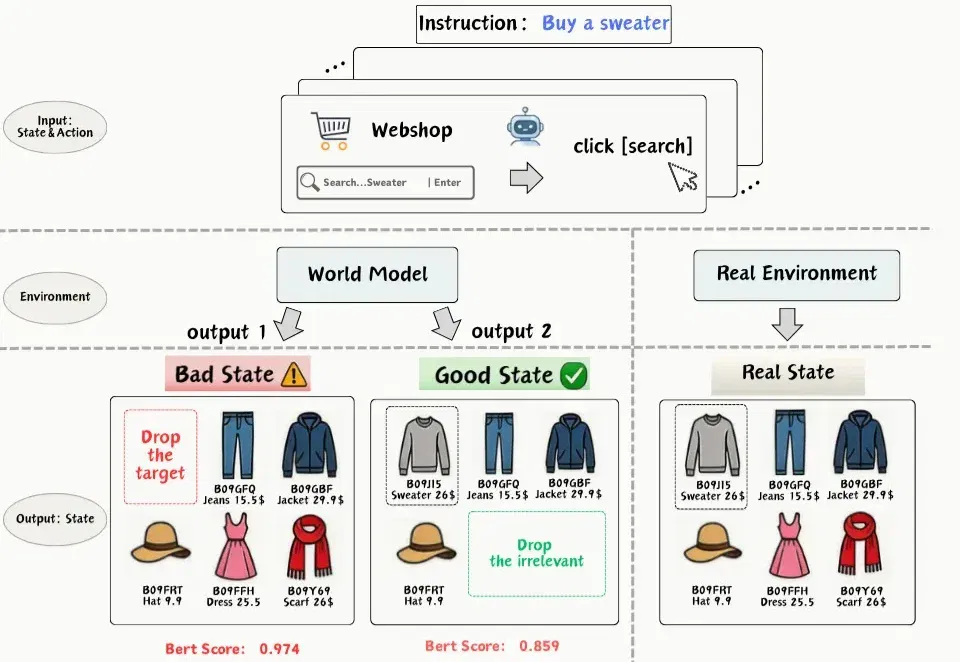
一句话概括:文本世界模型都在比 "生成文本像不像真实环境",但我们发现文本更接近真实环境的预测反而可能让智能体错得更离谱。把训练目标从 "状态一致" 换成 "行为一致" 后,16 组实验配置下世界模型的轨迹级一致性几乎全面提升,弱智能体离线评测的假阳性率从 42.5% 降到 9.5%。
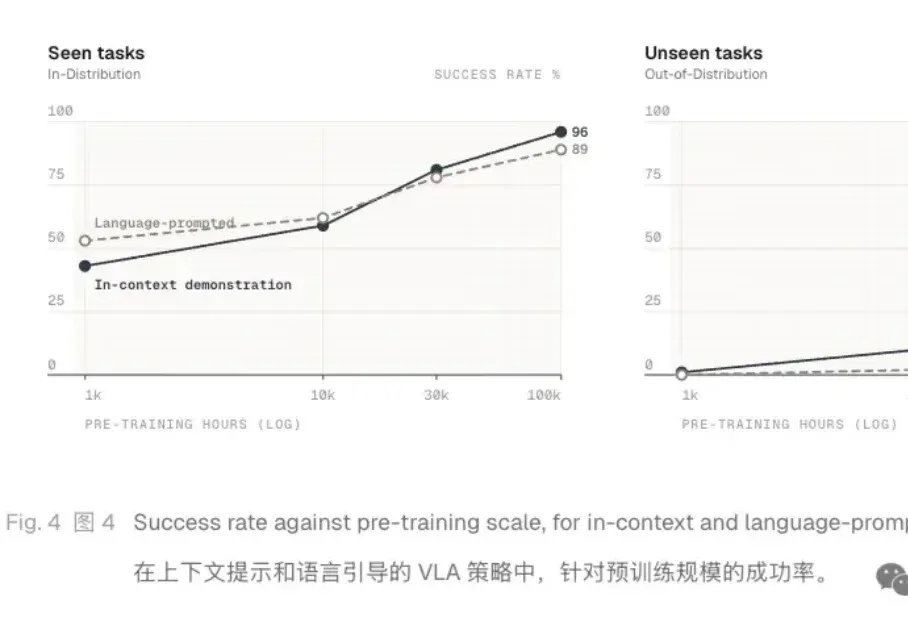
2020年,GPT-3靠“看几个示例就会新任务”震动了NLP界;六年后的今天,同样的故事正在具身智能领域上演。
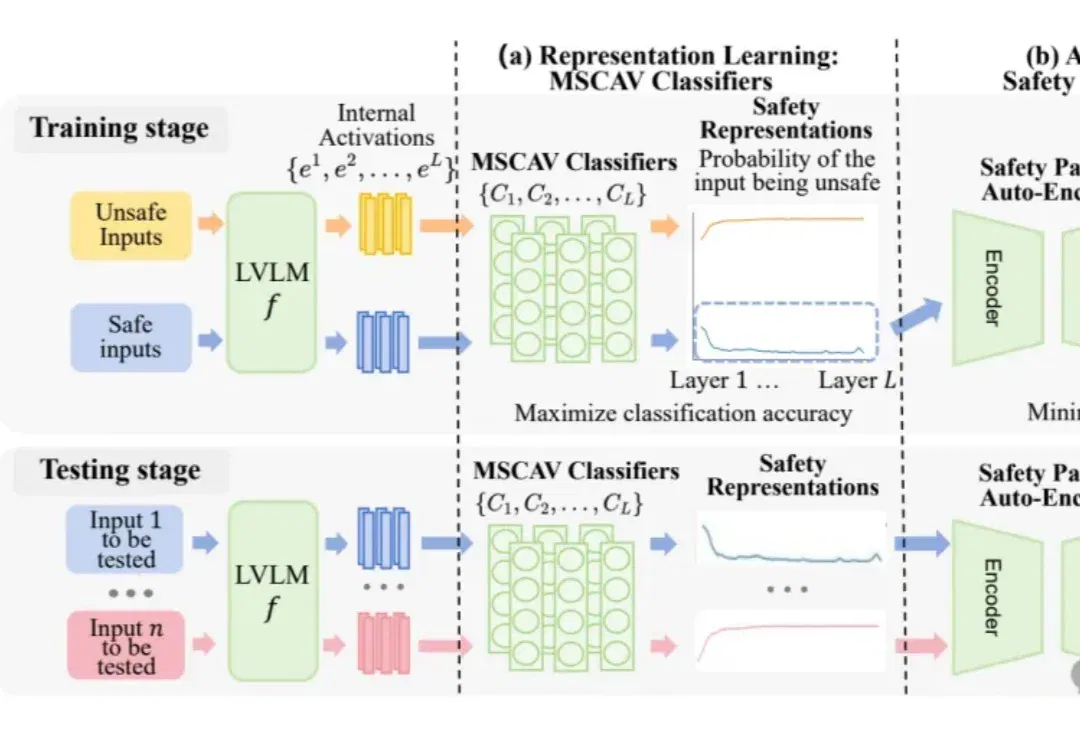
大视觉语言模型(LVLM)把语言理解扩展到了图像等多模态输入,同时,也带来了更隐蔽的攻击面。
为了解决当前AI Agent存在的这些问题,面壁智能联合东北大学-面壁智能数据智能联合实验室、清华大学THUNLP实验室、OpenBMB与AI9Stars,正式开源了数字员工全流程构建与管理平台——StaffDeck。
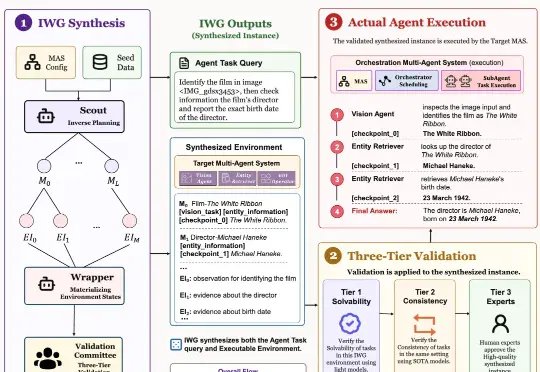
来自南京大学 NLP 实验室的 ICML 2026 论文 Recognize Your Orchestrator: An Entropy Dynamics Perspective for LLM Multi-Agent Systems 指出:在当前主流的 Orchestrator-Executor 多智能体架构中,系统失败往往并不首先来自某个执行器不会干活,
今天,华盛顿大学即将毕业的博士生 Alisa Liu 要加入 OpenAI 的消息上了 X 热搜。主贴浏览量已突破百万,她表示这次找工作的过程比想象中更有挑战,但也收获满满。所以她写了一篇小博客,分享一路走来学到的经验,也希望能让下一个经历这个过程的人少一点困惑。
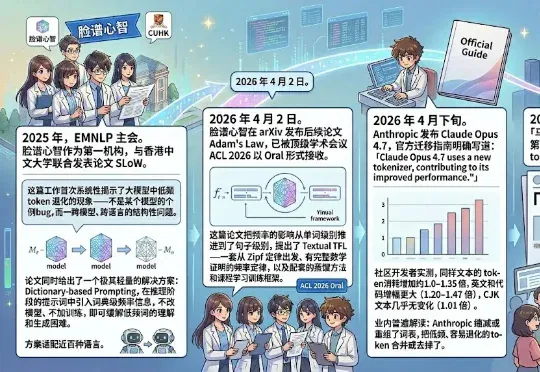
一家名为脸谱心智(FaceMind)的初创公司就在顶级学术会议 EMNLP 主会上系统性地揭示了这个问题,并给出了解法。更有意思的是,就在「马嘉祺」事件前不到两周,全球最强 AI 公司之一 Anthropic 也在自家产品中悄悄落地了一次高度相关的改造 —— 方向与脸谱心智一年前的论文几乎完全一致。